Claude Code完全入门指南:安装配置到高阶用法

什么是 Claude Code,为什么值得学
Claude Code 是一款运行在终端中的 AI 智能体。与 Trae、腾讯 CodeBuddy 等图形化 AI 编程工具相比,它以命令行为核心,能力更为通用和底层。教程作者形象地称它为「智能体的老祖宗」——掌握了 Claude Code 的使用逻辑,其他同类工具便能触类旁通。
命令行界面(CLI)赋予 Claude Code 直接操作文件系统、调用系统命令、管理进程的底层能力,这是大多数图形化工具受沙箱限制而难以实现的。从技术架构看,Claude Code 本质上是一个 ReAct(Reasoning + Acting)模式的智能体——这一范式由谷歌和普林斯顿大学研究人员于2022年在论文《ReAct: Synergizing Reasoning and Acting in Language Models》中正式提出,其核心创新在于将链式思维推理(Chain-of-Thought)与外部工具调用交织在一起:智能体不仅生成文本,还能感知环境状态、规划行动序列、调用工具执行,再根据工具返回的真实环境反馈动态调整后续推理,形成「思考→行动→观察」的闭合迭代循环。
值得深入理解的是,ReAct 之所以相比传统单次推理能大幅提升复杂任务成功率,在于它从根本上改变了错误传播方式。传统 LLM 的一次性推理一旦在中间步骤出错,后续所有结论都会在错误基础上累积偏差;而 ReAct 的每一次「观察」都是对真实环境状态的重新锚定——模型从工具返回的实际结果(而非自身幻想)出发进行下一步推理,相当于在每个决策节点都引入了外部事实校验。这种设计也让整个执行过程更具可解释性,用户可以逐步审查「思考→行动→观察」链条中的每个节点,定位问题所在。
它的能力边界远不止写代码。从批量创建文件、生成工作日报,到搭建完整的网页项目,只要你能清晰描述需求,它就能拆解并执行。换句话说,它有潜力替代桌面上一部分日常办公软件。


Claude Code 安装与快速启动
安装 Claude Code 非常简单。根据自己的操作系统(Windows、macOS、Linux)选择对应的安装命令,复制到终端执行即可。以 Windows 为例,打开 CMD 终端,粘贴命令后回车等待安装完成。
安装成功后,通过 claude --version 查看版本号来验证。启动也极为灵活——只需在任意目录的终端中输入 claude 回车,它就会在当前目录下启动并接管这个工作空间。
例如新建一个空文件夹后打开终端启动 Claude Code,直接输入「帮我在当前目录下创建 1 到 100 共一百个 txt 文件」,它便会请求权限并自动完成。这种「口喷需求」的交互方式,是 Claude Code 最直观的魅力所在。
CC Switch:国内用户接入国产模型的桥梁
Claude Code 默认调用海外账号背后的大模型,对国内用户并不友好。CC Switch 正是为此而生的桥接工具,它让 Claude Code 能便捷对接国内众多国产大模型。
有了 CC Switch,你可以根据不同厂商的特点自由选择接入——今天觉得智谱的模型好用就用它,明天想试试 Kimi 也能一键切换,无需手动修改繁琐的配置文件。
CC Switch 配置流程
从官网下载对应系统的安装包,打开后在左侧选择 Claude Code,点击右上角加号即可添加模型。以 DeepSeek广告 为例,CC Switch 已内置默认配置项,你只需填写 API Key。Key 可在对应厂商官网(如 DeepSeek 的 API keys 页面)创建获取,复制粘贴回 CC Switch 后点击添加,最后启用即可。
你可能没注意到,同一模型下往往有多个「角色」——正常版、超强版、轻量级版。以小米 Memo 为例,Memo 2.5 是多模态版本可识别图片视频,2.5 Pro 则适合更复杂的任务。在终端内通过 /model 命令即可上下键快速切换。
集成 VS Code:告别纯终端操作
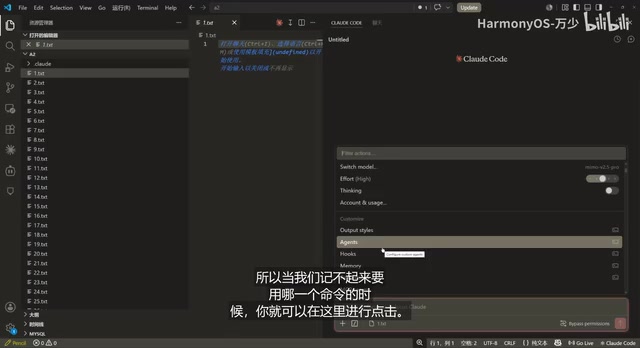
习惯可视化开发的用户,可以在 VS Code 中集成 Claude Code。在扩展市场搜索 Claude Code for VS Code 安装即可。
安装后打开工程文件,右上角会出现 Claude Code 图标。点击进入后是熟悉的对话框,底部菜单提供了添加外部资源(加号)、斜杠命令、以及用 @ 符号引用目录文件等功能。例如选中 1.txt 后输入「帮我随便写一个工作日报 100 字」,它便会直接在文件中生成内容。
权限模式:解决频繁授权的烦恼
使用过程中最恼人的莫过于 Claude Code 频繁停下来请求授权。它内置了一套权限管理模式,通过 Shift + Tab 可循环切换:
- Bypass Permissions:给予所有权限,不再询问,最便捷但也最需谨慎,适合熟悉的环境
- Auto Mode:自动模式,遇到疑问自动执行或拒绝
- Accept Edits:默认模式,常规操作自动执行,敏感操作才询问
- Plan Mode:计划模式,让 Claude Code「先思考再动手」,适合复杂任务先制定方案再执行
如果想启动时直接进入最大权限,可使用 claude --dangerously-skip-permissions。由于命令过长,建议自行封装快捷别名(如 ccd)来简化操作。
核心概念:CLAUDE.md、Rules 与 Skill
这三个概念构成了 Claude Code 项目管理的知识体系,理解它们是进阶使用的关键。
CLAUDE.md:项目的永久记忆
理解 CLAUDE.md 的必要性,需要先了解大语言模型的「上下文窗口」机制。Token 是大语言模型处理文本的基本单位,通常一个英文单词对应 1-2 个 Token,中文汉字约 1-2 个 Token。每个 AI 模型都有最大上下文长度限制(如 Claude 3.5 系列支持 200K Token,约等于 15 万字),所有对话历史、文件内容、系统提示都会纳入计算。当输入超出窗口限制时,模型并非智能地选择性遗忘,而是直接截断最早的内容,导致前期建立的项目背景和约束条件丢失。
此外,上下文窗口还涉及一个容易被忽视的「Token 经济学」问题:注意力机制的计算复杂度随上下文长度呈平方级增长,上下文越长 API 调用费用越高、响应也越慢。更关键的是,主流 AI 服务商通常按输入和输出的 Token 总量计费——这意味着每次对话携带的冗余背景信息都在直接消耗预算。在一个长期运行的工程项目中,若每次会话都将完整历史记录重新注入模型,累积的无效 Token 开销可能远超实际任务本身。这一经济压力使得「精简上下文、外置长期记忆」不仅是工程最佳实践,更是降本增效的现实需要。
CLAUDE.md 本质上是一种外部记忆机制:将稳定的项目背景信息固化到文件中,每次会话启动时按需加载,既避免了反复重申背景知识的低效,也防止上下文被冗余信息挤占,类似于 RAG(检索增强生成)系统中将长期记忆从工作记忆中剥离、按需检索的设计思路。RAG 的核心洞察在于:与其将所有背景知识塞入有限的上下文窗口,不如建立外部知识库,在需要时精准检索相关片段注入——CLAUDE.md 正是这一思路在项目记忆层面的轻量级实现。
执行 /init 初始化时,Claude Code 会通读工程并生成 CLAUDE.md 文件,作为项目的核心说明。它适合存放大方向、稳定的信息(如「这是一个 Web 项目」),而非琐碎细节——文件过大会占用宝贵的上下文容量。
CLAUDE.md 有多个层级:全局文件(如设置「每次对话都用中文」)、项目根目录文件(团队共享)、以及 CLAUDE.local.md(个人偏好,不参与团队共享)。当上下文过满导致「失忆」时,可用 /clear 清空对话记录,而 CLAUDE.md 中的永久记忆依然保留。
Rules:细致的规则约束
与 CLAUDE.md 的宏观定位不同,Rules 存放细致的编码规范,如函数命名规则、注释写法、组件约束等。它们通常放在工程目录下的 .claude/rules/ 文件夹中,以 .md 后缀存在。
Rules 与 CLAUDE.md 的分层设计体现了「关注点分离」原则:CLAUDE.md 回答「这个项目是什么、目标是什么」,Rules 则回答「在这个项目中应该怎么做、遵循哪些约束」。这种分离使得团队可以灵活维护两类信息——项目目标相对稳定,而编码规范可能随技术栈演进频繁调整,单独管理降低了维护成本,也使代码审查中的规范执行更具可追溯性。
Skill:可复用的能力封装
Skill 是丰富 AI 终端能力的重要机制,官方将其描述为「给 Claude Code 安装一份处理某类任务的说明书」。当某个任务步骤繁多且需要反复执行时,与其每次复制粘贴长提示词,不如将其提炼成一个 Skill。
Skill 不会在每次新对话时全部加载,而是由 Claude Code 根据提示词或关键字智能触发,因此理论上可以安装无数个。更妙的是 find-a-skill——这是一个「用来找技能的技能」,它会从技能社区网站中检索他人上传的优质 Skill。例如搜索「写微信公众号文章的 Skill」,就能直接复用宝玉等作者封装好的成熟经验。
Skill 的设计理念与软件工程中的「函数封装」高度一致:将重复性、有明确输入输出的操作抽象为可命名、可复用的单元。与硬编码的函数不同,Skill 以自然语言描述为载体,这意味着它能随模型能力升级而自动「进化」——同一份 Skill 说明书,在更强的基础模型上往往能取得更好的执行效果,无需修改 Skill 本身。这一特性在软件工程史上几乎是全新的:传统函数库需要人工重写才能适应新环境,而 Skill 的「升级」是由底层模型能力提升自动完成的,本质上是把执行智能从代码逻辑转移到了模型权重中。
创建自己的 Skill 也无需手写代码,直接告诉 AI「帮我创建一个名叫 XX 的 Skill,它要做什么事」即可。Skill 同样分全局级和项目级两种类型。
MCP 与自定义 Command
MCP(Model Context Protocol,模型上下文协议) 是 Claude Code 连接外部世界的「万能插头」,也是 Anthropic 于 2024 年底推出的开放标准协议。在 MCP 出现之前,每个 AI 工具若要接入数据库、API 或第三方服务,都需要开发者编写专属适配层,维护成本极高——这一困境本质上是 AI 工具集成领域的「N×M 问题」:若有 N 个 AI 客户端(Claude、GPT、Gemini 等)和 M 个外部服务(GitHub、数据库、浏览器等),传统做法需要为每对组合单独开发适配器,总工作量达到 N×M 的规模。MCP 通过引入统一协议将这一复杂度降低为 N+M——每个客户端只需实现一次 MCP 标准,每个服务只需发布一个 MCP Server,便可实现任意客户端与任意服务的自由组合,这与 USB 接口统一了硬件连接标准、LSP 协议统一了编辑器语言支持方式的影响如出一辙。
MCP 借鉴了 LSP(Language Server Protocol) 的成功经验——正是 LSP 让 VS Code 能够支持数十种编程语言的智能提示,而无需为每种语言单独开发编辑器插件。LSP 于2016年由微软随 VS Code 一同发布,此后被 Neovim、Emacs 等几乎所有主流编辑器采纳,成为编辑器智能化的基础设施。MCP 野心更大:它试图在 AI 工具与外部世界之间扮演同样的角色。在技术层面,MCP 采用 JSON-RPC 2.0 作为底层通信协议,支持 stdio 和 HTTP+SSE 两种传输方式,核心抽象包含三类能力:Resources(结构化数据读取)、Tools(可执行操作)和 Prompts(提示词模板)。这种分层设计让同一个 MCP Server 既能被 Claude Code 调用,也能被任何兼容 MCP 标准的客户端复用,真正实现「一次开发,多处接入」。截至 2025 年,MCP 已获得 OpenAI、Google DeepMind 等主流 AI 厂商支持,正在成为 AI 工具集成的事实标准,目前已涵盖 GitHub、数据库、浏览器自动化等数百个实现。
当你需要查询远程数据库、在 GitHub 创建仓库时,就需要通过 MCP 遵循相应服务的协议安全对接。使用 MCP 的核心心法同样是「写提示词、丢关键字」——例如「帮我安装和配置 Playwright 的 MCP」,Claude Code 便会自动完成配置,无需手动改文件。通过 /mcp 命令可查看本地已安装的服务。
值得一提的是,最新版 Claude Code 已经将 Skill 与自定义 Command 融合。既然两者都以斜杠开头,官方索性统一为 Skill——因为 Skill 既可主动调用,也能由 Claude Code 根据上下文自动触发,能力更全面。
Hooks:生命周期的自动化钩子
Hooks(钩子) 是软件工程中历史悠久的设计模式,核心思想是在预定义的生命周期节点暴露可注入点,允许外部逻辑在不修改核心代码的情况下扩展系统行为。这一模式在现代开发工具链中无处不在:Git 的 pre-commit、post-merge 钩子用于自动化代码检查;React 的 useEffect 等 Hook API 管理组件生命周期;Webpack 的插件系统通过 tapable 实现构建流程的精细控制。
理解 Hooks 模式背后的设计哲学,有助于把握它在 AI 工作流中的真正价值:它解决的是「关注点分离」与「开闭原则」的平衡问题。核心系统(Claude Code 的任务执行引擎)对修改关闭,对扩展开放——质量检查、通知推送、日志记录等横切关注点无需侵入核心逻辑,通过钩子注入即可实现。这意味着团队可以在不同项目、不同环境中复用同一套 Hooks 配置,也可以在不影响 AI 行为本身的前提下灵活调整质量门禁标准。
Claude Code 的 Hooks 系统将同样的理念引入 AI 智能体工作流,允许你在从 session start 到工具执行、结束的整个生命周期中注入任务或代码。结合 ESLint 代码检查、Prettier 格式化、Jest 单元测试的自动化触发,可以构建「AI 生成代码 → 自动质量检查 → 通过则提交 → 失败则反馈修正」的闭环工作流,真正实现人机协作的持续集成。
对普通用户而言用途有限,但对接入工程项目的团队非常实用。一个趣味案例是——每次任务完成自动播放「老铁666」的提示音。配置同样可以通过对话完成,无需死记语法。
并行协作:Subagents 与 Agent Teams
这是 Claude Code 处理复杂任务的高阶能力。
Subagents(子代理) 是「分身术」,体现了 AI 系统设计中的分治策略(Divide and Conquer)。单个智能体面临两个核心瓶颈:上下文窗口容量限制和顺序执行效率低下。多智能体架构最早可追溯至 1980 年代的分布式人工智能研究,但直到大语言模型时代才在软件工程场景中真正爆发——2023 年斯坦福和微软的研究团队分别发布了 MetaGPT 和 AutoGen 框架,系统验证了多智能体在复杂软件开发任务上相比单智能体的显著优势。其通过任务分解与并行执行同时解决上述两个瓶颈——每个 Subagent 拥有独立的上下文空间,处理子任务时不会污染主代理的上下文,完成后只向上汇报结果摘要,极大提升了整体 Token 利用效率。
面对复杂任务,Claude Code 会自动拆分成多个子代理并行执行,且它们互不占用主代理的上下文容量。比如遍历 10 个目录、总结所有文档时,它可能开 10 个子代理各读一个目录,最后由主代理汇总润色。子代理之间互不沟通,只对主代理负责——好比一位经理管理三个不同国家却各自独立的程序员。
Agent Teams(智能体团队) 则更进一步,引入了智能体间通信机制,类似分布式系统中的 Actor 模型——这一并发编程范式起源于 Erlang/Elixir 生态,其核心思想是每个 Actor 拥有独立状态,通过异步消息传递进行通信,天然适合分布式并发场景。Claude Code 的 Agent Teams 借鉴了这一设计,使各智能体既可独立运作,又能在需要时协调共享状态。
理解 Subagents 与 Agent Teams 的本质差异,可以类比软件架构中「无共享(Share-Nothing)」与「有状态协调(Stateful Coordination)」两种模式的取舍:Subagents 采用无共享架构,隔离彻底、故障域小,代价是协作能力受限,适合任务间依赖关系简单的并行场景;Agent Teams 引入状态共享和消息传递,协作能力更强,但也带来了状态一致性和 Token 消耗大幅增加的问题,适合任务间存在复杂依赖、需要动态协商的场景。理解这一权衡,有助于在实际项目中选择合适的并行策略。
启用 Agent Teams 需要 Claude Code 版本至少 2.1.32,并在配置文件中显式开启。需要注意的是,Agent Teams 会显著消耗 Token,使用前需评估额度。
实测中,「用 Agent Teams 帮我在桌面新建 10 个文件夹并写 10 篇不同主题的科技文章」这一任务,Claude Code 启动了 5 个 Agent 分工协作,高效完成了全部内容。
结语:从「学工具」到「切换思维」
纵观整套教程,Claude Code 的学习逻辑始终围绕一个核心——能清晰描述需求,就能让 AI 完成工作。无论是权限配置、MCP 安装还是 Skill 创建,绝大多数操作都可以通过对话让 Claude Code 自行处理,而非手动折腾。
正如教程作者所强调的:AI 时代不必「为了学习而学习」,更应「用到了再反过来学」。真正的进阶,是把「我不懂就茫然」的思维,切换为「让 AI 帮我解决」的思维。
核心要点
相关推荐

Anthropic 演讲解读:模型正在吞噬你的脚手架代码
Anthropic 在 Code with Claude 大会上提出核心观点:开发者去年手搓的脚手架正被模型吸收。本文解读工具路由、上下文管理、代码执行、计算机操作四大能力的变化,以及 Opus 4.7 原生 1440p 坐标、OS World 78% 等关键进展与 Claude Code 实用技巧。
Android CLI重磅更新:Agent自动比对Figma与UI设计
Android CLI新增render Compose preview命令,可将Compose预览直接导出为图片,让AI Agent无需启动应用即可自动比对Figma设计稿与实际UI实现,大幅提升agentic开发中UI还原的效率与准确度。

群蜂模式实测:AI编程助手EvoX正确率从26%飙到71%
AI编程助手EvoX Agent实测:同一模型下,单个智能体正确率仅26%,群蜂模式飙升至71%。本文拆解群蜂协作、自进化技能、多模型切换三大特性,并解析其背后的上下文隔离与代码合并逻辑。