Claude Code全流程实战:接模型写Skill挂MCP跑通前后端
Claude Code 能通读项目、自动排错,靠模型能力与准确性拉开差距,引发程序员危机感。
本文基于一堂公开课,梳理 Claude Code 的真实能力边界。它区别于对话式编码工具的核心在于能通读整个项目上下文、自动调错并交付可运行代码。文章回顾了编程助手从 Copilot 到 Claude Code 的演进,指出工具上限取决于背后的大模型,Claude Code 的 Sonnet 模型带来更高准确性。课程标题指向接模型、写 Skill、挂 MCP 的完整链路,但正文对 Skill 和 MCP 的操作细节着墨有限。作者认为 Claude Code 比 Trae 高一个等级,但也提醒其优势结论基于个人技术栈,开发者应尽早接入工作流,将精力转向定义问题与验证结果。
在AI编程工具层出不穷的当下,一个值得关注的现象是:多数产品还停留在“对话给代码片段”的阶段,而另一类工具已经开始通读整个项目、自动排错并交付可运行的结果。B站上有一堂公开课专门拆解了Claude Code的完整用法,从模型接入到Skill编写再到MCP挂载,试图用一份需求文档跑通前后端。本文结合这堂课程的内容,梳理Claude Code的真实能力边界,以及它为何让不少程序员产生“危机感”。
从对话式编码到项目级代理,差别在哪
课程开篇就点明了Claude Code的定位:一个编码助手,不需要登录任何网站,直接在本机安装后即可在开发工具里使用。这句话看似平常,但它和主流对话式编码工具的分水岭恰恰在这里。
用DeepSeek广告或ChatGPT这类产品写代码,流程是“要片段—拿回来—自己跑—报错—再回去问”,来回多轮才能得到一段能用的代码。更关键的是,这类对话工具读不到你项目的全部上下文。课程里举了一个很具体的例子:项目里可能有上百个代码文件,对话式工具一个都读不到,需要人手动把相关信息喂给它。
Claude Code的做法不同。它能通读项目的所有内容,把这些内容作为上下文交给大模型,再生成业务代码;生成之后还能自动调错,最终给出一个可运行的版本。课程把这种能力称为“自动化开发编程工具”,并坦言光靠讲述很难体会,实际用起来才知道为什么它在开发者圈子里传播得这么快。
上下文窗口:大模型单次能处理的文本量上限,通常以 token 计量。对话式工具受限于此,无法一次性装入整个项目;而 Claude Code 通过项目级索引与分块检索,将相关文件动态注入上下文,从而突破单次窗口限制。理解这一点,就能明白为何“通读项目”并非模型真的记住所有代码,而是工程层面对上下文的调度。
Claude Code在编程工具谱系里的位置
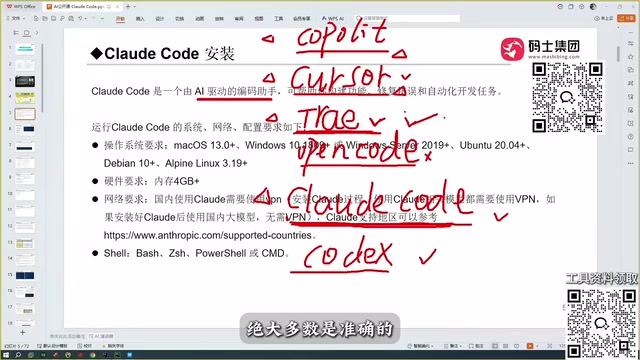
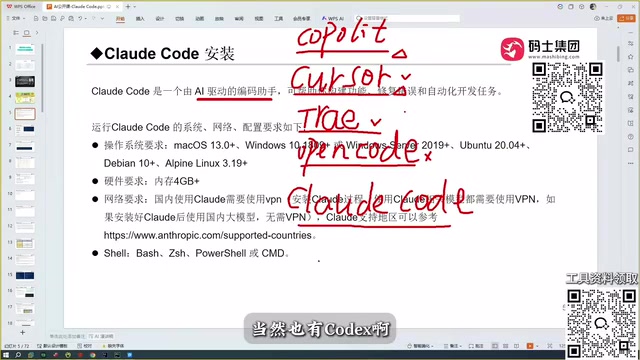
要理解Claude Code的价值,得把它放回编程助手的发展脉络里看。课程里做了一次简要回顾:
- Copilot:早期以插件形态出现,自动补全代码,当时给人的感觉相当颠覆。
- Cursor:在Copilot基础上更进一步,可以自动进行编码,产品形态更完整。
- Trae:有国际版和国内版,国内版免费,对中文理解到位,是不少国内开发者的首选。
- Open Code:课程作者的评价是“所有编程工具里比较难用的一个”,不推荐使用。
- Codex:配置OpenAI模型后能力很强,作者承认其编程能力与Claude Code可以相媲美。
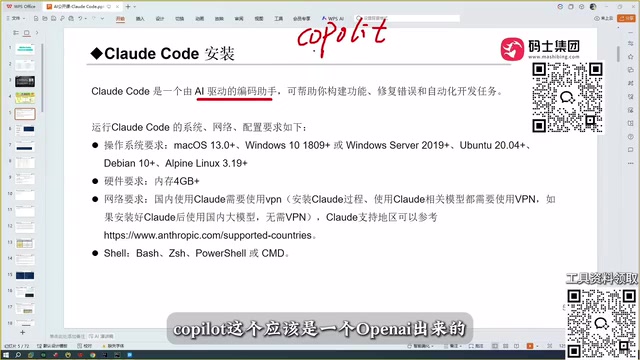
作者的个人使用轨迹很有代表性:早期用Copilot,后来用Cursor,再用Trae,一度认为Trae是最完美的编码工具,因为它对中文的优化明显。但遇到Claude Code之后,这个判断被推翻了——“比Trae还要上一个等级”。
模型能力才是底层变量
课程里有一个判断值得单独拎出来:所有编程助手背后的能力,归根结底取决于它调用的大模型。Claude Code强悍的根源,是它背后的Sonnet模型,而且还有更强的模型可选。
这也解释了一个常见疑问:Trae免费、中文理解好,为什么在实际项目里还是不够用?作者的反馈是,Trae给出的代码“绝大多数是准确的”,但遇到稍微偏门的技术栈,写出来的代码就比较不行。这不是产品交互的问题,而是模型能力的上限。
作者也对比了国内多款模型,包括千问、GLM等,加上Codex配置的OpenAI模型,横向用下来,Claude Code仍然是体验最好的那个。需要说明的是,这部分属于作者的个人使用感受,课程中并未展开具体的对比测试方法,读者可以参考但不必当作严格结论。
Sonnet 模型:Anthropic 推出的中高端 Claude 模型系列,在编程、推理与长上下文任务上表现均衡,常被用作 Claude Code 的默认推理引擎。其优势在于代码生成的准确性和对复杂指令的遵循能力,但具体版本会随迭代更新,课程中提及的“更强模型”通常指 Opus 系列,适合更复杂的架构级任务。
准确性:比“能不能自动写”更关键
课程中有观众提问:Claude Code比Cursor强在哪?作者的回答很直接——准确性。
这个回答背后其实藏着一个行业现状:Cursor、Trae、Claude Code都能做到自动编程,功能列表看起来差不多,但真正拉开差距的是生成结果的准确度。代码生成错一处,后面调试的时间成本可能远超手写。对开发者来说,工具的价值不在于“替你敲了多少行”,而在于“替你省了多少返工”。
课程标题里提到“接模型、写Skill、挂MCP,一份需求文档跑通前后端”,这条链路指向的正是项目级自动化的完整闭环:模型负责推理,Skill负责把特定工作流固化下来,MCP负责连接外部工具和数据源,三者串起来才能让一份需求文档真正驱动前后端产出。不过从课程的文字记录看,作者大量篇幅花在了工具选型和能力对比上,Skill编写和MCP挂载的具体操作细节在本次内容中着墨不多,更偏向演示课的形式。
MCP(Model Context Protocol):一种开放协议,用于让大模型安全地连接外部工具、数据库和 API。在 Claude Code 中,MCP 相当于“插件总线”,使模型能读取文件系统、调用 Git、查询文档等。没有 MCP,模型只能基于静态上下文生成代码;挂载后,它才能实时获取环境信息并执行操作,这是实现项目级自动化的关键一环。
Skill:在 Claude Code 的语境下,指将特定工作流(如“生成 REST API”“运行测试并修复”)固化为可复用的指令集或脚本。Skill 本质是对模型行为的约束与编排,减少每次对话的重复描述,提升输出稳定性。课程标题中的“写 Skill”即指开发者根据自身项目规范定制这类工作流,但原文未展开具体编写方法。
谁该认真对待这类工具
作者在课程里提到一句话:“程序员用了之后会有深深的危机感。”这不是危言耸听。当一个工具能通读项目、自动排错、交付可运行代码时,它在压缩的正是初级编码环节的人力需求。
但也无需过度解读。这类工具目前仍然依赖人给出清晰的需求和上下文边界,模型能力的差异在偏门技术栈上依然明显。对开发者来说,更现实的策略是尽早把这套工具链接入自己的工作流,把精力从“写代码”转移到“定义问题”和“验证结果”上。至于Claude Code是不是当下最强的选择,课程作者的答案是肯定的,但这个答案建立在他自己的技术栈和使用习惯之上,换一个场景,结论可能不同。
相关推荐

Dify 工作流实战:本地部署与私有知识库智能体落地指南
基于 B 站 Dify 实战课程整理:Windows Docker 本地部署、MySQL 连接配置、五类应用与工作流节点案例、外部大模型接入选择,以及应用发布为站点或 API 的完整落地路径。
大模型分布式训练全解析:DP/TP/PP/SP一次讲透
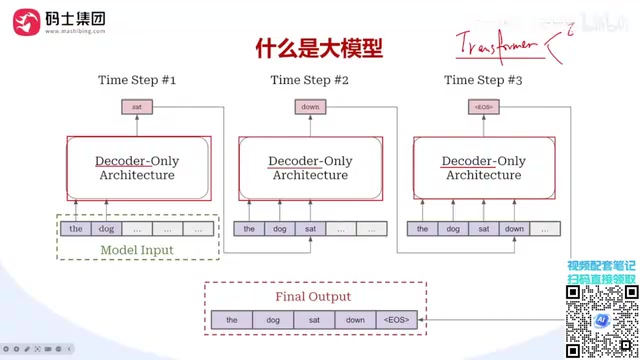
从单卡显存瓶颈出发,系统讲解大模型分布式训练中的DP数据并行、TP张量并行、PP流水线并行与SP序列并行,剖析各自切分维度、通信代价与混合并行实战选型逻辑。
DeepSeek Harness保姆级教程:安装配置到插件实战
DeepSeek Harness保姆级教程:详解Node.js环境配置、客户端安装步骤,以及对话式、插件市场、命令行三种插件安装方式,助你快速上手这款开源AI Agent框架。