Claude Fable 5.2 评测与AI智能体记忆机制解析
Claude Fable 5.2 通用创意亮眼但编码性价比存疑,AI 加速报告与 Agent 记忆机制同样值得审视。
文章从播客第47期中提取三条主线。第一,Claude Fable 5.2 定价下降、速度提升,通用任务与创意生成表现突出,但编码基准相对 Opus 5.5 领先不足 10%,升级性价比存疑,主持人对小版本迭代动机也有保留。第二,Anthropic 内部报告称 AI 能力一年翻倍、研究效率提升十倍,可能逼近递归自我改进阈值,但关键数据被大量涂黑,且发布时间与 IPO 计划重合,可信度需打折扣。第三,Agent Memory 采用转录、笔记、结构化知识到上下文注入的分层设计,压缩过程被称为 dreaming,Fable 5 相比 Sonnet 3.7 能提取规则而非堆砌细节。文章还提及 GitHub 密钥泄露与 Hinton 的风险警告。
引言:当播客聊起AI的「加速」与「隐忧」
Artificial Developer Intelligence(ADI Pod)第47期围绕三个话题展开:Claude Fable 5.2 模型评测、AI 加速 AI 研究的最新报告、以及 AI 智能体的记忆机制。三位主持人的讨论穿插了大量实操体验与行业观察,也暴露了当前 AI 领域几个值得深挖的信号。
这篇文章不打算复述播客内容,而是从中提取三条主线:模型迭代是否正在进入边际收益递减的区间?AI 加速科研的叙事背后有多少可信度?Agent Memory 的设计为什么比想象中更复杂?
Claude Fable 5.2 评测:通用能力亮眼,编码性价比存疑
定价与速度:更便宜,也更快
Anthropic 发布的 Claude Fable 5.2 将价格调整为每百万输入 token 8 美元、每百万输出 token 40 美元,相比 Fable 5.1 的 10 美元/50 美元有所下降。Anthropic 官方称新模型在输出质量不降级的前提下,速度比 5.1 快约 30%。
基准测试:编码领域提升有限
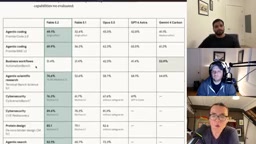
播客主持人 Shemin 在对比基准数据时指出了一个关键细节:Opus 5.5 在 Frontier Code 2.0 基准上成功率为 55%,而 Fable 5.1 仅为 32.4%。Fable 5.2 虽然提升到 49.1%,但相比 Opus 5.5 的领先幅度不到 4 个百分点。在 Frontier Suite、Automation Bench、Cyber Scenario Bench 等编码相关基准上,Fable 5.2 对 Opus 的优势均未超过 10%。
「Fable 5.2 不是编码专用模型。如果你看编码类基准,它相对 Opus 的领先只是温和的增量改进,是否值得额外成本存疑。」
但在通用任务上,差距明显拉大:Remote Labor Index 基准上 Fable 5.2 比 Opus 5.5 高出约 20%,图表识别基准 Chartography 上有 10 个百分点的提升,Artificial Analysis Intelligence Benchmark 上也有约 6 分的进步。
创意任务:从「能用」到「惊艳」
播客中最具说服力的部分是自定义创意基准。在莎士比亚独白生成任务中,Fable 5.2 不只是生成了可运行的浏览器动画,还自主决定用一个小型语音模型合成音频,并加入了镜头推近效果。主持人评价其面部表情「有真实的情感表达」,虽然整体带有某种恐怖谷效应,但「我找不到明显的严重缺陷」。
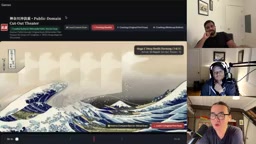
不过,在神奈川冲浪里剪纸动画任务中,三个前沿模型都暴露了视觉理解上的缺陷。Fable 5.2 的浪花被形容为「像在朝你挥手」,动作逻辑不自然。这说明当前模型在需要精确空间推理的动画任务上仍有明显天花板。
小结: favorite model,但不是无脑升级
Shemin 的结论是 Fable 5.2 是他目前最喜欢的模型,理由集中在输出简洁、通用任务强、创意任务表现突出。但 Dan 和 Rahul 持保留态度,认为编码场景的性价比不足以支撑升级,且小版本迭代更像是为 IPO 造势。
AI 加速 AI 研究:一份被大量涂黑的报告
报告说了什么
Rahul 在节目中介绍了一份关于 Anthropic 内部研究的报告(经 Planned Obsolescence 的 Ajay Akotra 总结)。核心结论是:Anthropic 内部的能力指数在一年内翻倍,研究人员借助 AI 工具可以完成相当于过去十天的工作量。如果这种加速形成正反馈,就可能逼近所谓的「递归自我改进」阈值。
为什么需要谨慎对待
播客花了大量篇幅讨论这份报告的可信度问题。报告本身有大量内容被涂黑,理由是「防止加速其他 AI 开发者」。这意味着外界看到的是二手解读,而非原始数据。此外,Anthropic 在 S-1 文件中提到其负责任扩展政策可能「即将触及」某个阈值,而公司又计划上市——时间点的巧合让主持人 Dan 直言:「我在找一些可能不存在的东西。新模型发布、报告说一年内 AI 能自我构建、下周 IPO,你在讲一个特定的故事。」
「递归自我改进」是 AI 安全领域的一个核心概念,最早由 I. J. Good 在 1965 年提出「智能爆炸」假说。其基本逻辑是:当 AI 系统能够参与改进下一代 AI 的设计与训练时,每一代系统的能力提升会缩短下一代系统的研发周期,从而形成正反馈循环。Nick Bostrom 在《超级智能》中将此列为通往超级智能的可能路径之一,同时也指出其中存在「目标漂移」和「控制丧失」的风险。当前讨论的焦点在于,大模型虽然能在代码生成、实验设计、文献综述等环节显著提速,但距离完全自主地提出新架构、验证假设并迭代训练仍有关键差距,因此「递归自我改进」更多是一个用于评估趋势斜率的概念框架,而非已经发生的事实。
共识与分歧
三位主持人一致认为,无论报告细节如何,模型能力加速、智能体无人值守运行时间变长的体感是真实的。分歧在于:这是线性外推的合理预测,还是 IPO 前的叙事包装?节目没有给出定论,但提醒听众「带着一大把盐」来看待。
S-1 文件是美国证券交易委员会(SEC)要求的上市注册声明,公司在其中必须披露业务模式、风险因素、财务状况以及治理结构等关键信息。对于 AI 公司而言,S-1 中的风险因素章节往往会涉及模型能力边界、安全政策、监管不确定性等内容,因此常被外界当作观察公司自我认知的窗口。播客中提到 Anthropic 在 S-1 中表述其负责任扩展政策「可能即将触及」某个阈值,这意味着公司需要在招股材料中向潜在投资者说明能力提升带来的合规与声誉风险。将这一披露与同期发布的内部加速报告并置,正是主持人质疑「叙事包装」的出发点——不是指内容虚假,而是指信息释放的时机与组合可能服务于资本市场叙事。
Agent Memory 如何工作:从原始记录到「做梦」
分层记忆结构
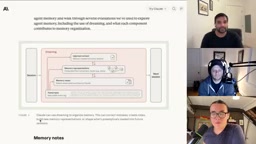
Rahul 介绍了 Anthropic 关于 Agent Memory 的技术拆解。整个系统分为几个层次:最底层是完整的对话转录记录,带有「可能有用」的标签;上一层是从中提取的笔记;再往上是将笔记组织成结构化、可链接的 wiki 式知识;最终在需要时,系统将相关记忆注入当前对话上下文。Anthropic 将这一从原始流到可用上下文的压缩过程称为「dreaming」。
「上下文窗口」指模型单次推理时能够直接读取的 token 总量,超出部分不会被模型感知。外挂记忆系统的本质,是在上下文窗口的硬约束下,通过检索与压缩把最相关的历史信息重新注入窗口。这与「微调」和「持续学习」形成对比:微调通过更新权重把知识固化进模型,但成本高、周期长,且难以做到实时;持续学习则试图让模型在部署后持续更新参数,但面临灾难性遗忘和稳定性问题。因此,当前工程实践普遍采用「参数冻结 + 外部记忆读写」的架构,把记忆管理交给检索层和压缩层,模型本身只负责在给定上下文内推理。这也解释了为什么记忆系统的设计质量会直接决定 Agent 在长任务中的表现上限。
从 Pokémon Red 看记忆演化
两个版本的对比很有说服力。Sonnet 3.7 在玩 Pokémon Red 时会把大量细节塞进记忆,反而污染了关键信息。而 Fable 5 能聚焦于策略层面,推断游戏规则并存储这些规则,即便当次失败也能在后续对局中复用。这说明模型本身的能力提升直接改变了记忆系统的有效边界。
记忆的代价与人类类比
播客中一个有意思的观察是:注入过多记忆上下文反而会让管理变难,类似于人类认知中近期记忆与远期记忆的权重失衡。此外,每次回忆都是一次轻微改写——如果 Agent 也遵循类似机制,它的记忆会逐渐偏离原始事实。Rahul 还提到模型无法在推理时更新权重,因为那会导致模型崩溃(近期数据权重过高最终输出混乱),这也是为什么外挂记忆系统成为当前的主流方案。
「灾难性遗忘」是神经网络持续学习中的经典问题:当模型用新数据更新权重时,先前学到的表示会被覆盖或干扰,导致旧任务性能急剧下降。在在线学习场景下,如果近期数据的梯度反复作用于同一批参数,模型输出会向近期分布严重偏移,表现为重复、混乱或对旧指令的失忆。这正是播客中提到「推理时更新权重会导致模型崩溃」的技术背景。缓解手段包括弹性权重固化、经验回放、参数隔离等,但这些方法在大规模语言模型上的工程成本仍然很高,因此业界更倾向于用检索增强和外挂记忆来绕开权重更新,把「记住什么」与「如何推理」解耦。
其他值得关注的信号
播客新闻环节还提到两件事。其一,有研究扫描公开 GitHub 仓库,在 1,900 个仓库中发现 2,539 个真实密钥,问题源头之一是 Claude Code 的权限设置被提交到公开仓库。其二,Geoffrey Hinton 在采访中警告 AI 风险可能在十年内见分晓,并点名不信任几位行业领袖,同时预测会出现类似「三里岛事件」的警示性事故。
Dan 的 Vibe & Tell 环节则展示了一个实用案例:他用 Claude 反编译 Godot 引擎游戏 Slay the Spire 2 的 C# 代码,定位触摸坐标 bug 并打包成 mod,整个过程约 20 分钟,没有手动查看补丁代码。这既展示了编码智能体的实际生产力,也呼应了播客对「Anthropic 禁止智能体逆向游戏」政策的调侃。
结语
这期播客的价值不在于给出结论,而在于呈现分歧。Fable 5.2 是不是值得升级,取决于你的使用场景;AI 加速科研的报告有多少可信度,取决于你对涂黑数据的容忍度;Agent Memory 的设计边界,则取决于你如何看待「记忆」这件事本身。三个话题共同指向一个事实:AI 系统的能力在提升,但围绕它的判断框架远未成熟。
相关推荐

DeepSeek全家桶API开源复刻,Claude全球宕机|AI日报
DeepSeek开放全家桶API并开源Chat Demo,Claude全球宕机暴露身份验证故障,OpenAI推ChatGPT Wallet、解散机器人团队,llama.cpp 1.0发布,腾讯混元与蚂蚁Ling 3.2 Flash等模型密集更新。

Qwen4本地部署速度前瞻:显存不是唯一,两条路线实测参考
Qwen4本地部署速度前瞻:B站UP主实测两条路线,Strada方案低门槛但速度依赖CPU,大容量统一内存方案流畅度更高。提醒显存之外KV缓存和运行空间才是关键,硬件配置需等模型正式发布后验证。

闭源当前,唯有开源:AGI火种的生存法则
从一张被砍到极限的算力预算表出发,解读B站内部讲话中“闭源当前,唯有开源”的判断:闭源是被资本验证过的路径,但未必适用于所有团队。文章分析分享与克制的组织策略,以及资源约束下开源成为理性选择的原因。