Claude Opus 5.5 报错激增:一次23分钟的服务中断全记录
Claude Opus 5.5 报错激增,Anthropic 用 23 分钟完成从调查到修复,暴露大模型服务稳定性与透明度短板。
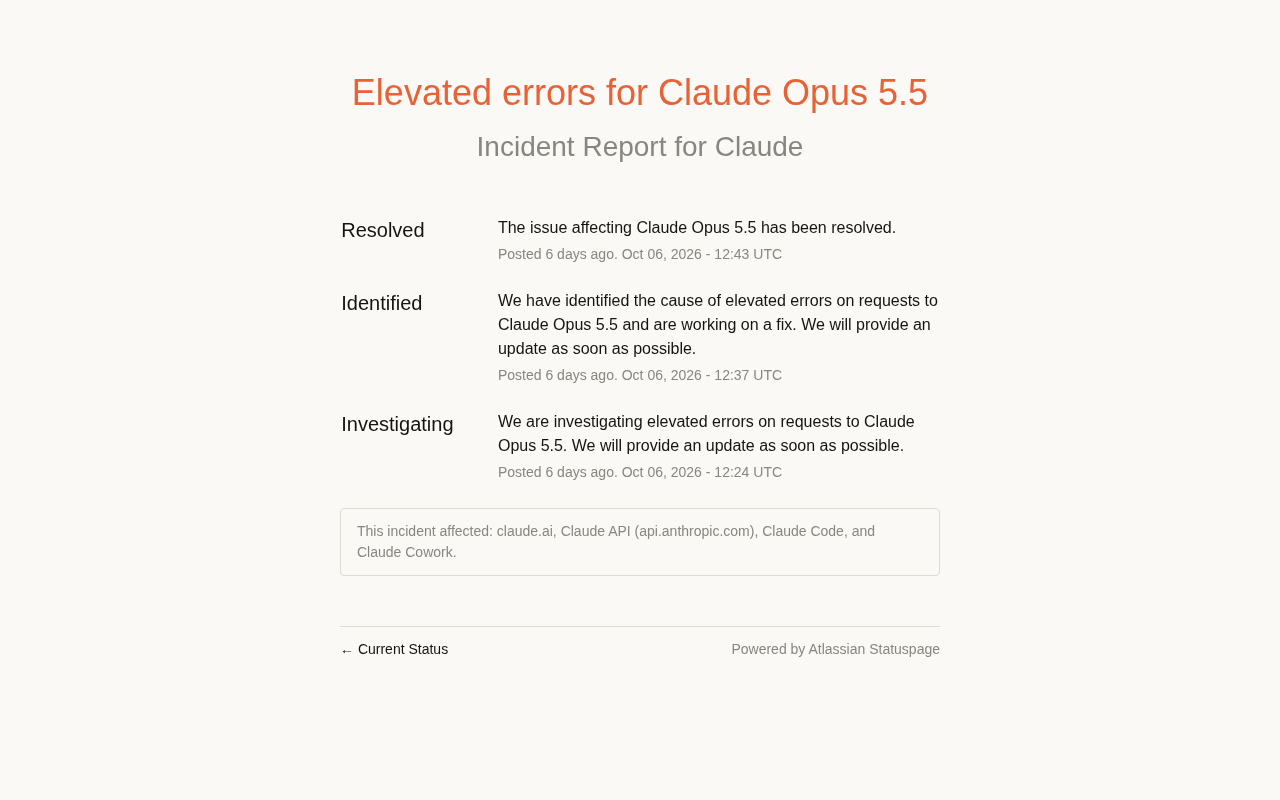
Anthropic 官方状态页记录了一次 Claude Opus 5.5 的服务异常:12:24 UTC 标记调查中,12:37 定位根因,12:43 宣布解决,全程约 23 分钟。官方只披露了状态流转,未说明错误类型、影响比例和根因归属。文章指出,大模型 API 通常位于应用核心链路,且缺少平滑降级手段,短时故障容易被放大为用户可见的中断;模型可用性正在成为企业选型的硬指标,状态页的透明度直接影响开发者信任。文章最后给出超时重试、多模型兜底、状态页联动告警和优雅降级等实操建议。
Claude Opus 5.5 报错激增:一次23分钟的服务中断全记录
Anthropic 官方状态页记录了一次影响 Claude Opus 5.5 的服务异常。从首次标记"调查中"到宣布"已解决",整个过程持续约 23 分钟。对依赖该模型构建产品的开发者来说,这个时间窗口足以让一批线上请求集中失败,也再次把大模型服务的稳定性问题推到了台前。
事件时间线:从发现到修复的 23 分钟
根据状态页的三次更新,事件节奏相当紧凑。12:24 UTC,Anthropic 首次标记状态为 Investigating(调查中),确认 Claude Opus 5.5 的请求出现"报错激增",并承诺尽快更新。仅 13 分钟后,12:37 UTC,团队将状态推进到 Identified(已定位),说明根因已经找到,修复正在推进。又过了 6 分钟,12:43 UTC,官方宣布 Resolved(已解决),异常关闭。
你可能没注意到,Anthropic 全程没有披露受影响请求的具体比例、错误类型(是超时、限流还是内部错误),也没有说明根因归属——是模型推理侧、API 网关还是底层基础设施。对普通用户而言,这只是状态页上的一行字;对工程团队而言,缺失的信息恰恰是决定是否要加降级逻辑的关键。
Anthropic 状态页采用业界常见的三阶段事件状态机:**Investigating(调查中)**表示已确认异常存在但根因未明;**Identified(已定位)**表示根因已找到、修复方案确定并正在执行;**Resolved(已解决)**表示异常指标回归正常、事件关闭。这套词汇源自 Statuspage 等状态页服务商的默认模板,被主流云厂商广泛沿用。状态流转的速度本身就是信号:从调查到定位只花 13 分钟,说明问题大概率不是需要长时间复现的疑难 bug,而更可能是配置变更、容量瓶颈或依赖组件抖动这类可快速定位的故障。
为什么一次短暂中断值得认真对待
23 分钟在传统 Web 服务里或许只算轻微抖动,但在大模型 API 场景下,影响会被放大。多数 AI 应用把模型调用放在核心链路上:一次请求延迟或失败,可能直接导致对话中断、Agent 任务卡死,甚至触发上游超时连锁反应。
更关键的是,模型服务通常缺少"降级到旧版本"这种平滑过渡手段。切换模型意味着输出风格、格式稳定性、工具调用行为都可能变化,很多团队宁愿短时失败也不愿临时换用其他模型。于是,服务端的一次报错激增,往往就是客户端的一批用户可见故障。这也解释了为什么开发者社区对状态页更新的颗粒度如此敏感——信息越模糊,越难做决策。
指数退避重试指的是客户端在请求失败后,按 1s、2s、4s、8s 这样的指数级间隔逐步拉长重试等待时间,并可叠加随机抖动(jitter)以避免大量客户端在同一时刻同时重试。它之所以重要,是因为大模型 API 的报错激增往往具有瞬时性——服务端过载时,如果所有客户端立即无节制重试,会形成"重试风暴",把已经脆弱的服务进一步压垮。指数退避配合幂等性保证,既能给服务端恢复窗口,又能避免重复计费和重复副作用。
模型稳定性正在成为选型硬指标
过去一段时间,大模型能力的比拼集中在推理、代码、多模态等维度。但随着企业级应用铺开,可用性的权重正在快速上升。一个模型再强,如果高峰期频繁报错、状态页语焉不详,团队就很难把它放进生产环境的关键路径。
这次 Claude Opus 5.5 的事件本身规模不算大,官方响应速度也相对及时。但它提醒了一件事:对模型供应商而言,状态页不只是公关工具,而是开发者做架构决策的输入源。错误率、影响范围、根因复盘这些信息,如果能更透明地披露,对生态的信任积累远比"尽快更新"四个字更有价值。
多模型兜底在实践中并非简单地把调用地址换成另一家 API。不同模型的输出格式、指令遵循程度、工具调用(function calling)的 JSON 结构、上下文窗口乃至 token 计费方式都存在差异,直接切换可能导致下游解析失败。较稳妥的做法是在应用层抽象出一层模型适配接口,统一的输入输出契约由适配层负责转换,并针对备用模型预置提示词微调版本。此外还需考虑数据合规:如果业务涉及敏感数据,备用供应商是否在允许名单内,往往在选型阶段就已被法务锁定。
给开发者的几点实操建议
面对不可预期的模型服务波动,工程侧可以做的准备包括:
- 超时与重试策略:为模型调用设置合理超时,并对幂等请求启用指数退避重试,避免瞬时错误直接暴露给用户。
- 多模型兜底:在核心链路上预留可切换的备用模型,即使输出风格有差异,也好过完全不可用。
- 监控状态页与错误率:把供应商状态页和自身 API 错误率联动告警,缩短发现时间。
- 面向用户的优雅降级:当模型不可用时给出明确提示或排队机制,而不是让界面无限转圈。
这类准备的成本不高,却能在类似事件中把影响从"服务中断"压缩到"体验降级"。模型服务的稳定性问题不会消失,能被工程手段吸收的部分,就不该留给运气。
相关推荐

WorkBuddy智能体实战:从AI问答到自动办公的跨越
WorkBuddy是腾讯推出的AI智能体桌面工作台,能读取本地文件、操作办公软件、执行多步骤任务并定时自动运行。本文详解其核心功能、与传统AI工具的本质区别及适用场景。

Anthropic研究:LLM让形式化软件验证规模化成为可能
Anthropic Frontier Red Team研究显示,LLM已能在上百个真实开源库的RISC-V汇编级别批量生成形式化证明,覆盖123个OSS-Fuzz库、239个入口点,合计约1.8亿行Rocq证明,并在过程中发现数百量级Bug。文章解析其规格生成、证明流水线、信任边界与成本下降路径。

提示词工程入门:从写提示词到构建AI协作能力
从提示词的四大作用到提示词工程的六步流程,系统梳理AI提示词工程的核心概念、商业价值与三层局限性,帮助初学者建立对提示词工程的完整认知框架。