Claude Opus 5.5 登陆 Cursor:CursorBench 登顶,成本直降 40%

Claude Opus 5.5登顶Cursor评测榜首,同时将单任务成本压低40%。
Anthropic旗下Claude Opus 5.5正式接入编程平台Cursor,在Cursor自建的真实编程场景评测基准CursorBench上以57.8%的成绩(Max模式)登顶榜首,同时单任务成本较前代Opus 5降低40%。CursorBench专注于跨文件修改、代码重构、上下文理解等工程级任务,比通用代码基准更贴近开发者日常工作。成本大幅下降意味着此前因价格偏高而被"留给关键任务"的Opus系列,如今可被更广泛地用于日常开发流程。文章同时提示,榜单成绩与真实项目体验之间仍存在差异,建议开发者结合自身技术栈进行验证后再决定是否将其列为主力模型。
Claude Opus 5.5 正式接入 Cursor
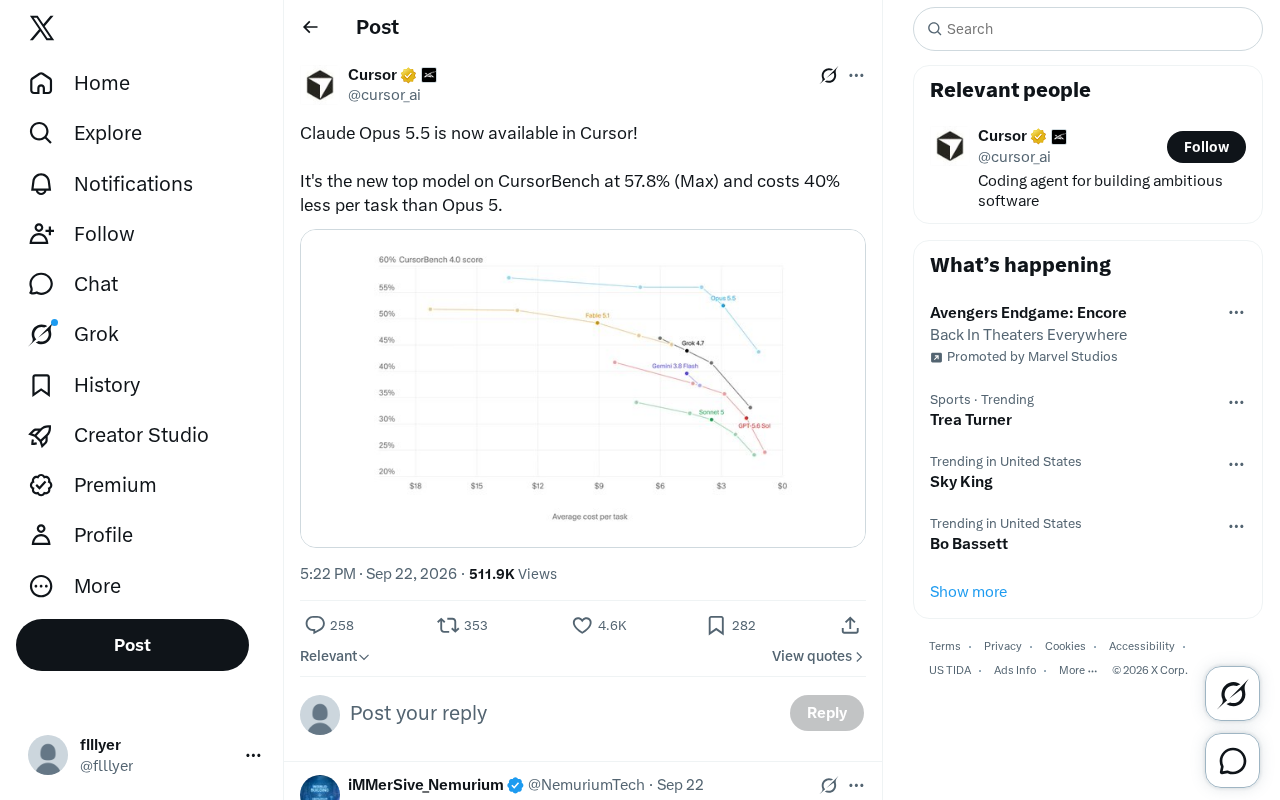
Cursor 官方宣布,Claude Opus 5.5 已正式上线其编程平台。这一新模型在 Cursor 自建的评测基准 CursorBench 上以 57.8%(Max 模式)的成绩登顶,成为当前榜单上表现最强的模型。更值得关注的是,它在单任务成本上比前代 Opus 5 降低了 40%。
对于每天与 AI 编程助手打交道的开发者来说,这两项指标——更强的能力与更低的成本——正是最直接影响使用体验的因素。
CursorBench 57.8% 意味着什么
CursorBench 是 Cursor 针对真实编程场景设计的评测基准,相比通用代码测试集,它更贴近开发者在实际项目中遇到的任务:跨文件修改、上下文理解、代码重构与调试等。
Opus 5.5 在 Max 模式下取得 57.8% 的成绩并登上榜首,说明它在处理复杂、多步骤的编程任务时具备更强的推理与执行能力。Max 模式通常意味着模型可以调用更大的上下文窗口和更充分的推理预算,因此这一成绩代表的是模型能力的上限表现。
需要说明的是,官方仅公布了这一核心数据点,与其他模型的具体差距、各细分任务的表现分布等信息尚未详细披露,实际效果仍需开发者在自己的工作流中验证。
CursorBench 在业内属于垂直场景评测基准(domain-specific benchmark),与 HumanEval、MBPP 等通用代码生成基准不同,后者主要考察模型能否从零生成满足特定函数签名的代码片段。CursorBench 的题目更接近工程师真实工作日:在已有大型代码库中定位问题、跨多个文件协调改动、理解隐式依赖关系。这类任务对模型的长上下文检索与多步规划能力要求更高,因而得分更能反映 AI 在真实工程环境中的落地价值,而不仅仅是算法题解题能力。
成本下降 40% 的现实价值
相比性能提升,成本降低 40% 或许是更具吸引力的一点。在 AI 编程工具日益普及的当下,模型调用成本直接决定了团队能否大规模、高频率地使用高端模型。
此前 Opus 系列因能力强但价格高,往往被用户留给最关键的任务,日常开发则更多依赖成本更低的模型。Opus 5.5 在保持甚至提升能力的同时把单任务成本压下四成,实际上降低了顶级模型的使用门槛,让更多开发者能够在日常工作中放心使用最强模型。
这也反映出当前大模型竞争的一个趋势:厂商不再单纯堆砌能力,而是在能力与性价比之间寻找更优的平衡点。
在 AI 编程工具的定价体系中,"单任务成本"通常以 token 消耗量为计价单位——模型每处理一次请求(输入 token + 输出 token)产生相应费用。对于 Cursor 这类 IDE 级别的工具,每次自动补全、代码解释或重构建议都会触发模型调用,高频使用场景下累计成本可观。40% 的降幅意味着同等预算下可完成约 1.67 倍的任务量,或者说团队在月度 API 账单不变的前提下,能将顶级模型的使用频率提升近七成。这对中小团队尤其有意义,因为此前高昂的 Opus 系列价格往往迫使他们在成本与能力之间做出妥协。
对开发者的实际影响
对 Cursor 用户而言,Opus 5.5 的上线意味着可以在同一工作流中直接切换到这一新模型,无需额外配置。能力更强、成本更低的组合,使其适合承担从复杂重构到日常代码补全的多种任务。
不过,榜单成绩与实际体验之间往往存在差异。CursorBench 的高分是一个有力的参考,但每个项目的代码风格、技术栈与任务类型不同,模型的实际表现会有所波动。建议开发者结合自身场景进行小范围测试,再决定是否将其作为主力模型。
随着各家厂商持续迭代,AI 编程助手的能力与成本仍在快速变化。对使用者来说,保持对新模型的关注并及时验证,是充分利用这些工具的关键。
相关推荐

Gemini 4 Argon实测:AI自主造桌游、建寺庙、训机器人
Gemini 4 Argon 实测汇总:AI 自主用 Blender 搭建书桌赛道与寺庙、编写光线追踪引擎、训练人形机器人连进7球,并附 API 定价与开发者接入方式。

魔法八边形硬币:为何仅9%的人能预测它的翻转?
魔法八边形硬币仅9%的人能正确预测其翻转方向。本文解析其空间旋转机制、常见认知误区,并介绍基于相关性理论的新假说,探讨人类空间推理的局限。

Sam Altman:AI正迈入科学发现时代,数学突破将复制到生物与能源
Sam Altman 表示 AI 正进入科学发现时代,数学领域的突破方法将复制到生物学、材料科学和能源领域,帮助研发新药与新能源。他认为这种影响不会让人直接感知,而是融入社会日常运转。