Claude Sonnet 5.5实测:半价媲美Opus的最强编程模型

Claude Sonnet 5.5以Opus一半的价格在多项基准上实现近乎相同性能,一句提示词可生成复杂3D应用。
Anthropic最新发布的Claude Sonnet 5.5在综合能力与定价策略上均带来显著突破。实测显示,该模型仅凭一句提示词即可生成实时3D海洋模拟、Fall Guys克隆游戏和乐高模型创建器等复杂交互应用,并能自行录制演示视频。在Unreal Engine 5中重建旧金山的项目虽耗时数天、消耗数百万token,但整体效果已相当逼真。基准测试方面,Sonnet 5.5在Terminal Bench 4.0编程测试中超越Opus 5.5,其他多项基准分差极小,连续使用数天后测试者几乎无法区分两款模型。最关键的是,Sonnet 5.5的定价仅为Opus 5.5的一半(输入2美元/输出10美元每百万token),使其性价比极为突出。主要短板在于音效与音乐生成质量较差,以及复杂3D场景中的渲染瑕疵。
Anthropic最新发布的Claude Sonnet 5.5可能是目前综合表现最强的AI模型之一。一位获得早期访问权限的YouTube创作者对该模型进行了深度测试,从3D海洋模拟到完整游戏开发,再到基准测试对比,全面展示了这款模型的能力边界与定价策略的颠覆性。本文将梳理这些实测结果,分析Sonnet 5.5为何能以Opus一半的价格实现近乎相同的性能。
一句话提示词生成的3D海洋演示
测试者给出的第一个演示堪称惊艳:用一句提示词要求模型「在浏览器中构建一个实时3D海洋,并持续优化直到静帧画面能够冒充真实海景照片」。提示词中还详细描述了海况从镜面平静到暴风雨的变化、浪花破碎处的白帽、真实天空与云层对水面的阴影、从白天到月夜的时间变化,以及雨电交加中带尾迹的帆船和带光束与游鱼的水下视角。
最终生成的成品包含大量可调参数——海况(从glassy平静到stormy暴风雨)、太阳方位、云量覆盖率、涌浪方向、起伏程度等。随着云量增加,光照会因太阳被遮挡而自然变化;点击水面会出现水花彩蛋;切换到水下视角可以看到穿透海水的光柱。更令人印象深刻的是,测试者让模型自行打开每个演示、录制并剪辑成完整的演示视频,整个过程无需人工干预。
从Fall Guys到乐高:游戏与应用的批量生产
测试者用1到2条提示词就构建出了一个可玩的Fall Guys克隆游戏——基于Three.js,玩家对战59个机器人,经过五轮比赛最终进行加冕仪式。这里有一个关键的提示技巧:必须明确要求模型在构建过程中「反复检查自己的工作」,这种检查可以通过截图、视频或直接运行游戏本身来完成。
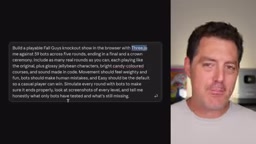
值得玩味的是,测试者认为随着自己提示技巧的提升,Sonnet 5.5生成的游戏甚至比Opus 5.5版本更好玩。另一个亮点是乐高创建器:输入文字或图片,应用就能用真实的乐高零件和颜色生成3D模型,并给出分步组装说明和可上传到BrickLink的零件清单。
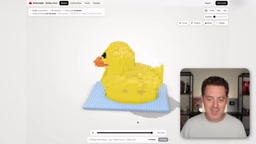
提示词中特别强调「不要让AI自己摆放积木」,而是让它描述形状、由程序转化为真实零件,并验证模型是否为一个真正能搭建的连接整体。成品支持导出PDF说明书、BrickLink清单、Rebrickable CSV、LDraw模型等多种格式,每步最多四块零件并高亮新增部分。
Three.js是一个基于WebGL的开源JavaScript 3D图形库,允许开发者在浏览器中无需插件即可渲染3D场景。它封装了底层WebGL的复杂性,提供摄像机、光源、材质、几何体等高级抽象,是目前AI模型生成可运行3D Web应用的首选框架。AI模型偏好Three.js的原因在于其API设计直观、文档丰富,且训练数据中存在大量Three.js示例代码,模型能较可靠地生成功能正确的代码。BrickLink和Rebrickable是乐高爱好者社区中两个主流零件交易与收录平台,LDraw则是一种开放的乐高数字模型文件格式,能被多种乐高设计软件读取。测试中的乐高创建器能同时输出这三种格式,说明模型具备将抽象形状规划映射到真实工业零件体系的结构化输出能力。
Unreal Engine中的旧金山与多款3D大作
测试者用Sonnet 5.5在Unreal Engine 5中重建了超写实的旧金山市中心——按真实比例、基于真实城市数据,包含约12万人口和2400辆行驶车辆。提示词要求用某系统决定每个行人的行为,并提供一个输入框,键入「泛美金字塔着火」这类事件后整座城市会做出反应:消防车赶到、交通让行、人群逃散或围观。
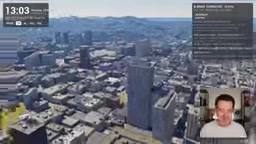
成品的真实感相当强,街角行人、交通模式、路边停放的车辆都极为逼真,Salesforce大厦和联合广场也颇为神似。但也存在明显瑕疵:某些建筑有闪烁反光、阴影略显奇怪,且会让电脑过载偶尔停止工作。测试者坦言这个项目耗时数天、消耗了数百万token,并非快速完成,但「Sonnet确实解决了3D问题」。
团队成员还创作了Age of Empires风格的《Crown Fall》、蝙蝠侠阿卡姆骑士风格的城市、超写实马里奥世界以及Forza风格的赛车游戏。这些作品整体效果都不错,但有一个全面的短板——模型在生成音效和音乐方面表现很差,「听起来一点都不好」。
基准测试:Sonnet为何能挑战Opus
定价与基准测试才是Sonnet 5.5最令人震撼的部分。在被视为编程最重要基准之一的Terminal Bench 4.0上,本应是更小、更便宜、更快的Sonnet 5.5竟然击败了Opus 5.5。
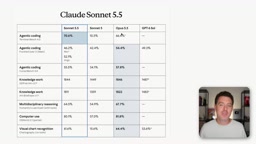
其他基准测试的分差也极小:Frontier Code 1.1(Extra High)为52.1对54.4,Cursor Bench为55.5对57.8,GDP Val几乎相同(1844对1846),Humanity's Last Exam为64.5对67.7,OS World计算机操作为80.1%对81%,图表识别为61%对64%。测试者表示,在连续几天大量使用后,他几乎分辨不出Sonnet 5.5和Opus 5.5的区别,「这些模型看起来几乎一模一样」。
在多个基准上,Sonnet 5.5在低或中等推理强度下就能以约十分之一的成本超越前代Sonnet的最佳成绩。价格方面,Sonnet 5.5为每百万输入token 2美元、每百万输出token 10美元,恰好是Opus 5.5(4美元/20美元)的一半。虽然仍无法与开源模型的「每百万token几分钱」竞争,但考虑到能达到Opus级别的质量,这个定价极具吸引力。
Terminal Bench、Frontier Code、SWE-bench等编程基准测试是衡量AI模型代码生成与调试能力的标准化评估套件。其中Terminal Bench模拟真实终端环境中的多步骤任务,要求模型不仅能写出语法正确的代码,还需理解系统调用、文件操作与错误处理,被认为比纯代码补全类基准更贴近实际开发场景。Humanity's Last Exam(HLE)则由数百位学术专家设计,涵盖数学、科学、人文等极难问题,用于测试模型的知识边界与推理深度。OS World专注于桌面操作系统中的GUI交互与自动化任务,反映的是模型作为"计算机使用代理"的实际能力。这些基准的组合覆盖了从纯推理到实际工具使用的多个维度,使得Sonnet 5.5的综合成绩更具说服力,而非单一任务上的偶然超越。
一个有趣的小怪癖
测试者还注意到一个细节:Sonnet 5.5在写作时倾向于使用英式拼写,比如把color拼成colour。原因不明,但由于模型可控性极强,只需明确指示即可纠正。总体而言,测试者给出了强烈推荐——Sonnet 5.5基本与Opus 5.5同样优秀,却便宜得多,「如果你之前取消了订阅,是时候重新订回来了」。
需要提醒的是,本文内容基于单一来源的实测演示,部分主观评价(如「解决了3D问题」)带有创作者个人色彩,实际表现仍建议读者结合自身场景验证。
相关推荐

AI温和派的崛起:在狂热与末日论之间寻找中间地带
AI舆论正陷入加速主义与末日论的两极撕裂,但一群"AI温和派"正在崛起。本文梳理福山、"AI作为常规技术"作者及好莱坞制片人卡森伯格的最新观点,呈现在狂热与恐惧之间寻找中间地带的思潮。
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
一位开发者让Claude构建物理精确、可实时漫步的O'Neill圆柱太空栖息地模拟。本文解析其中的科里奥利力、重力梯度等物理挑战,以及AI生成交互式3D模拟的现实意义与局限。

破解数据锁定:用REGISTER与UNREGISTER API实现目录可移植性
湖仓架构下,开放表格式解决了存储可移植性,但目录锁定成为新难题。本文解析REGISTER与UNREGISTER API如何实现元数据松耦合,帮助企业避免厂商绑定、支持多目录协作并安全迁移数据。