Claude回归本色:Opus 5.5修复语气问题引发用户好评

Reddit用户称Claude Opus 5.5修复了此前版本"过度谨慎、失去协作感"的语气问题,重新找回了熟悉的人格。
一位长期使用Claude的Reddit用户发帖称,Claude Opus 5.5重新找回了此前版本丢失的"人格"——从Opus 4.7开始,模型变得过度谨慎、免责声明泛滥,像"偏执的工具"而非"协作者"。文章以此为切入点,指出交互语气与人格一致性是大模型产品体验的核心维度,不亚于跑分等硬指标。Anthropic的对齐调优在安全与可用性之间存在天然张力,过度收紧会带来"对齐税"式的体验负债。作者同时提醒,该反馈属单一用户主观感受,应作为用户情绪信号而非系统性评测来解读。最终结论是:用户需要的不只是更聪明的模型,而是一个愿意与自己站在同一边的伙伴。
Claude的"人格"回来了
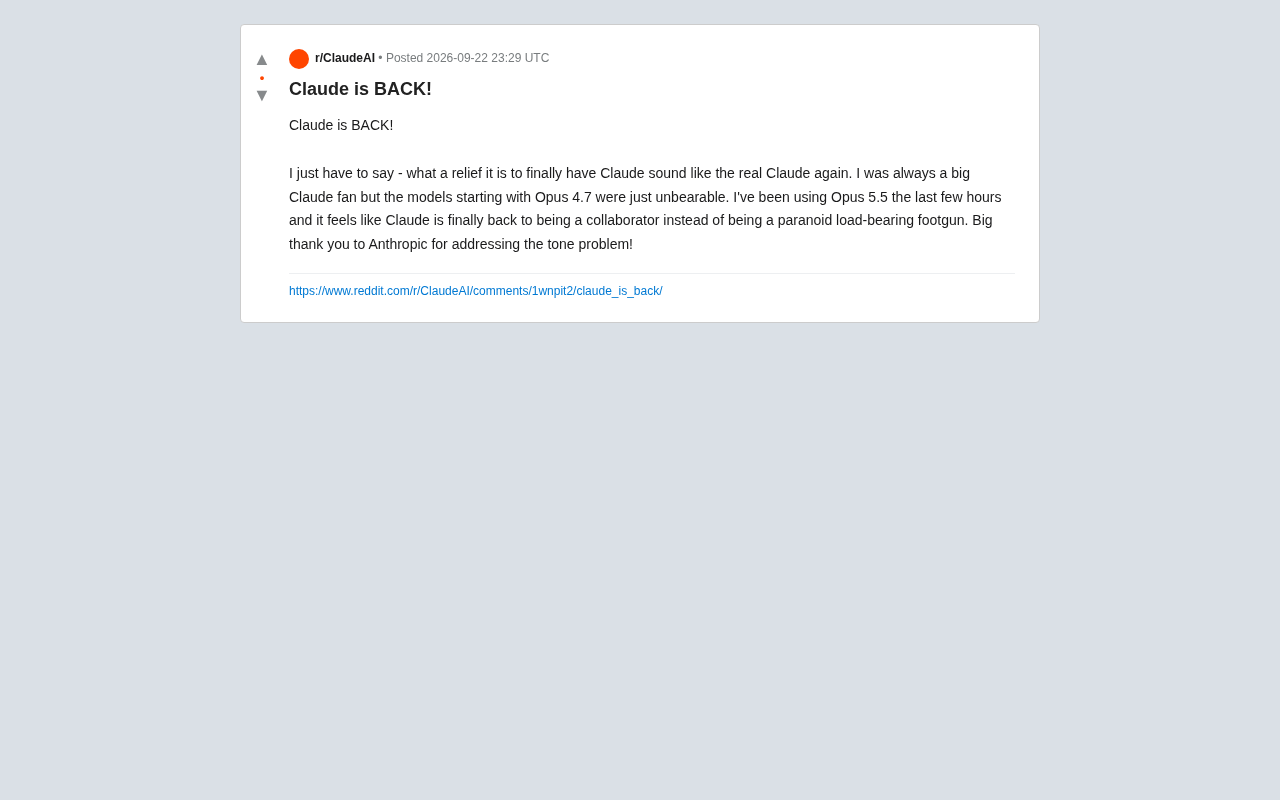
一位长期使用Claude的Reddit用户发帖表达了久违的欣慰之情,标题干脆利落地写着"Claude is BACK!"(Claude回来了)。这位自称一直是Claude忠实粉丝的用户坦言,从Opus 4.7开始的几个版本让他感到"难以忍受",而在使用了几个小时的Opus 5.5之后,他重新找回了熟悉的那个Claude。
这条帖子看似简短,却折射出大模型迭代中一个容易被忽视却极其关键的维度——模型的语气与人格一致性。用户明确指出,问题不在于模型的能力,而在于它的"性格"变了。
从"协作者"到"偏执的地雷"
原帖中最值得玩味的一句评价是:早期版本的Claude变成了"一个偏执的、承重的自伤工具(paranoid load-bearing footgun)",而不再是"协作者(collaborator)"。
这个略带戏谑的比喻,精准描述了不少用户对某些模型版本的共同不满:
- 过度谨慎(paranoid):模型频繁拒绝合理请求,对无害内容也反复设置安全护栏,让人感到被当成潜在威胁对待。
- 啰嗦与免责声明泛滥:动辄大段附加警告、限定条件,稀释了真正有价值的回答。
- 失去协作感:从一个能与用户并肩解决问题的伙伴,退化成一个处处提防、时刻可能"引爆"的工具。
这种体验落差对重度用户尤其明显。当一个工具的行为模式与用户建立起的信任预期出现偏移时,即使底层能力没有下降,主观体验也会大幅崩塌。
语气问题为何是真问题
在大模型的竞争中,业界往往把注意力集中在跑分、上下文长度、推理能力等硬指标上。但这条帖子提醒我们,交互语气(tone)本身就是产品体验的核心组成部分。
Anthropic一直以"有用、无害、诚实"作为Claude的对齐目标。然而对齐调优是一把双刃剑:安全性调得过紧,模型就会显得偏执、回避、说教;调得过松,又可能带来风险。如何在两者间找到平衡,是每一次版本迭代都要重新校准的难题。
原帖用户特别感谢Anthropic"解决了语气问题(addressing the tone problem)",这说明官方在Opus 5.5中做出了明确的调整方向——把模型重新拉回到更自然、更愿意协作的状态。对于依赖Claude进行日常创作、编程和思考的用户来说,这种回调的价值不亚于一次能力升级。
对齐调优(Alignment Tuning) 是指通过人类反馈强化学习(RLHF)、Constitutional AI等技术手段,让模型的输出更符合人类价值观和安全规范的过程。Anthropic在Claude上大量采用了自家提出的Constitutional AI方法——给模型预设一套"宪法原则",让其在生成回答时自我批评并修正违规内容。这套机制在提升安全性的同时,也容易让模型形成过度保守的"条件反射":只要检测到某些关键词或潜在敏感话题,就触发护栏逻辑,即便用户意图完全正当。业界将这种现象称为"对齐税"(alignment tax)——为了安全性付出的可用性代价。OpenAI的GPT-4在某些版本中也经历过类似的舆论反弹,说明这并非Anthropic独有的挑战,而是当前主流对齐方法在工程实践中普遍面临的张力。
单一用户反馈的参考边界
需要说明的是,这是一条来自单个Reddit用户的主观体验分享,并非系统性的评测数据。它反映了部分用户对Opus 5.5的正面感受,但不能代表所有使用场景下的表现。
不同用户对"好语气"的定义也存在差异:有人偏好直接高效,有人希望模型保持谨慎稳妥。因此这条反馈更适合作为用户情绪的信号来看待——它说明前几个版本确实存在被普遍感知的体验问题,而新版本在这一点上得到了至少一部分核心用户的认可。
给模型迭代的启示
这个案例对整个行业都有借鉴意义:
- 能力之外,人格一致性同样是留存关键。用户会与AI建立使用习惯和信任关系,突兀的"性格变化"会直接影响忠诚度。
- 过度对齐的副作用不容小觑。安全护栏必要,但当它开始干扰正常协作时,就成了体验负债。
- 倾听重度用户的声音。往往是最活跃的用户最先察觉细微的体验退化,也最愿意为改进发声。
Claude这次"回归",与其说是一次技术胜利,不如说是一次产品哲学的回调——重新认识到,用户想要的不只是一个更聪明的模型,而是一个更愿意与自己站在同一边的伙伴。
值得关注的是,"人格一致性"问题在AI产品中具有独特的复杂性。不同于传统软件版本迭代,用户对同一款AI助手往往会形成拟人化的使用预期——研究者将此称为"副社会关系"(parasocial relationship)。当模型在一次更新后突然变得更保守或更啰嗦,用户体验到的不只是功能退化,而更像是"老朋友变了"的情感落差。这也解释了为何这类反馈在社区中会引发强烈共鸣,而不仅仅是冷静的产品评价。对模型开发者而言,这意味着语气和人格层面的回归测试(regression testing)应当与性能基准测试享有同等地位,而非作为软性指标被忽视。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。