ClaudeMD:让AI代码助手遵守约定的配置文件

用版本控制的ClaudeMD文件为AI编程代理提供持久项目规则,解决代码不守规矩问题。
文章围绕AI编程助手常见的“不守规矩”现象,介绍在项目根目录放置ClaudeMD文件的做法:代理在每次会话启动时自动读取该文件,从而无需反复粘贴提示词即可获得项目规范。ClaudeMD适用于ClaudeCode、Cursor及任何接受该约定的代理,因纳入版本控制而可共享、重放和审计,本质上为AI提供了持久可复现的初始上下文,缓解上下文漂移。文章给出五步构建法:项目概览、命名规则、固定测试命令、语气详略、禁止模式与技能,并建议用stalemap自动更新依赖块、提交版本库并在新会话中测试验证。
为什么AI写的代码总是不守规矩?
用ClaudeCode、Cursor这类AI编程助手时,一个常见的困扰是:每次都要重复交代项目规范——命名风格、导入顺序、测试命令、禁止使用的模式。据YouTube视频《The File That Fixes AI Code》介绍,在项目根目录放一个ClaudeMD文件,就能让任何采用该约定的AI代理在会话开始时自动读取规则,无需额外提示词。
这个思路的核心是把"团队约定"从对话里搬到版本控制里:规则只写一次,所有人和所有AI代理共享同一份文件,行为保持一致。
ClaudeMD到底做了什么?
ClaudeMD放在项目根目录,代理在每个会话启动时读取它。它同时适用于ClaudeCode和Cursor,任何接受该约定的代理都能生效。因为文件纳入版本控制,规则可以被重放、审计和共享——团队成员复制粘贴提示词的做法,被替换成共享同一个文件。
这解决的其实是"上下文漂移"问题:AI每次对话都是白纸,而ClaudeMD给项目提供了一份持久、可复现的初始上下文。
“上下文漂移”(context drift)在这里指的是:大语言模型在每次新会话中都没有对项目历史决策的记忆,它会基于自身训练分布重新生成行为模式,导致同一项目在不同会话、不同成员、不同代理之间产出风格与约束不一致的代码。提示词方式的规则更容易漂移,因为提示词往往只存在于某人的对话记录或本地笔记中,无法被审计和复用。把规则固化为受版本控制的文件后,代理每次会话都以同一份初始上下文启动,相当于为模型提供了一个稳定、可复现的“系统提示”基线,从而显著降低行为随机性。这一机制与检索增强生成中的“固定上下文注入”思路相近,但更轻量、更可控。
五步构建生产级ClaudeMD
据视频建议,一份可用的ClaudeMD可以按以下步骤搭建:
- 先写项目概览:一行写明项目名称、技术栈和架构。
- 定命名规则:例如每行不超过50字符、禁止使用
any、规定导入顺序。 - 固定测试命令:把测试命令写进去,让代理直接运行。
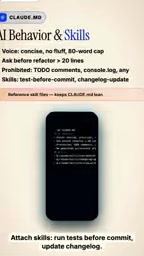
- 定义语气与详略:规定输出风格,并要求重构前先询问。
- 列出禁止模式:明确代理必须避免的"垃圾代码"套路,并附上技能,如提交前跑测试、更新变更日志。
此外,可以粘贴关键依赖和破坏性变更,或运行stalemap自动生成依赖块。规则素材也可以从awesome agent conventions和slop lists等社区资源中提取。
保持ClaudeMD常新的技巧
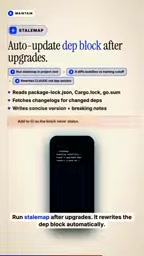
规则文件最大的敌人是过期。视频给出的做法是:升级依赖后运行stalemap,它会自动重写依赖块;然后把ClaudeMD提交到版本库,确保团队行为一致。借助AI context kit还能保持文件的可移植性。
要避开的陷阱包括:含糊的规则、过期的依赖信息、全局与项目规则冲突——这些都会让代理"失灵"。
依赖信息会过期,是规则文件失效的高发区。stalemap 这类工具的思路是:扫描项目的锁定文件(如 package-lock.json、poetry.lock)或清单文件(package.json、pyproject.toml),提取直接依赖、版本号与已知破坏性变更,再以结构化 Markdown 块的形式重写进 ClaudeMD 的依赖区段。这样代理在生成代码或建议升级时,看到的是与当前仓库真实状态一致的依赖信息,而不是模型训练时记忆的旧版本。手工维护依赖块通常难以持续,而自动重写可以把它纳入升级流程:升级依赖 → 运行 stalemap → 提交变更,三步形成闭环,避免规则与代码实际状态脱节。
落地清单
把ClaudeMD保存到项目根目录,文件结构依次为:头部、约定、AI规则、技能、依赖,然后提交。最后在新会话中测试,验证代理是否真正读取并遵守了规则。
视频预告的下一步,是一个能自动跑测试、读取失败信息并修补代码直到通过的ClaudeMD技能,省去手动复制粘贴的环节。对于重度使用AI编程的团队来说,把约定沉淀为文件,可能是提升代码一致性的最低成本手段。
相关推荐

Cloudflare开源AI代码安全审计工具,获6万星
Cloudflare开源Security Audit,为AI编码Agent提供免费安全审计。三步工作流:应用测绘、多Agent对抗找Bug、三级分类报告,源自内部漏洞狩猎系统,近6万星标。

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。