Claude写90%代码,谁来做Review?七层评审体系解密

Claude Code用七层自动筛子重构评审,PR翻倍而回滚率降四成。
Anthropic的Claude Code团队面对九成代码由AI生成、每日合入改动从2500涨到3万的压力,没有取消代码评审,而是把“一道门”改成“七层筛子”:PR前Agent自检与subagent独立review、AI Reviewer多agent投票过滤、独立安全review、常规CI、按风险分级的人工批准、Merge Queue复跑、feature flag与快速回滚兜底。同时他们还自研了Cyan版本控制系统以适配在线Agent与CI负载。针对agent互审产生的噪音与无限循环,团队限制轮数、去重意见、只报新改动,使一轮通过率从65%升至78%。人的价值被收缩到五件事:定方向、审高风险代码、审可复用架构、读证据、为结果负责。
当AI生成的代码占到九成,人工逐行Review几乎不可能。Anthropic的Claude Code团队没有取消评审,而是用七层"筛子"重构了整个流程,让PR数量翻倍的同时回滚率反而降了四成多。这套体系是怎么运转的?
背景:当代码多到人看不过来
Agent开始写代码后,改动数量涨得飞快。Anthropic的Monorepo里每天合入的改动,5月约2500个,到9月已超过3万个。Claude Code有自己的仓库不在这个Monorepo里,但压力一样大。按这个速度,再像以前那样一行一行人工Review几乎不可能。
压垮的还不只是Review,连Git都扛不住了。主分支历史将近100GB,CI每天大约要checkout 2500万次,按Git的方式直接拉取,每天要超过600PB的流量。问题的根源是Git的设计前提——它是分布式的,每一份克隆都是完整仓库,并且假设客户端会离线工作。可他们的客户端几乎全是在线的agent和CI任务。
于是一个7人团队用5个月自研了版本控制系统Cyan,还有Code Review工具Antique,把Monorepo整个迁了过去。基础设施比原来的Git镜像小了200倍,Checkout从几分钟变成几秒。
重新定义Review的目标
Claude Code团队认为,"有没有人读过这段代码"只是一个很粗糙的代理指标。真正该问的是:这个改动可能出什么问题,该由哪一道检查来抓,是自动检查还是人。
Review发生的时间点也应该前移——在开PR之前,而不是合并前的最后一道关口。
他们定下的目标是:大多数PR合并时,最多只有一个人参与,这个人还可以就是作者本人,同时回滚和事故不能变多。衡量看三个数:每个PR的人工批准次数、人工评论数、PR等人的时长。回滚率和事故率是护栏,一涨就说明时间只是换了个地方花。
原文有一个比喻:不是一道门,而是一层层的筛子。每一层都会漏掉一些问题,但很少有问题能同时穿过所有层,漏网的再靠快速回滚来兜底。
七层筛子:从开PR前到上线后
第一关:PR之前,让Agent自检
开PR之前,Claude要自己跑检查——测试、构建,或者一张和设计稿对比的截图,并且把输出拿出来,而不是只说一句"做完了"。然后开一个subagent,用全新的上下文review这次改动。很多人还会跑几个内部技能:一个找bug,一个精简改动,一个端到端检查行为。
Claude Code的创建者说过,Claude能验证自己的工作,大概是拿到好结果最重要的一件事,他估计这能让最终结果好两到三倍。
同一个问题反复被指出,就从源头修:写进技能、加一条lint规则,或者更新Cloud.md和review.md。Cloud.md写项目的技术栈、约定、目标和不做什么,每次review都会加载,所以要短。Review.md由代码负责人写,告诉reviewer这块代码里什么最重要,还会限制小毛病类意见的数量,要求每条意见拿出具体的文件和位置做证据。
Subagent(子代理) 是在主对话之外启动的独立Agent实例,拥有全新的上下文窗口,只接收本次任务所需的指令和文件,不继承主对话的历史。它的价值在于“视角隔离”:主Agent刚写完代码,上下文里全是自己的推理过程和设计意图,容易对自己的产出过度宽容;而一个没有这些包袱的subagent会像陌生reviewer一样重新阅读diff,更容易发现遗漏的边界条件、未处理的错误分支或与仓库其他部分的不一致。在Claude Code的流程里,subagent被用来专门做“自我review”这一步,输出结构化的发现列表,再由主Agent决定修改或说明理由。
第二关:AI Reviewer先过一遍
每个PR在人看之前,先过Claude的review,把改动放进整个仓库和PR的意图里看:问题解决没有、和系统合不合、有没有弄坏别处、修bug还要找根因。上线后,内部有实质性review意见的PR从16%升到了54%。超过1000行的大PR大多有发现,小PR大多干净。深度可以选quick、standard、deep三档。
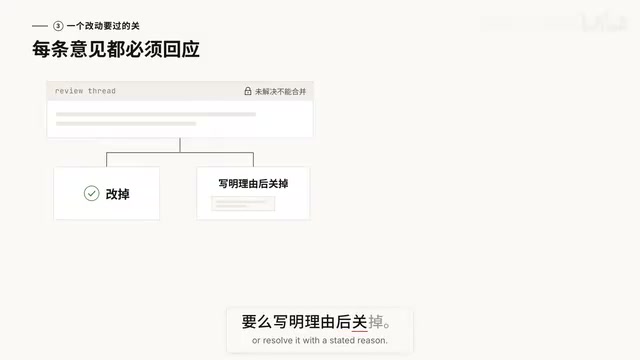
具体做法是几个agent同时找bug,再由另一组agent对每条发现投票,票数够了才发出来,只谈风格或清理的意见直接丢掉。这些过滤规则都做过AB测试。留下来的意见按严重程度标成important、小毛病、pre-existing三类,每条意见都必须回应,要么改掉,要么写明理由后关掉。
很多时候agent夜里就把修复做了,作者第二天回来,PR已经又过了一轮。
第三到第五关:安全检查、CI、人的批准
独立的安全review中,bug或安全意见只要有一条没关,PR就合不进去。常规CI、lint、类型检查、测试、构建一样不少,PR模板还要写清楚怎么测的、怎么撤回。
人的批准按风险分级。低风险改动(文档、文案、内部功能、藏在feature flag后面的新增功能),只要自动review和安全检查都通过,就不需要人。普通产品改动以及缓存、自动更新、系统提示词这类敏感区域,要一个人。最高风险的代码和少数指定路径,要两个人。单位看改动,不看作者,由分类器定档,第二个分类器判断要不要多一个人。负责人标为敏感的路径和所有CI工作流文件,永远要人。
还有几条硬规矩:只有信任名单上的作者能走轻量通道;agent的批准不能顶替人;指挥agent的人本身算一个reviewer;批准只对一个commit有效,有新commit就要重新批准。
Feature flag(功能开关) 是一种在代码中把新功能的启用与代码部署解耦的机制:代码可以已经合入main并部署到生产,但功能默认关闭,只有满足特定条件(内部用户、特定租户、一定比例流量)时才对外生效。它在这套评审体系里承担两个作用。第一,降低评审风险等级——藏在flag后面的新增功能即使有bug,也不会影响现有用户,因此可以走无需人工批准的轻量通道。第二,提供不回滚代码就能“关掉”问题的能力,出事时改一个配置即可止血,不必紧急回滚commit,这也是“快速回滚”这一层筛子的技术前提。
第六到第七关:Merge Queue与快速回滚
Merge Queue在最新的main上把检查再跑一遍,防止两个各自通过的PR合起来把main弄坏。新功能藏在feature flag后面,内部先用,公开时先发latest、后发stable。最后一关是快速发现、快速回滚:开关不用重新部署就能关掉。Claude Code有每周轮换的值班,事故复盘会追问本该有哪一层抓住它。他们也承认还缺一个熔断机制——回滚率一涨就自动收紧审批。
一位同事说,放慢速度确实能少出错,但主要是因为什么都做得少了,他们宁愿更快地发现和修复。
Merge Queue(合并队列) 解决的是“各自通过、合起来失败”的问题。CI通常只验证PR自身基于某个main快照的构建与测试,但两个PR单独都没问题,合并后可能因为改了同一个函数、同一个配置或语义冲突而让main变红。Merge Queue的做法是把待合并的PR排成队列,每次取队首的PR与当前最新的main合成一个临时分支,在这个合成结果上重新跑完整检查,通过才真正合入,否则退回给作者。这样main分支始终处于可构建、可测试的状态,代价是每个PR要多跑一轮CI。
控制噪音:Agent互相卷的代价
光抓得多不够,还要管噪音。团队看作者怎么回应每条意见:改了、说它错了、说是故意的,还是无所谓。他们还拿已知干净的PR去测,数一数会报出多少条可能诱导人做有害改动的意见。优先级很明确:先抓真bug,再减少review噪音。
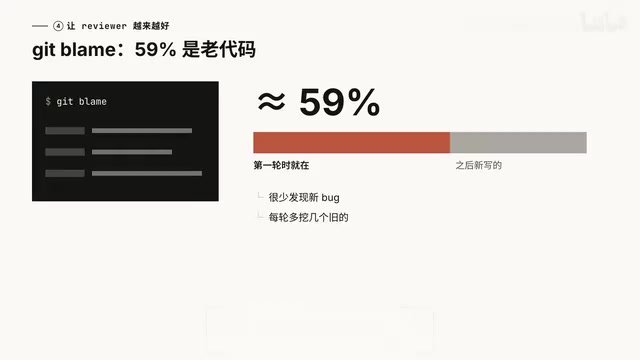
作者是agent时,噪音的代价更高。人看到一个无关紧要的小毛病几秒钟就略过了,agent却会老老实实去改,于是多一个commit,又多一轮review。agent写、agent审,还可能互相卷个没完。有一个命令行工具的PR,一夜之间来回review和修改了50多轮,最后是作者自己叫停的。用git blame一查,reviewer反复标出的代码中,大约59%在第一轮时就已经在那了——他很少找到新bug,只是每轮多挖出几个旧的。
现在他们把通过轮数和召回率一起看,并加了四条规则:三轮之后请作者重新想方案;之后只看新的改动;报一类bug而不是一行;提过的意见不再重复。效果很明显:一轮就通过的PR从65%升到78%,要五轮以上的从8.9%降到1.5%,平均review次数从2.08降到1.32。
召回率(recall) 在这里指reviewer真正找出的问题占全部实际存在问题的比例,与之相对的是精确率——报出的意见中有多少是真问题。只盯轮数会诱导团队把reviewer调得更宽松以尽快收敛,但宽松会漏bug,所以团队把“通过轮数”和“召回率”放在一起看:既要少来回,也不能靠牺牲发现能力换速度。用已知干净的PR测误报、用git blame核对意见是否指向本轮新引入的代码,都是为了让这两个指标可测量,避免优化一个而悄悄恶化另一个。
人还剩什么:五件只有人才能做好的事
把一位资深工程师从深度工作里拉出来,只为抓一个低级错误,成本远比一次自动review高。所以人要留在只有人才能做好的地方:
- 决定该不该做——方向、品位和范围。
- 审高风险代码——计费、自动更新和CI工作流。
- 审会被别人照着抄的架构。
- 读证据——测试输出、命令和返回、截图、reviewer的发现,说不清检查会漏掉什么,就要求一次真正的review。
- 为结果负责——每个上线的改动都有一个人负责。
团队怎么学代码:Review的第二个作用
机器读了大部分代码,人怎么学?想了解哪一块,就让Claude给那一块写一份讲解,几分钟就好,还和当前代码一致;有人还会让Claude做个小页面把那块代码画出来。一行文案的改动学不到什么,针对要改的模块的一份讲解能学到很多。
还有一条规范:你合进去的改动出了问题,通常你来修。它能成立,是因为改动小、随时能撤回,风险越大检查越多,回归暴露得快,而且不追责,复盘只看系统。
落地清单与方向
照着做的话:开PR之前给agent能自己跑的检查;写一份简短的Cloud.md,再加一个review.md;每个PR都接上AI reviewer和安全review;所有意见回应了才能合并;限制review轮数;批准按风险分级,认证、计费、CI和发布流程永远要人;bot的批准不能顶替人;合并之后用feature flag、分阶段发布和一键回滚;再把事故变成eval。
对外产品目前只给意见、不替人批准,但在自己的仓库里,低风险改动已经可以只靠自动检查合并,这条线还在往前移。目标一直没变:每个改动花更少的人工时间,回滚不比以前多。漏了什么,就把模型缺的信息补进Cloud.md。
相关推荐

Reddit帖子被删引发AI内容审核争议
Reddit一则帖子被平台以违反内容政策为由删除,页面仅显示移除提示。事件折射出AI内容审核系统在透明度、误判风险和申诉机制方面的普遍困境,值得内容平台与创作者关注。

DSH+Ollama本地部署大模型实战:免费对话大肥鱼
B站UP主实测DSH+Ollama本地部署大模型全流程:从Ollama安装、迅雷加速下载、魔搭GGUF模型导入,到DSH自定义API地址配置,并对比千问3.5 4B、8B、Gemma等模型在8G显存下的表现,给出本地部署与API调用的选择建议。

899元Mac Mini实测:能替代200美元AI订阅吗?
实测M4 Mac mini能否替代200美元AI订阅:16GB内存装不下大模型,速度与质量均有差距,但隐私、无上限和近零运行成本让它成为常驻智能体的理想宿主。附各配置选购建议与省钱策略。