CodeMidas:把现有代码变成编程智能体的训练任务

CodeMidas将现有代码仓库自动转化为RL训练所需的可执行任务、测试和验证器,绕过人工标注瓶颈。
训练编程AI智能体的核心难点是缺乏可执行、可验证的强化学习训练数据——人工标注的benchmark、issue和commit既昂贵又难以规模化。CodeMidas提出了一条不同路径:直接从现有代码仓库中提取行为,自动构造出编程任务、测试用例和奖励验证器,无需等待人工标注。其核心洞见是:代码天然具备可执行、可测试的属性,仓库中已有的函数、测试结构本身就是任务描述与正确性判定的天然来源。这一思路与SWE-bench等依赖人工筛选的benchmark不同,追求的是对任意合格仓库的批量自动化处理,将编程智能体的训练数据从稀缺资源转变为可规模扩展的流水线产出。
训练一个能自主写代码的AI智能体,最大的瓶颈往往不是模型本身,而是训练数据。高质量的可执行任务、测试用例和验证器难以获取——依赖人工标注的benchmark、精心挑选的issue和commit既昂贵又缓慢。CodeMidas提出了一条更务实的路线:直接把现有代码仓库的行为转化为可执行的训练任务。
为什么强化学习需要"可执行任务"
给编程智能体做强化学习(RL)训练,核心难点在于奖励信号的来源。模型生成一段代码后,系统必须能判断这段代码是对是错,才能给出反馈。这就要求每个训练任务都是可执行、可验证的——不仅有明确的问题描述,还要有能运行的测试和判定结果的验证器(verifier)。
传统做法通常依赖三类来源:人工标注的benchmark、开源仓库里的issue、以及历史commit记录。但这些数据要么数量有限,要么质量参差不齐,要么需要大量人力去清洗和标注。等待"完美的issue、commit或人工标签"意味着训练规模难以扩大。
强化学习在编程智能体上的应用通常借鉴自博弈类任务(如围棋、游戏)的成功经验:在那些场景里,规则明确、胜负清晰,奖励信号几乎是免费的。但编程任务的困难在于,「代码正确性」本身就难以定义——一段代码可能在某些输入下正确、另一些下崩溃,也可能功能正确但风格糟糕。因此,RL训练需要事先定义好「什么算完成」,而这正是verifier的职责:它是一段独立的判定程序,接受模型生成的代码和测试结果,输出一个确定性的奖励分数。没有高质量的verifier,RL训练就失去了方向——模型可能学会「通过测试」而非「真正解决问题」,即所谓的奖励黑客(reward hacking)现象。
CodeMidas的思路:代码本身就是任务源
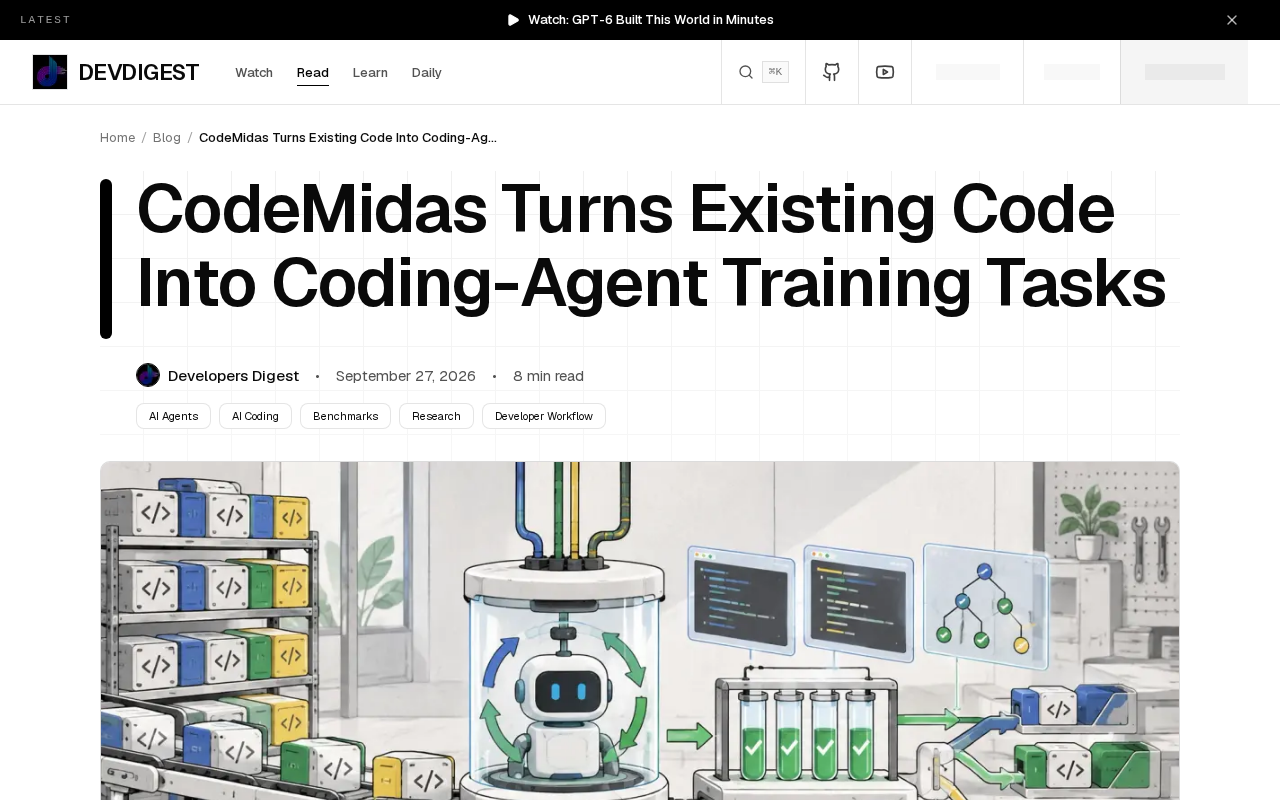
CodeMidas的关键洞见在于——现有代码仓库的行为本身就蕴含着大量可提取的任务。与其被动等待人工产出高质量标注,不如主动从仓库中"点石成金"(这也是Midas这个命名的含义所在),把已有的代码功能反向构造成训练任务。
具体而言,它将仓库中的实际行为转化为三样东西:
- 可执行任务(executable tasks):从现有功能抽取出明确的编程目标
- 测试(tests):用于运行和检验生成代码的行为是否符合预期
- 验证器(verifiers):自动判定任务是否完成,为RL提供奖励信号
这套流程的价值在于绕过了人工标注的瓶颈。任何一个具备完整功能和测试结构的仓库,理论上都能被批量转化为训练素材,从而让编程智能体的强化学习具备可扩展性。
从代码仓库中「反向构造」任务,在技术上属于程序综合(program synthesis)与测试驱动开发(TDD)思路的结合。具体来说,一个成熟的仓库往往已经包含函数签名、文档字符串(docstring)、单元测试和集成测试——这些本身就是任务描述与验证标准的天然载体。CodeMidas的做法类似于「遮住实现、保留规格」:把函数体抹去,以函数签名和已有测试作为任务输入,要求模型重新实现,再用原有测试判定对错。这与SWE-bench等benchmark的构造逻辑类似,但SWE-bench依赖人工筛选真实GitHub issue,规模受限;而CodeMidas追求的是对任意满足条件的仓库自动化批量处理,将数据生产从「瓶颈」变成「流水线」。
对编程智能体训练的意义
这一方法指向了一个更大的趋势:用自动化管线替代人工标注,来解决AI训练的数据规模问题。对于编程这个领域尤其合适,因为代码天然具备可执行、可测试的特性——运行结果本身就是最客观的对错判据,不需要主观打分。
换个角度看,CodeMidas试图把"海量现存代码"这一被低估的资源转化为训练燃料。开源生态中积累的数十亿行代码,如果都能被转化为结构化的任务、测试和验证器,编程智能体的训练数据将不再是稀缺资源。
需要说明的是,当前公开信息主要描述了这一方法的整体思路和价值主张,关于具体的实现细节、转化质量、以及在真实RL训练中的效果数据,还有待更多资料补充。但从方向上看,这是一条值得关注的、面向规模化的编程智能体训练路径。
小结
CodeMidas代表了一种数据获取范式的转变:不再等待完美的标注数据,而是从已有代码中主动构造可执行的训练任务。对于希望规模化训练编程智能体的团队来说,这种"把代码变成任务"的思路提供了一个绕过人工瓶颈的实用方案。
相关推荐

问责机制也能充满乐趣:重塑自律与团队协作的新思路
问责机制常被视为压力与惩罚的代名词,但它其实可以充满乐趣。本文探讨如何通过同伴支持、进展可见化和庆祝小胜利,将问责重构为推动个人成长与团队协作的愉悦力量。

Claude Code 入门:读懂它是什么与多端用法
Anthropic 团队成员 Lydia 主讲的 Claude Code 入门分享:它不只是 CLI,而是可在终端、IDE、浏览器和桌面端运行的 AI Agent。本文梳理其本质定位、多端用法与学习路径。

OpenWiki 该不该收录 PRD 等叙事文档?取舍分析
在为项目构建 OpenWiki 时,是否该收录 PRD、设计、愿景等叙事文档?本文分析代码与叙事文档的本质差异、收录的收益与风险,并给出按成熟度筛选、标注时效、以代码为事实源等实用决策建议。