Codex+Obsidian+Zotero:AI自动精读论文工作流
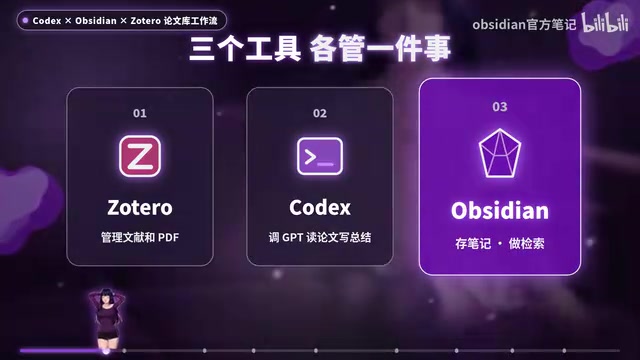
用Zotero、Codex、Obsidian三件套串起论文精读与对话式检索的自动化工作流。
文章介绍B站UP主分享的一套论文管理与检索系统,核心是用三个工具各司其职:Zotero管理文献和PDF,Codex调用GPT完成精读与总结,Obsidian保存结构化笔记并支撑检索。三者通过两个Codex Skill和一套Obsidian精读模板衔接。精读模板的Front Matter属性区(年份、期刊、研究任务、方法、数据集)决定检索效果,填写越详细,DataView检索越方便。处理论文时三个Skill接力完成元数据抓取、全文阅读和笔记生成;检索阶段安装DataView插件自动生成索引页,之后即可在Codex中直接向论文库提问并获得带出处的结论。文章也指出其适用边界:适合已有论文积累、需写综述的研究者,结论准确性依赖模板质量与全文回查,建议保持核对习惯。
论文越存越多,真要写综述的时候却想不起哪篇讲了什么——这是不少科研人的日常困境。B站UP主分享了一套自己在用的论文管理与检索系统,核心思路是用三个工具各司其职:Zotero管文献和PDF,Codex调用GPT读论文写总结,Obsidian保存笔记并支撑后续检索。三个工具串起来之后,可以直接和自己的论文库对话,让AI基于读过的论文给出结论和总结。
三工具分工:Zotero管文献、Codex读论文、Obsidian存笔记
这套工作流把论文处理拆成三大块:准备、处理论文、检索对话。Zotero负责文献管理和PDF存放,Codex负责调用GPT完成精读和总结,Obsidian负责笔记归档与检索。三者之间通过两个Codex Skill和一套Obsidian精读模板衔接。
据UP主介绍,准备工作分两步:先从GitHub下载两个skill——Zotero Analytical Workflow Skills负责把论文从Zotero导进Obsidian并生成精读笔记,Research the Jouvel Literature Retrieval负责后续在论文库中做检索;将仓库克隆进Codex的Skills文件夹后,Codex即可识别调用。
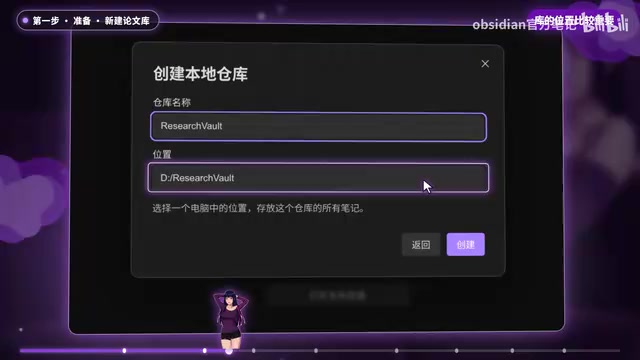
第二步是在Obsidian新建一个专门放论文的库,UP主命名为Research Vault。这个库的位置比较关键,因为后续的论文库就建在这里。库里主要放两样东西:所有论文笔记,以及处理论文时要用的精读模板。
Codex Skill 是什么
Skill 是 Codex(OpenAI 的编码智能体)中可被调用的能力模块,本质是一组预置的指令、脚本与工作流定义。用户把 Skill 仓库克隆到 Codex 的 Skills 文件夹后,Codex 就能在对话中识别并调用对应能力,按预设步骤完成多步任务。本工作流正是依靠两个 Skill 把「导出论文—读全文—套模板写笔记」和「在笔记库中检索」这两类操作固化下来,使一句「精读这一篇」能触发完整的流水线,而无需每次手动描述步骤。
Obsidian 与 Front Matter
Obsidian 是基于本地 Markdown 文件的笔记工具,每篇笔记就是一个 .md 文件。Front Matter 指文件开头由 --- 包裹的 YAML 元数据区,可存放年份、期刊、方法等结构化字段。它的价值在于把非结构化的笔记正文与可被程序读取的标签分离,DataView 这类插件正是通过解析 Front Matter 来建立索引、按字段筛选和聚合笔记,因此属性区填写得越规范,检索就越精确。
精读模板是检索效果的关键
精读模板决定了每篇论文会被整理成什么样,模板里的分析框架可以换成自己研究方向的内容。最重要的部分是模板开头的笔记属性区(Front Matter),这里写的是适合检索的设定,比如年份、期刊、研究任务、方法和数据集。UP主特别提醒,设定写得越详细,后面用DataView检索起来就越方便。
这一设计的逻辑在于:AI精读的产出不是一篇自由格式的读后感,而是结构化笔记。属性区字段相当于给每篇论文打了可检索的标签,检索时不必依赖全文模糊匹配,而是能按字段精确定位。模板的详细程度直接决定了论文库的可查询性。
处理论文:三个Skill接力完成精读
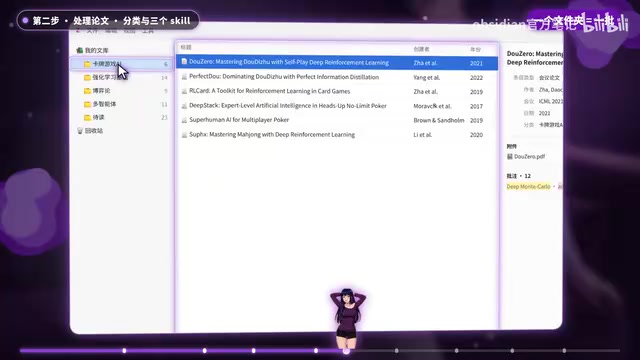
处理论文时,UP主习惯在Zotero里先按主题分好文件夹,一个文件夹一批来处理。Codex这边用到的是Zotero Analytical Workflow Skills,其中包含三个Skill:Collection Manager负责调度整个流程,Retata Factor负责抓取每篇论文的元数据和批注,Analytical Writer负责按模板写出精读笔记。
具体操作上,要精读Zotero里的某一篇论文,直接在Codex里说"精读这一篇"即可。Codex会按照整个工作流一步步处理:抓元数据、读全文、套模板、写笔记。UP主提到Codex思考的过程有点长,视频里做了剪辑。处理完成后打开Obsidian,就能看到这几篇论文已经整理进库里。
检索对话:用DataView建索引,向论文库提问
所有论文处理完之后,下一步是在Obsidian里做检索,需要安装一个叫DataView的插件。如果还没装,先在设置里关闭安全模式,再打开社区插件市场搜索DataView安装。装好之后确认它是启用状态,它会提取每篇论文笔记的属性区,自动生成索引页。
以上都完成之后,就可以在Codex里打开论文库文件夹和它对话。UP主演示的问题是"针对卡牌类游戏的机器学习方法有哪些",Codex会先从笔记里定位相关论文,需要时再回到全文核对,很快给出结论。据UP主评价,每一条结论都能对应到具体论文内容,准确性基本可信。
这一环节的价值在于把"翻论文"变成了"问论文库"。传统综述写作中,研究者需要逐篇重读摘要和结论;而这套流程下,AI先基于结构化笔记做初筛,再按需回查全文,相当于把综述初稿的素材整理工作前置了。
DataView 插件的作用机制
DataView 是 Obsidian 的社区插件,用于把笔记中的 Front Matter 当作数据库字段来查询和渲染。它支持类似 SQL 的查询语法(如按 year、method 字段过滤,或列出某期刊下的全部论文),并把结果以表格、列表等形式动态生成在笔记中。在本工作流里,它承担「索引层」的角色:把散落在各篇精读笔记里的属性区汇总成可浏览、可筛选的索引页,使论文库具备结构化查询能力,而不必依赖全文关键词匹配。安装社区插件需先在设置中关闭安全模式( Restricted Mode ),这是 Obsidian 对第三方插件的默认保护机制。
这套工作流的适用边界
从UP主的演示看,这套三件套的核心贡献是把论文管理、精读笔记和检索问答串成了一条流水线,两个Skill加一个精读模板就是全部粘合剂。它适合已经有相当数量论文积累、需要写综述或做文献回顾的研究者。
需要留意的是,检索结论的准确性依赖精读模板属性区的填写质量,以及Codex回查全文的环节;UP主的验证方式是抽查结论与论文内容的对应关系,这也提示使用者对AI给出的结论保持核对习惯,而不是直接采信。
总结一下:Zotero管文献,Obsidian存笔记,Codex读论文库帮写结论。对于被"读不完的论文"困扰的科研党,这套组合提供了一条可复制的自动化路径。
相关推荐
Replit亮相Web Summit里斯本:AI编程平台加速欧洲布局
Replit以Replit Live形式参与Web Summit里斯本2026 Day 1,本文梳理其从在线IDE向AI应用构建平台转型的路径,并分析其欧洲市场机会与合规挑战。
Codex接入Zotero:批量综述与精读工具实测
实测Codex接入Zotero的两个新功能:基于分类批量生成文献综述,以及筛选重点论文做深度精读。详解综述的对照表与引用核查、精读的方法与实验分析三层结构,附完整工作流与使用建议。
被忽视的真相:医生曾认为黑人不会得糖尿病
一百年前美国医生普遍认为黑人不会得糖尿病,糖尿病被贴上"富贵病"标签。Vox节目Khalil Explains梳理这段历史,并揭示黑人患者至今在GLP-1药物获取上仍存在约20%的差距。