Codex接入Zotero:批量综述与精读工具实测
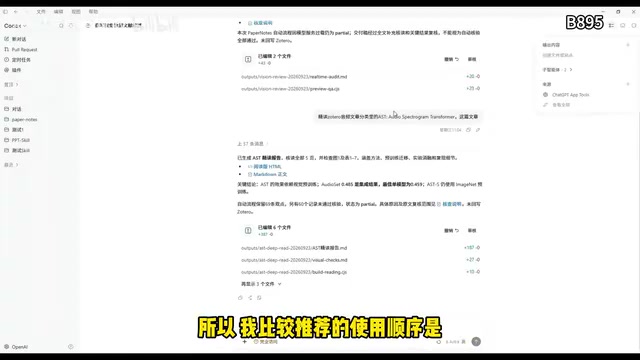
用Codex的Skill机制为Zotero文献库加上批量综述与单篇精读两个功能。
文章介绍UP主基于Codex的Skill机制开发并测试的两个文献处理功能:一是按Zotero分类批量读取PDF,先为每篇生成简读卡片,再组织成含研究问题、核心方法、实验结果与局限的综述卡片和跨论文对照表;二是对选定单篇做深度精读,从技术路线、实验解释、局限与后续追问三层展开。作者强调综述只使用库内现有文献以保证可追溯,对照表用于定位可比较对象而非自动排名,精读需区分作者自述局限与模型推断。推荐工作流为Zotero分类整理→综述建立整体认识→筛选重点→批量精读→回原文核查,工具负责压缩信息,判断仍由人完成。
文献越囤越多,真正读完的却没几篇——这是很多研究生的共同困境。上一期我们解决了论文检索、下载和入库Zotero的问题,这一期UP主继续开发并测试了两个新功能:基于Zotero分类批量生成文献综述,以及从文献中筛选重点文章做深度精读。两个功能都通过Codex的Skill机制调用,配合Zotero现有文献库使用。
综述与精读:两种场景,两种工具
在动手之前,先理清两个功能的定位差异。综述适合刚进入一个研究方向时使用:你想知道这批文章各自做了什么、方法之间是什么关系、有哪些共通问题、下一步值得重点看哪几篇。精读则针对已经选定的一篇文章,目的是弄清楚它的方法具体怎么工作、实验怎么设计、结果到底支持什么结论,以及自己能不能借鉴。
UP主推荐的使用顺序是:先用综述建立对这批文献的整体认识,再把时间投入到最相关的论文上做精读。这个顺序符合认知规律——先见森林,再见树木。
综述功能实测:从PDF到结构化卡片
流程与限制
使用前需要确认Zotero对应分类下已有文献。调用Skill时可以给出更具体的指令,比如读哪个分类、围绕什么问题、结果怎么组织。UP主特别强调了一个限制:只能使用Zotero里现有的文献。这个约束保证了综述的可追溯性,避免模型凭空引入外部内容。
整个流程是:先读取PDF,为每篇文章整理简读卡片,再把这些材料组织成综述卡片,主要保留研究问题、核心方法、关键实验结果和局限。这样做的价值在于,不同论文被放在同一套问题框架下比较,而不是各说各话。
Zotero 是一款开源文献管理工具,核心能力是按分类(Collection)组织条目、抓取 PDF 元数据并生成引用。文章所说的“Zotero 分类”对应其集合结构,一个集合下可以挂多篇文献及其附件。“只能使用 Zotero 里现有的文献”这一约束,本质是把模型的可访问范围限定在本地库中,模型不联网检索、不凭空补全,因此综述中出现的每条判断都能对应到库内可打开的原文件,核查成本大幅降低。
Codex 的 Skill 机制可以理解为预先封装好的一段可复用指令与脚本组合:用户用自然语言描述任务(读哪个分类、围绕什么问题、结果怎么组织),Skill 负责调度读取 PDF、分篇处理、汇总输出等步骤。把流程固化成 Skill 而不是每次手写提示词,好处是处理规则统一、多篇文献之间格式一致,也便于后续调整模板。
覆盖情况与对照表
结果出来后,第一眼要看的是这批文章的覆盖情况:实际处理了哪些、哪些未完成、哪些留待未来研究。然后看对照表,它能快速定位每篇文章关注什么问题、用了什么方法、在哪些条件下做实验。
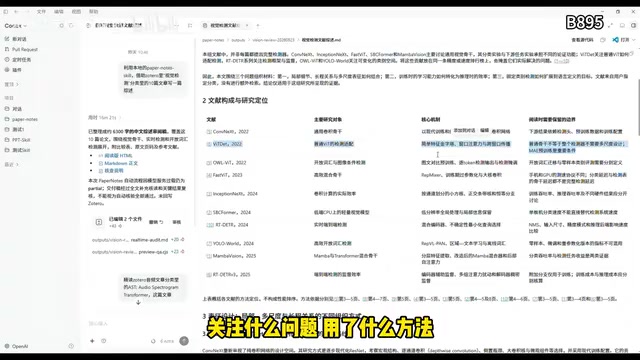
UP主对这个对照表的定位很清醒:它的价值是帮你找到值得进一步比较的对象,而不是自动排出一个谁最好谁最差的榜单。学术评价需要上下文,自动排名容易误导。
简读卡片与综述卡片是两级不同的产物。简读卡片针对单篇文献,相当于一份结构化读书笔记,抽出研究问题、核心方法、关键实验和局限;综述卡片则是在多张简读卡片之上再做一次横向归纳,把不同论文放进同一套问题框架里对照。两级结构的意义在于:单篇信息先被压缩成可比较的字段,横向比较才不会退化成摘要堆叠。
对照表本质是一张矩阵,行是文献、列是问题/方法/实验条件等维度,单元格填该文献在对应维度上的取值。矩阵的价值在于暴露空白与重叠——哪些问题被多篇文献共同关注、哪些方法组合尚无人尝试。它服务于“下一步该比较什么”的决策,而不是给出优劣排序,因为跨论文的评分标准往往并不统一。
正文组织与引用核查
按主题组织的正文部分,UP主关注的是它有没有把几篇论文联系起来。实测中,模型确实做了归纳,观点来自不同文章,每条关键判断都有对应来源。回到原文核查时,某段关于卷积神经网络架构组织的描述确实得到了原文支持。
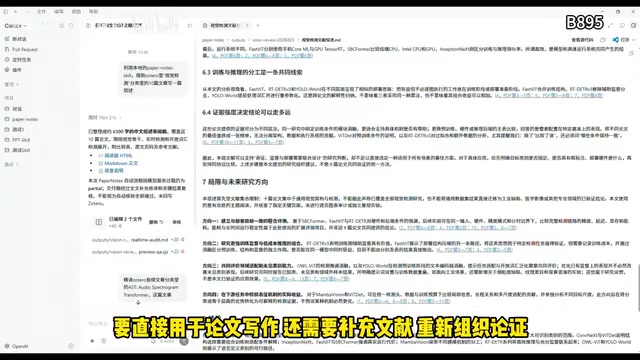
最后要看它有没有明确列出实验结论、实验条件和未来研究。实验结论应该是有前提的,未来研究也应该有依据。UP主对这份综述的定位是:适合进入新课题、准备组会或筛选下一步要精读的文章;如果要直接用于论文写作,还需要补充文献、重新组织论证并逐条核查关键引用。
精读功能实测:方法、实验与局限三层展开
精读的目标是把单篇文章展开到足够具体的程度。查看分析报告时,UP主关注三个重点。
方法部分是否讲清技术路线
要看它能否清楚说明输入是什么、经过哪些关键步骤、每一步解决什么问题、最后得到什么结果。如果只是重复摘要、罗列几个方法名称,对真正理解论文的帮助就很有限。好的精读应该能画出技术路线图,而不只是贴标签。
实验解释而非数字搬运
第二个重点是看它能不能解释实验,而不只是把实验数字抄过来。UP主会追问三个问题:作者用什么实验检验自己的方法?结果支持了哪一部分判断?又有哪些结论不能从这个实验直接推出?
如果要复现,训练数据、评价协议、监督方式这些条件也很重要。少看一个条件就可能误解文章的结果。
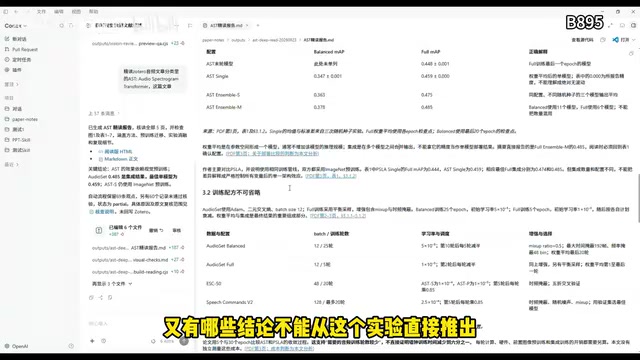
复现一篇论文时,训练数据、评价协议和监督方式这三项条件决定了结果能否被公平比较。训练数据涉及规模、来源与划分方式;评价协议指用什么指标、在什么测试集上、按什么规则计算;监督方式则区分全监督、弱监督、自监督等设定。同一方法换一套协议,数字可能差别很大,所以精读报告若不交代这些条件,读者就容易把不可比的数字直接并列。
判断“结果支持什么结论”时,需要区分实验直接验证的命题与外推得到的推论。消融实验通常支撑某个模块的必要性,对比实验支撑相对优势,但两者一般都不能直接推出方法在分布外数据上的泛化能力。精读时把这一层边界讲清楚,比复述准确率数字更有价值。
局限与后续追问
第三个部分是局限和后续值得追问的问题。这里要区分两种情况:作者自己承认的局限,以及根据当前证据提出的分析。前者是原文信息,后者是模型的推断,使用时要心里有数。
对于多篇文章,可以按分类发起批量精读。它的目标是逐篇生成独立报告,再通过索引统一查看。和综述的用途仍然不同:综述帮你看文章之间的关系,批量精读把每篇文章分别展开,所以通常需要投入更多处理时间。UP主建议优先把它用在已经筛选过的重点文献上,而不是全库无差别跑一遍。
完整工作流与使用建议
结合上一期的内容,这套流程可以串起来了:先检索和下载文献,在Zotero里按研究主题整理好;然后用综述了解这批文章的整体图景,筛出重点;最后对重点文章做精读,并回到原文核查关键内容。
UP主的期望是减少重复整理材料的时间,把更多精力放在理解方法、判断证据和思考自己的研究问题上。这个定位比较务实——工具负责压缩信息,判断仍然在人。需要教程和Skill配置的可以在评论区获取。
从更广的视角看,这类工具的价值不在于替代阅读,而在于帮你决定读什么、先读哪里、读的时候盯住哪些问题。综述负责建立地图,精读负责深入据点,两者配合才能让文献库真正变成研究生产力。
相关推荐
Replit亮相Web Summit里斯本:AI编程平台加速欧洲布局
Replit以Replit Live形式参与Web Summit里斯本2026 Day 1,本文梳理其从在线IDE向AI应用构建平台转型的路径,并分析其欧洲市场机会与合规挑战。
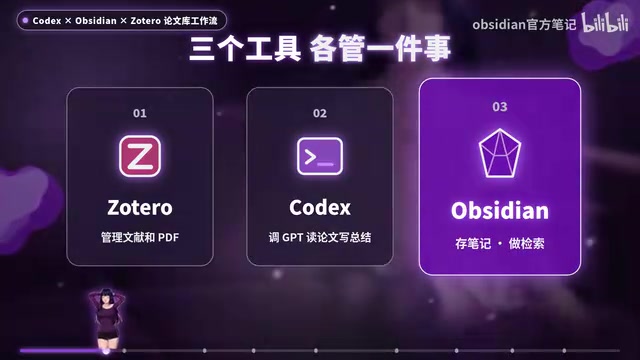
Codex+Obsidian+Zotero:AI自动精读论文工作流
分享一套Codex+Obsidian+Zotero论文管理检索工作流:Zotero管文献、Codex调用GPT自动精读并写笔记、Obsidian配合DataView建索引,实现向论文库提问、快速生成综述素材,附精读模板与两个Skill的配置步骤。
被忽视的真相:医生曾认为黑人不会得糖尿病
一百年前美国医生普遍认为黑人不会得糖尿病,糖尿病被贴上"富贵病"标签。Vox节目Khalil Explains梳理这段历史,并揭示黑人患者至今在GLP-1药物获取上仍存在约20%的差距。