从1块3090到20台DGX Spark:本地大模型玩家的硬件进化史
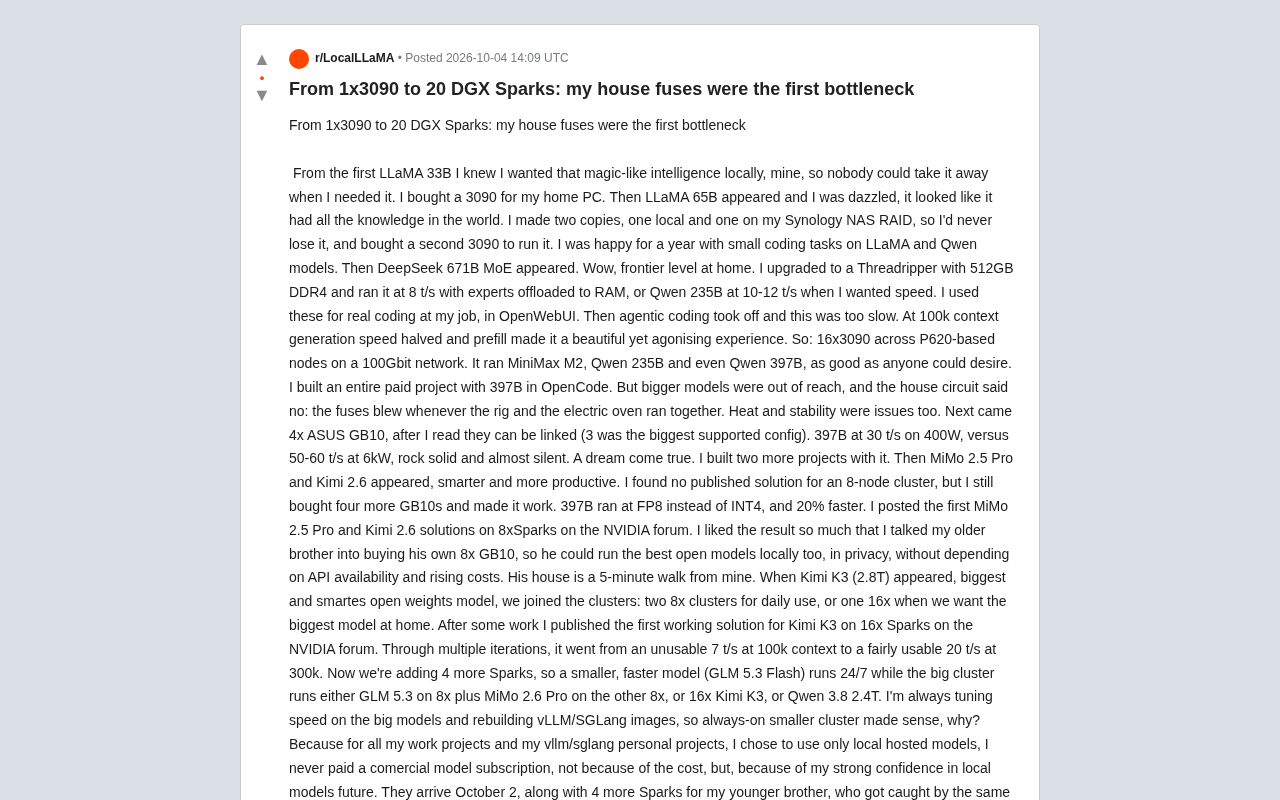
一位开发者从1块3090扩展到20台DGX Spark,亲历本地大模型推理的每一层工程瓶颈。
这篇文章记录了一位开发者从购入第一块RTX 3090开始、历时数年将家庭本地AI推理系统扩展至20台DGX Spark(GB10)的完整历程。他的核心驱动力是对模型掌控权的执念——不依赖任何商业API。随着模型规模从LLaMA 65B扩展到2.8万亿参数的Kimi K3,瓶颈依次从单卡显存、系统内存(MoE卸载),迁移到长上下文下的速度衰减、多卡功耗,最终撞上家庭电路保险丝(16块3090满载约6kW)。转向低功耗统一内存架构的DGX Spark后,397B模型以400W实现30 token/s,并通过自建8节点、16节点集群跑通了官方未支持的配置,在300k上下文下将Kimi K3的速度从7 token/s优化到20 token/s。文章清晰揭示了家庭级前沿模型部署的阶段性工程约束,以及低功耗专用推理设备正在成为更可持续路线的趋势。
一场始于LLaMA的本地AI执念
当第一代LLaMA 33B问世时,一位Reddit用户被这种"近乎魔法般的智能"深深吸引。对他而言,关键不在于性能本身,而在于掌控权——他想要一个完全属于自己、无法被任何人收回的本地智能。于是他为家用PC买下了第一块RTX 3090,由此踏上了一条颇为极致的本地部署之路。
这个故事之所以值得记录,不仅因为它展示了消费级玩家如何在家中运行万亿参数级别的前沿开源模型,更因为它真实呈现了本地大模型推理在扩展过程中遇到的工程瓶颈:从显存、内存,到网络带宽,最终撞上了最朴素的物理限制——家里的电路保险丝。
显存与内存的层层加码
LLaMA 65B的出现让他震撼,"看起来仿佛拥有了世界上所有的知识"。为了永不丢失这份模型权重,他甚至做了两份拷贝:一份本地,一份存在群晖NAS的RAID阵列上,并添置了第二块3090来运行。
接下来的一年里,他用LLaMA和Qwen处理日常编码任务,相当满足。真正的转折点是DeepSeek广告 671B MoE的登场——"家里就能跑前沿级别的模型"。为此他升级到Threadripper平台,配备512GB DDR4内存,通过将专家层卸载到内存,以约8 token/s的速度运行671B,或在追求速度时让Qwen 235B跑到10-12 token/s。这些模型被他实际用于工作中的编码任务,运行在OpenWebUI上。
这一阶段揭示了MoE模型在本地部署的典型策略:用大容量内存承接部分专家权重,以牺牲速度换取能跑大模型的可能性。
当agentic编码遇上速度墙
随着agentic coding(智能体编码)兴起,纯内存卸载的速度变得难以忍受。他指出一个关键痛点:在100k上下文长度下,生成速度直接减半,而prefill(预填充)阶段更是让体验"美丽却煎熬"。
长上下文下的性能衰减,是本地推理用户普遍会撞上的现实。为此他祭出了重手笔:16块3090,分布在基于联想P620的多个节点上,通过100Gbit网络互联。这套系统能跑MiniMax M2、Qwen 235B,甚至Qwen 397B,"达到任何人所能期望的水平"。他用397B在OpenCode中完成了一个完整的付费项目。
Prefill与Decode的性能差异
LLM推理分为两个阶段:prefill(预填充)和decode(逐token生成)。Prefill阶段需要一次性处理所有输入token,计算量与上下文长度成平方关系,因此在100k这样的长上下文下,prefill耗时会极为显著——用户提交请求后往往需要等待数十秒才能看到第一个输出token。Decode阶段则是逐token自回归生成,速度受显存带宽限制而非算力,在内存卸载场景下,每生成一个token都需要从CPU内存向GPU搬运对应的KV Cache和权重,往返带宽成为硬瓶颈。长上下文时KV Cache体积同样随长度线性增长,进一步压缩了可用显存,导致生成速度在长文本场景下相比短文本可能下降50%以上,这正是作者所描述的"100k上下文下速度减半"的工程根源。
真正的第一个瓶颈:家里的保险丝
然而更大的模型仍然遥不可及,而真正叫停扩张的不是算法也不是预算,而是家里的电路:"每当这套设备和电烤箱同时运行时,保险丝就会跳闸。"散热与稳定性同样成了问题。
这是整个故事最具画面感也最真实的一幕——16块3090在推理时的功耗高达约6kW,消费级住宅的供电根本无法承载。本地AI的尽头,有时竟是家庭电气规格。
转向DGX Spark:功耗与噪音的降维
转机来自NVIDIA的GB10(DGX Spark)。他读到这些设备可以互联后,入手了4台ASUS GB10(当时官方支持的最大配置是3台)。结果令人惊艳:397B模型以30 token/s运行,功耗仅400W——对比此前6kW下的50-60 token/s,新方案稳如磐石且几乎无声。
"397B at 30 t/s on 400W, versus 50-60 t/s at 6kW, rock solid and almost silent. A dream come true."
从6kW降到400W、从嘈杂降到静音,这种能效比的跃升正是统一内存架构(如GB10的Grace-Blackwell超级芯片)对大模型本地推理的价值所在。他随后又用这套系统完成了两个项目。
统一内存架构(UMA)与传统GPU方案的本质差异
DGX Spark(GB10)采用Grace-Blackwell超级芯片,其核心优势在于统一内存架构(Unified Memory Architecture):CPU与GPU共享同一块物理内存池(最高达288GB),带宽高达900GB/s,而无需经过PCIe总线在两者之间搬运数据。传统多卡方案中,模型权重分布在多块GPU显存与主机DDR之间,PCIe带宽(Gen4 x16约64GB/s)往往成为内存卸载场景的硬瓶颈;而GB10的片上高带宽内存使所有权重都处于同等高速访问距离。这解释了为何仅用4台GB10(总功耗400W)就能达到接近16块3090(6kW)六成以上的吞吐量——能效比的提升并非来自"更便宜的芯片",而是架构层面消除了跨总线的内存搬运损耗。
突破官方限制:8节点与16节点集群
随着MiMo 2.5 Pro和Kimi 2.6等更聪明的模型出现,他继续扩张。尽管找不到任何8节点集群的公开方案,他依然又买了4台GB10并自行跑通——397B得以用FP8(而非INT4)运行,速度还快了20%。他把MiMo 2.5 Pro和Kimi 2.6在8台Spark上的首个方案发布到了NVIDIA论坛。
更有意思的是社交层面的扩散:他说服了住在步行5分钟外的哥哥也买了一套8x GB10。当2.8万亿参数的Kimi K3问世时,兄弟俩把两个8节点集群合并——日常用两个独立的8x,想跑最大模型时就合成一个16x。他随后发布了Kimi K3在16台Spark上的首个可用方案,经过多轮迭代,性能从100k上下文下不可用的7 token/s,优化到300k上下文下相当可用的20 token/s。
vLLM与SGLang在多节点推理中的角色
vLLM和SGLang是目前主流的开源LLM推理引擎,均支持通过张量并行(Tensor Parallelism)和流水线并行(Pipeline Parallelism)将单个模型切分到多个GPU或多个节点上运行。在多节点Spark集群场景下,推理引擎负责协调各节点间的KV Cache同步、注意力计算切分以及专家路由(针对MoE模型),节点间通信延迟直接影响最终吞吐量。作者提到需要频繁"重建vLLM/SGLang镜像",正是因为多节点、超长上下文、非官方节点数量等边界场景往往需要针对性的配置调优甚至代码修改,社区对8节点以上Spark集群的支持在当时几乎是空白,这也是他将首个可用方案发布到NVIDIA论坛具有实际参考价值的原因。
为什么坚持纯本地?
他们正准备再加4台Spark,让较小较快的GLM 5.3 Flash做到7×24小时常驻运行,而大集群则在GLM 5.3、MiMo 2.6 Pro、16x的Kimi K3或Qwen 3.8(2.4T)之间切换。常开小集群的意义在于:他总在为大模型调优速度、重建vLLM/SGLang镜像,需要一个始终在线的服务。
最值得玩味的是他的理念表白:所有工作项目和个人的vLLM/SGLang项目,他只用本地托管模型,从未付费订阅任何商业模型。原因不是成本,而是"对本地模型未来的强烈信心"——不依赖API可用性,也不受上涨费用的制约。
故事的结尾带着一丝幽默:连他的弟弟也染上了"同样的本地AI病毒",新一批设备正等着交付。
这个案例给本地AI玩家的启示
这段从1块3090到20台DGX Spark的旅程,本质上是一部本地大模型工程的瓶颈迁移史。它清晰地展示了几个阶段性约束:单卡显存 → 系统内存(MoE卸载)→ 长上下文性能 → 多卡功耗与散热 → 节点互联方案的缺失。
对于希望在家运行前沿开源模型的人来说,这个案例最实际的价值在于指出:当GPU数量堆到十几块时,电力和散热往往会先于预算成为天花板;而统一内存、低功耗的专用推理设备,正在成为家庭级大模型部署更可持续的路线。
背景补充
MoE(混合专家)模型的工作机制
MoE(Mixture of Experts)是一种稀疏激活的模型架构。以DeepSeek 671B为例,模型虽有6710亿参数,但每次推理时仅激活其中一小部分"专家"子网络(通常不足总参数量的20%),因此实际计算量远低于同等参数量的密集模型。这一特性使MoE模型在推理时呈现出"存储需求大、计算量相对小"的不对称性——权重必须全部加载,但每个token只用到其中一部分。这为CPU内存卸载创造了可行空间:将不常用的专家权重存放在大容量DDR内存中,按需换入GPU显存,以数倍的访问延迟换取在消费级硬件上运行超大模型的可能。512GB DDR4内存正是为容纳这些"冷专家"权重而配置的。
相关推荐
用Python从零构建动量算法交易系统:Massive、SnapTrade与Alpaca实战
跟随这门 Python 实战课程,从零构建动量算法交易系统:用 Massive 拉取行情、SnapTrade 连接券商、Alpaca 纸面账户执行交易,基于 12 减 1 动量策略自动生成信号,全程无需真实资金。
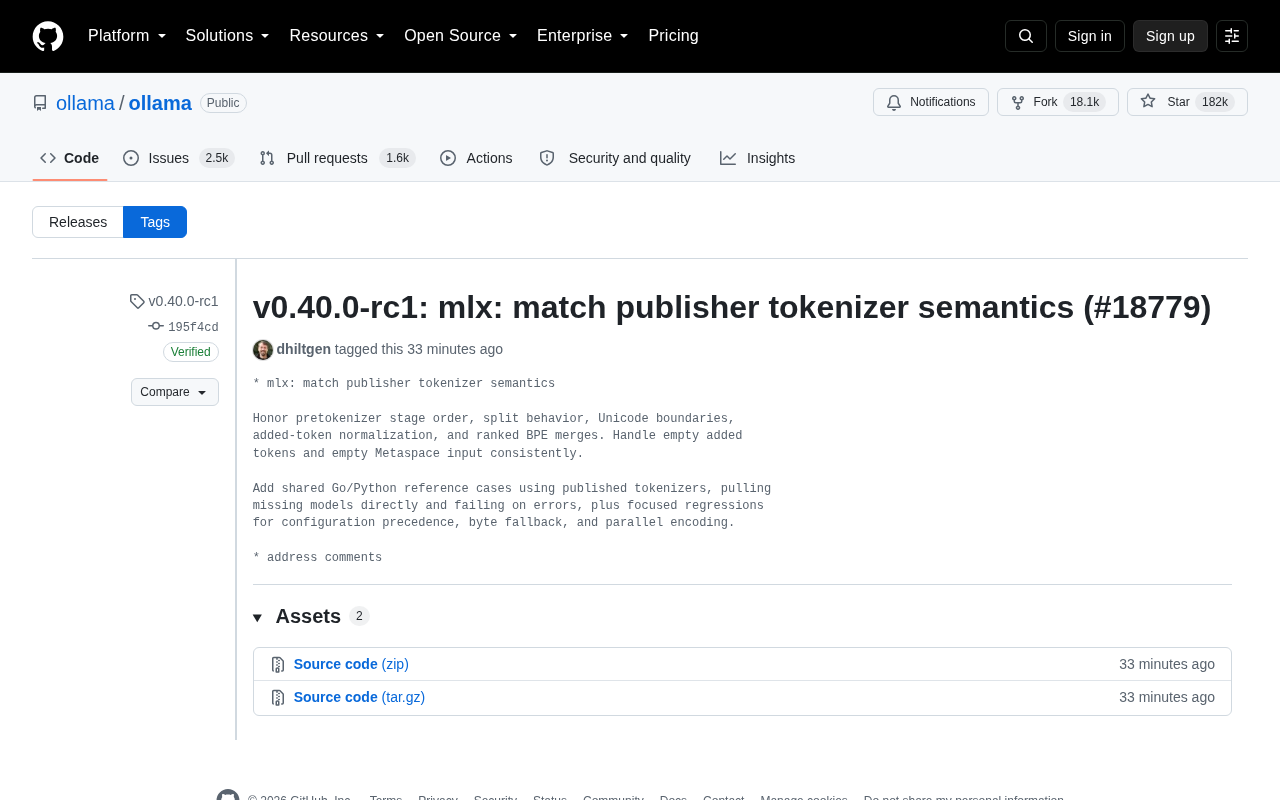
Ollama v0.40.0-rc1 发布:MLX 分词器对齐发布者语义
Ollama 发布 v0.40.0-rc1 预览版,核心更新为 MLX 后端分词器对齐发布者语义,涵盖预分词顺序、Unicode 边界、BPE 合并及跨语言测试保障,提升 Apple Silicon 本地推理一致性。
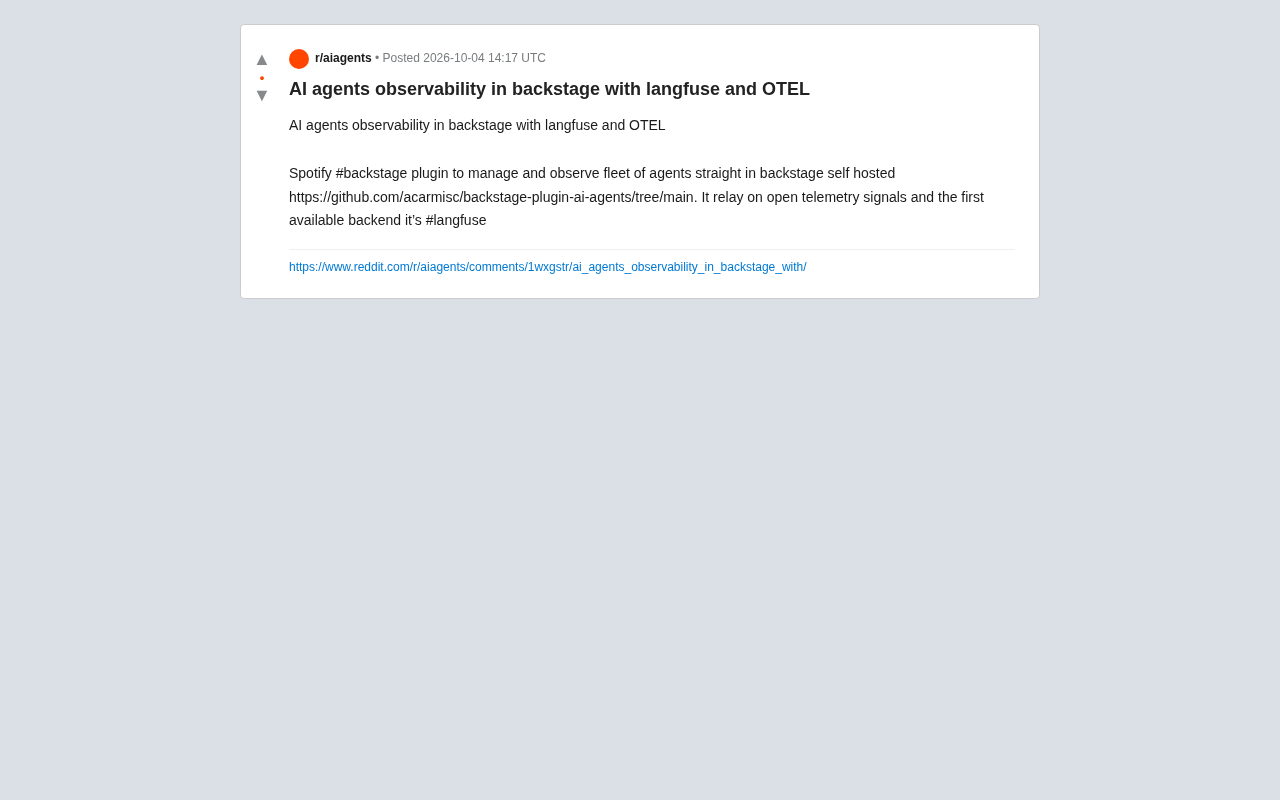
用 Langfuse 与 OTEL 在 Backstage 中实现 AI Agent 可观测性
一个开源 Backstage 插件,基于 OpenTelemetry 和 Langfuse 实现 AI Agent 可观测性,让团队在自托管开发者平台中集中管理和监控 Agent 集群。