Ollama v0.40.0-rc1 发布:MLX 分词器对齐发布者语义
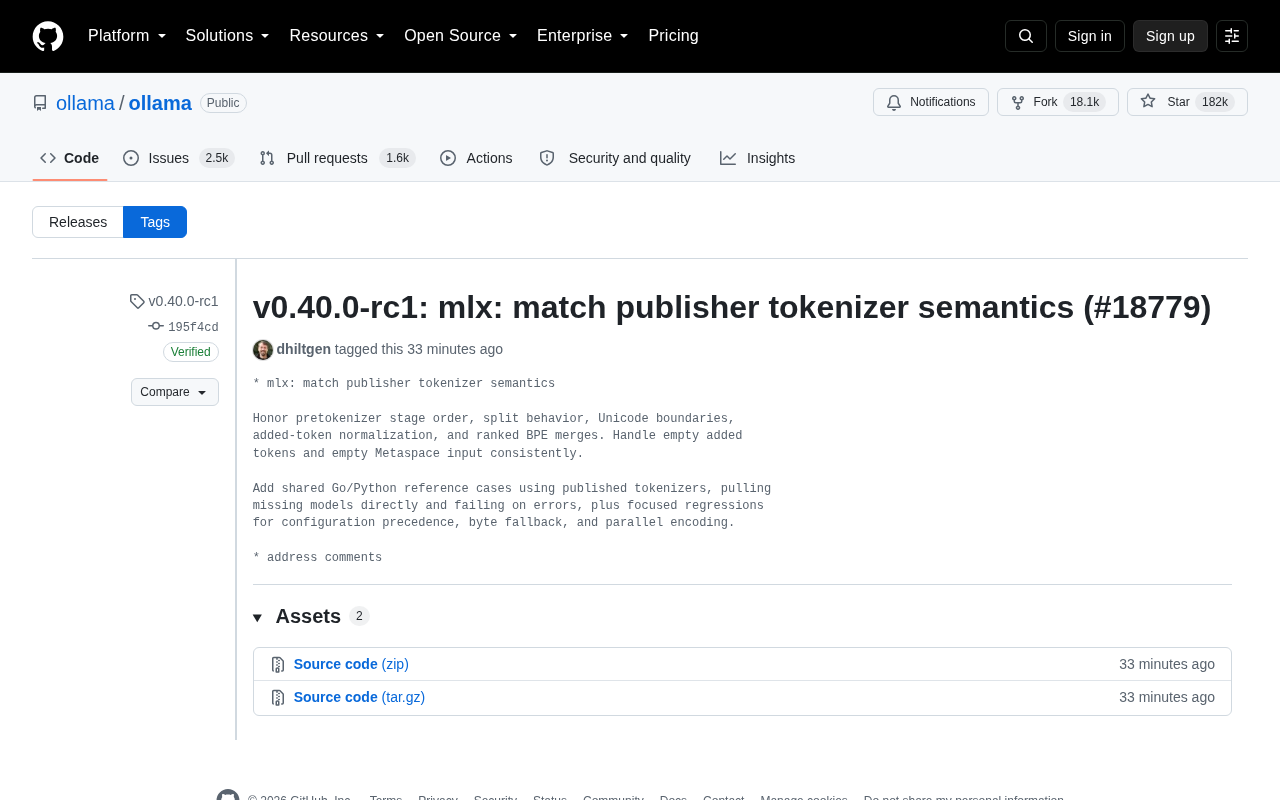
Ollama v0.40.0-rc1 专项修复 MLX 后端分词器,使本地推理结果与官方模型严格对齐。
Ollama 发布 v0.40.0-rc1 候选版本,核心改动聚焦于 MLX 后端的分词器一致性问题。此次更新覆盖预分词阶段顺序、文本切分逻辑、Unicode 边界处理、added-token 归一化以及 BPE 合并优先级等多个关键环节,同时专门修复了空 added token 与 Metaspace 空输入两类边界情况。测试层面,开发者引入了 Go 与 Python 共享的参考用例,以已发布的官方分词器为基准进行交叉验证,并新增了配置优先级、字节回退和并行编码三方面的回归测试。此版本主要影响在 Apple Silicon 设备上通过 MLX 后端运行模型的用户,有望解决「同一提示词、不同输出」等难以排查的一致性问题。该版本仍为候选发布版,生产环境用户建议等待正式版后再升级。
Ollama 近日发布了 v0.40.0-rc1 预览版本,核心改动聚焦于 MLX 后端的分词器(tokenizer)行为,使其与模型发布者的原始分词语义保持一致。这看似是一处底层细节,却直接关系到本地推理结果与官方模型的一致性。
更新核心:对齐发布者的分词语义
本次 release candidate 的主提交信息为 "mlx: match publisher tokenizer semantics"(PR #18779)。其目标是让 Ollama 在 MLX 后端下的分词行为,严格复现模型发布者所定义的处理流程。
具体来说,这次改动涵盖了多个关键环节:
- 预分词阶段顺序(pretokenizer stage order):按照发布者定义的顺序执行各个预处理步骤;
- 切分行为(split behavior):对文本的切分逻辑保持一致;
- Unicode 边界处理:确保在多语言、特殊字符场景下的边界判定正确;
- 添加 token 的归一化(added-token normalization):对自定义添加的特殊 token 做一致化处理;
- 带排名的 BPE 合并(ranked BPE merges):遵循 BPE 合并时的优先级排序。
此外,更新还专门处理了两类边界情况:空的 added token,以及 Metaspace 输入为空时的行为,确保在这些极端输入下结果仍然稳定且可预测。
BPE(字节对编码,Byte Pair Encoding) 是当前主流大语言模型最常用的分词算法之一。其核心思路是从单个字节或字符出发,反复将训练语料中出现频率最高的相邻符号对合并为新符号,直到达到预设词表大小。这一过程会生成一张「合并优先级表」,其中每条合并规则都有对应的排名(rank),排名越靠前意味着该合并在训练时越早被执行。推理阶段分词时必须严格按照相同的排名顺序执行合并,否则同一段文本可能被拆分为不同的 token 序列,导致模型"看到"的输入与训练时的分布产生偏差。Metaspace 则是一种特殊的预分词处理技术,常见于 SentencePiece 分词体系,它将词语之间的空格替换为特殊的下划线字符(▁),使得模型能够在 token 层面感知词边界,空输入时对 Metaspace 的处理需要额外保护逻辑。
为什么分词一致性如此重要
分词器是大语言模型推理链路中极易被忽视、却影响深远的一环。模型在训练时使用特定的分词规则将文本切分为 token,如果推理阶段的分词方式与训练时不一致,哪怕只是 Unicode 边界或特殊 token 处理上的细微差异,都可能导致输入被切分成不同的 token 序列,进而影响模型输出质量。
对于运行在 Apple Silicon 上的 MLX 后端用户而言,这类一致性问题尤为敏感。MLX 是苹果推出的面向其芯片优化的机器学习框架,Ollama 借助它在 Mac 设备上提供高效的本地推理能力。只有当分词语义与发布者保持严格一致,本地部署的模型才能真正复现其官方表现,避免出现「同一个提示词、不同的结果」这类难以排查的问题。
MLX 是苹果公司于2023年底开源的机器学习框架,专为 Apple Silicon(M 系列芯片)的统一内存架构(Unified Memory Architecture)设计。与 CUDA 面向 NVIDIA GPU 的角色类似,MLX 让 CPU、GPU 和神经网络引擎共享同一块内存池,避免了数据在不同处理器之间的拷贝开销,从而在 Mac 设备上实现高效的本地大模型推理。Ollama 通过集成 MLX 后端,使用户无需任何云服务即可在 MacBook 或 Mac Studio 上流畅运行参数量达数十亿的语言模型。正因为 MLX 后端拥有独立的底层实现路径,其分词逻辑与其他后端(如 llama.cpp)需要分别维护,这也是本次专项对齐工作的背景所在。
测试保障:Go 与 Python 共享参考用例
值得关注的是本次更新在测试工程上的投入。开发者引入了 Go 与 Python 共享的参考测试用例,直接使用已发布的分词器作为基准,自动拉取缺失的模型并在出错时直接失败(fail on errors)。这种做法保证了测试覆盖真实场景,而非仅依赖人工构造的样本。
在此基础上,更新还补充了针对性的回归测试,聚焦三个容易出错的方向:
- 配置优先级(configuration precedence):验证多重配置来源下的取值顺序;
- 字节回退(byte fallback):处理无法被词表直接覆盖的字符;
- 并行编码(parallel encoding):确保多线程/并发分词时结果仍然正确。
跨语言的共享参考用例,意味着 Go 实现与 Python 参考实现之间可以持续交叉验证,这对于保证分词器长期稳定、避免未来重构引入隐性偏差,具有重要工程价值。
字节回退(byte fallback) 机制用于处理词表中不存在的字符——通常是罕见的 Unicode 字符、表情符号或其他特殊符号。当分词器遇到词表中找不到的字符时,会退而将其拆解为对应的 UTF-8 字节序列,每个字节映射到一个形如 <0xE4> 的特殊 token。这一机制保证了分词器在任意输入下都不会崩溃,但不同实现对字节回退的触发条件与字节 token 的编码方式存在细微差异,在多语言(尤其是中文、日文等非拉丁语系)和特殊符号场景下极易产生不一致,因此被列为本次回归测试的重点方向之一。
对用户意味着什么
作为 release candidate(候选发布版本),v0.40.0-rc1 主要面向希望提前验证的用户和开发者。如果你正在 Apple Silicon 设备上通过 MLX 后端运行模型,这次更新有望解决此前可能遇到的分词不一致问题,让本地推理结果更贴近模型官方表现。
该版本由项目维护者 dhiltgen 标记发布,提交经过 GitHub 验证签名。由于仍是 rc 版本,生产环境用户建议谨慎评估,待正式版发布后再行升级。
总体来看,这是一次典型的「不起眼但很关键」的底层打磨——它不会带来炫目的新功能,却实实在在地提升了本地大模型推理的可靠性与可复现性。
相关推荐
用Python从零构建动量算法交易系统:Massive、SnapTrade与Alpaca实战
跟随这门 Python 实战课程,从零构建动量算法交易系统:用 Massive 拉取行情、SnapTrade 连接券商、Alpaca 纸面账户执行交易,基于 12 减 1 动量策略自动生成信号,全程无需真实资金。
从1块3090到20台DGX Spark:本地大模型玩家的硬件进化史
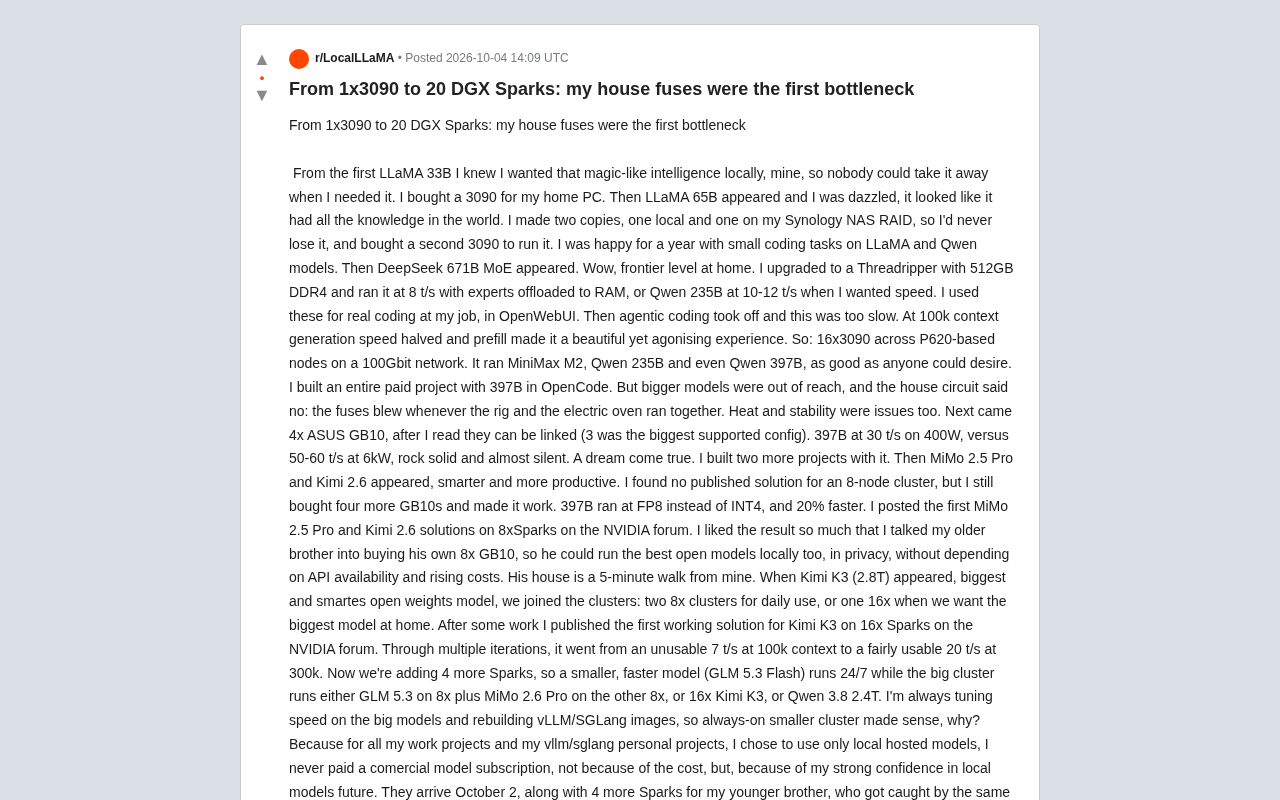
一位Reddit用户记录了从单块RTX 3090到20台NVIDIA DGX Spark的本地大模型部署进化史,涵盖MoE内存卸载、多卡功耗瓶颈、保险丝跳闸,以及如何在家用集群上跑通Kimi K3等万亿参数开源模型。
用 Langfuse 与 OTEL 在 Backstage 中实现 AI Agent 可观测性
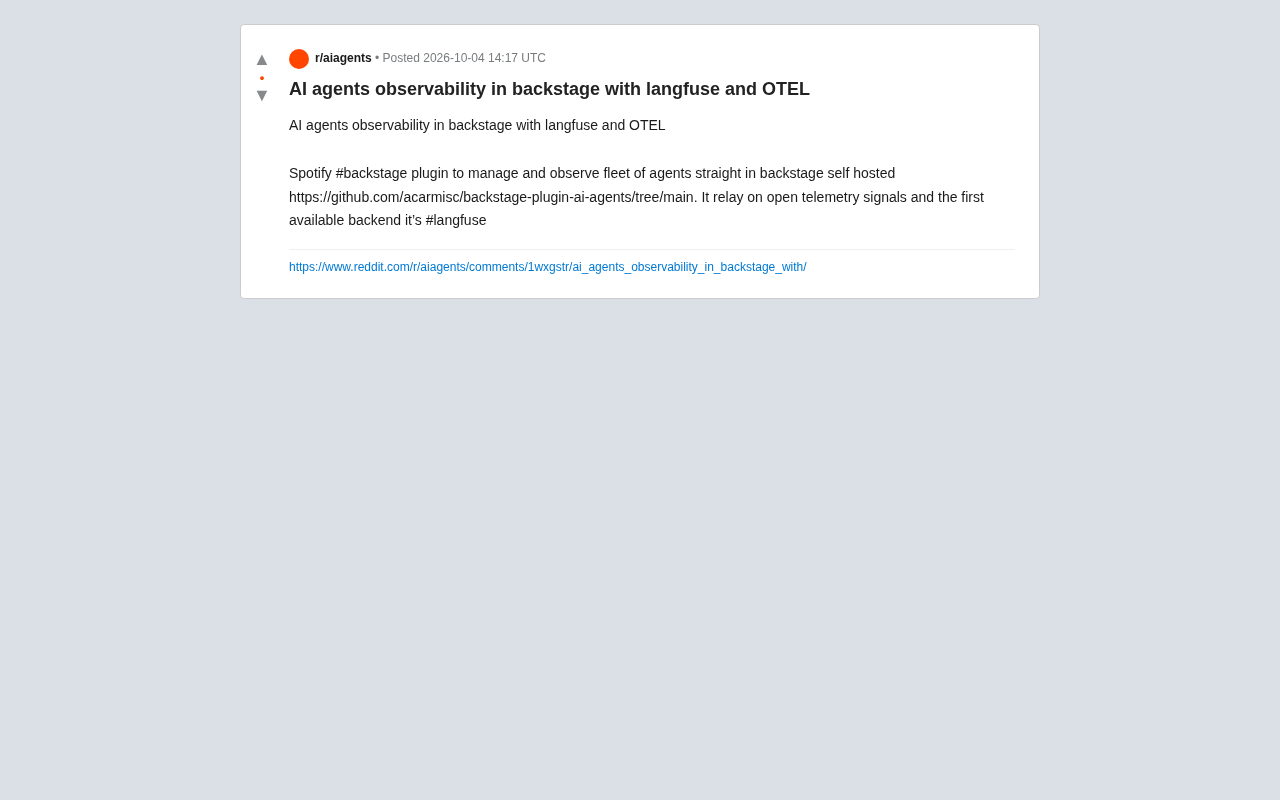
一个开源 Backstage 插件,基于 OpenTelemetry 和 Langfuse 实现 AI Agent 可观测性,让团队在自托管开发者平台中集中管理和监控 Agent 集群。