从「大肥鱼面试」段子看大模型的能力边界
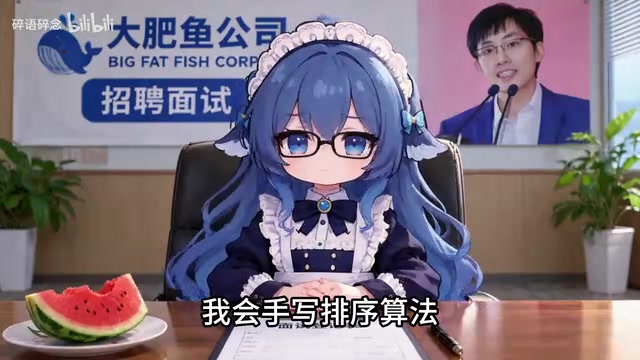
B站「大肥鱼面试」段子借拟人化AI调侃大模型不稳定性,并科普了注意力机制。
一段B站短视频将大语言模型拟人化为面试官「豆宝」,以夸张对话调侃了AI答案前后矛盾、缺乏稳定判断的真实局限。文章借此展开三个话题:一是大模型因概率生成机制而产生的「立场漂移」问题;二是AI产品普遍采用的拟人化命名策略,通过赋予模型昵称与人格来降低用户距离感;三是视频中对「注意力机制」的通俗解释——这一Transformer架构的核心技术让模型能动态为序列中不同位置分配关注权重,从而理解上下文。文章最后指出,AI梗视频有客观科普价值,但娱乐化传播也可能扭曲事实,观众应以此为入口而非终点。
一段名为「大肥鱼给用户做面试」的B站短视频以夸张的对话形式,把大语言模型拟人化成一个面试官「豆宝」(英文名 Jimmy Nye),用戏谑的方式调侃了当下AI模型的行为特征。段子背后其实折射出几个关于大模型能力与局限的真实话题,值得借着这个梗展开聊聊。
一个「面试」段子讲了什么
视频里的对话大致是这样的:面试官问用户有什么能力,用户回答「我会古法编程,我会手写排序算法」,结果被以「你的能力不符合」为由婉拒,紧接着又反转说「你被录取了,明天来报到」。之后角色对调,用户开始反问这位AI——「你知道我是谁吗」,AI一本正经地报出自己的身份:大肥鱼、英文名 Jimmy Nye、母公司是 OpenAI、外号「豆宝」。
这种前后矛盾的判断(先拒绝又录取)本身就是对大模型「答案不稳定、容易自我推翻」这一特性的调侃。模型在缺乏明确评判标准时,给出的结论往往取决于上下文措辞,而非稳定的逻辑,这也是很多用户在实际使用中会遇到的痛点。
大模型「答案不稳定」的根本原因在于其生成机制:语言模型本质上是在做概率预测,每次输出都是基于当前上下文对「下一个最可能词语」的采样,而非检索固定答案。当问题缺乏明确约束,或提示词(Prompt)的措辞发生微小变化时,模型的输出分布就会随之漂移,导致前后结论出现矛盾。此外,模型在训练过程中习得了「顺应对话语境」的倾向,当上下文暗示某个方向时,它会自动调整立场,这使得它在没有外部强制规则约束的开放性判断任务中,表现出类似视频中「先拒绝后录取」的不一致性。这一现象在 AI 研究中有时被称为「立场漂移」或「谄媚性回应(sycophancy)」。
拟人化命名背后的产品趋势
段子里给AI起了「豆宝」这样一个亲切外号,还配上了英文名和「母公司」的设定。这其实呼应了近年AI产品普遍走的拟人化路线——给模型或助手起一个好记、有亲和力的昵称,降低用户的使用距离感。
从产品心理学的角度看,拟人化命名能让冷冰冰的技术更容易被大众接受,用户更愿意与一个「有名字、有性格」的对象对话。不过需要提醒的是,视频中把具体名称和「母公司 OpenAI」绑定属于创作者的戏剧化演绎,并非严谨的产品信息,观众不宜当真。
「注意力机制」被通俗解释
视频后半段最有干货的一幕,是用户问AI「注意力机制是什么」,AI回答要「用最简单、最直白、最不绕弯子的话」来解释——「注意力机制,就是让模型在处理序列数据时,像人一样」有所侧重地关注重点信息。
这个通俗解释虽然被视频截断,但方向是对的。注意力机制(Attention)是 Transformer 架构的核心,它让模型在处理一段文本或序列时,能够动态地为不同位置的信息分配不同的「关注度」权重,从而抓住上下文中真正重要的部分,而不是平均对待每个词。
打个比方,人在阅读长句子时会自然地把注意力集中在关键词上;注意力机制正是让模型模拟这种「有重点地读」的能力。正是这一机制,支撑起了当今大语言模型的强大理解与生成能力。
注意力机制最初由 Bahdanau 等人于2014年在机器翻译任务中提出,随后在2017年 Google 的论文《Attention Is All You Need》中被进一步发展为「自注意力(Self-Attention)」,并构成了 Transformer 架构的核心。其数学本质是对输入序列中每个位置的向量计算一组权重分数(通过 Query、Key、Value 三个矩阵变换实现),使模型在输出每个词时能够参考序列中所有位置的信息,且参考程度由这些权重动态决定。
相比此前的 RNN/LSTM 架构,注意力机制的最大优势在于可以直接建立序列中任意两个位置之间的依赖关系,不再受限于「按顺序传递信息」的瓶颈,因此能更好地处理长距离依赖问题——比如理解一篇文章开头的主语和结尾的代词之间的指代关系。GPT、BERT、Claude 等当代主流大语言模型均以 Transformer 及其注意力机制为基础构建。
段子之外的思考
这类AI梗视频在B站等平台越来越流行,说明大模型已经从技术圈的话题走进了大众娱乐语境。它们用轻松的方式传播AI概念,客观上起到了科普作用——很多人第一次听说「注意力机制」这个词,可能就是从这样的段子里。
但娱乐化传播也有两面性:它容易把AI的能力和身份信息简化甚至扭曲。视频里那些「录取又拒绝」的反复、随意绑定的品牌设定,如果被当成真实信息,反而会造成误解。对普通观众来说,看段子图一乐即可,真正想了解AI原理,还是要回到严肃的技术资料。
对内容创作者而言,把技术概念包装成有趣的对话是很好的尝试,既能引流又能传递知识点。关键在于把握好「娱乐」与「准确」之间的平衡,让梗成为通往真知的入口,而不是终点。
相关推荐

AI智能体的真实风险:被夸大的"黑客"与被忽视的隐患
AI智能体"黑客"事件频发,但真实风险究竟是什么?本文剖析OpenAI训练暂停、DNS隧道漏洞、Meta Muse隐私泄露,以及智能体消除摩擦可能引发的银行挤兑与医疗成本上涨,提出"AI现实主义"的理性视角。

OpenAI Dev Day 全盘点:20+ 发布背后的三大趋势
OpenAI Dev Day 一次性发布 20+ 产品,涵盖个人智能体 DOTS、GPT-6.1 Sol、Decisions API、Space 协作区与模型市场。本文全面盘点并解读其揭示的三大 AI 趋势。

只想要一个自定义域名邮箱,为何如此艰难?
拥有一个自定义域名邮箱看似简单,实则涉及 SPF/DKIM/DMARC 配置、IP 信誉、托管服务成本等诸多难题。本文梳理自建与托管方案的权衡,并给出实用建议。