从Function Calling到MCP:读懂大模型工具调用底层原理
从Function Calling五步流程切入,系统讲解MCP与Agent的底层原理与演进逻辑。
本文是一套大模型开发教程的基础章节,核心论点是:学习MCP(Model Context Protocol)和智能体(Agent)必须先理解Function Calling。文章系统拆解了函数调用的五步工作流程——定义函数、模型推理、生成调用指令、执行函数、返回结果——并通过天气查询实战演示了完整的OpenAI API调用过程。文章同时厘清了两组关键区别:Function Calling与Agent的本质差异(后者具备规划与记忆能力),以及底层手写代码与实际生产开发的关系(手写仅用于理解原理)。最终落脚到一条清晰的技术演进路径:Function Calling是地基,MCP是标准化的协议层,Agent与A2A是上层应用形态,三者层层递进。
为什么理解MCP要从Function Calling讲起
很多人一上来就想学MCP(Model Context Protocol)和智能体(Agent),却忽略了一个关键前提:MCP的本质,其实是对工具调用的一次优化与标准化。它在底层依然依赖 Function Calling(函数调用)这套机制,只不过在此基础上规范出了一种被广泛认可的协议。
换句话说,不搞懂 Function Calling,就很难真正理解 MCP 乃至更上层的 Agent to Agent(A2A)通信是怎么回事。这也是这套 B 站教程选择从 Function Calling 切入的逻辑——先打地基,再盖楼。
Function Calling 最早由 OpenAI 等公司推动,它允许大模型与外部工具连接,把自然语言转换为 API 调用。它解决的核心痛点是:大模型训练结束后就进入了"知识停滞"状态,无法获取训练截止之后的新信息。通过调用外部或内部函数,模型可以在推理时获得额外能力和实时数据。
目前主流通用大模型大多支持 Function Calling。教程中特别澄清了一个常见误区:DeepSeek R1 确实不支持 Function Calling,但 DeepSeek V3 是支持的;国外的 GPT 系列同样普遍支持。可以说,绝大部分主流模型都具备这一能力。
MCP(Model Context Protocol)是由 Anthropic 于2024年底提出并开源的一套开放协议,目标是为大模型与外部工具、数据源之间的交互定义统一标准。在 MCP 出现之前,各家大模型平台(OpenAI、Anthropic、Google 等)对工具调用的实现方式各有差异,开发者需要针对不同平台分别适配,维护成本极高。MCP 的核心价值在于"一次描述,到处调用"——工具提供方只需按照 MCP 规范暴露接口,任何支持 MCP 的模型或 Agent 框架都能自动发现和调用这些工具,无需重复适配。A2A(Agent to Agent)则是更上层的协议概念,描述多个智能体之间如何互相通信与协作,本质上也依赖底层的函数调用机制来传递指令和结果。理解这条从 Function Calling → MCP → A2A 的演进链条,是系统学习现代 AI 应用开发的重要基础。
Function Calling 的五步工作流程
教程把整个调用过程拆成了清晰的五步,这也是理解后续所有高级概念的骨架:
第一步,定义函数。 你需要描述函数的名字、写清楚函数的注释与用途,并明确参数及其类型。这一步是让模型"知道有哪些工具可用"。
第二步,模型推理。 由大模型判断这次请求要不要调用某个函数。当然,你也可以强制每次都调用,但一般不这么做。
第三步,生成 function call。 模型确定需要调用函数后,会生成一个函数调用指令,其中最关键的是准备好调用所需的参数。
第四步,执行函数。 这一步由开发者的代码真正去执行函数,模型本身并不执行。
第五步,返回结果。 把函数执行结果再传回给大模型,由模型生成最终答案。
这里有个容易混淆的点:Function Calling 和智能体(Agent)看起来很像,但本质不同。智能体在决策时会"生成计划",比如先调用函数一还是函数二、之后是否还要调用其他函数,它具备规划和记忆能力。而 Function Calling 里的模型推理只决定"要不要调用这个函数",既没有计划,默认也没有记忆功能。这个区别,是后面理解 Agent 的关键。
值得注意的是,Function Calling 整个过程中存在两次网络请求:第一次请求让模型决定是否调用函数并生成调用指令,第二次请求则是把函数执行结果交还给模型、让它生成最终自然语言回答。这一"两阶段"结构是许多初学者容易忽略的地方,也是 Function Calling 区别于普通 API 调用的关键——模型本身只负责"决策"和"总结",真正的计算或数据获取始终发生在开发者的代码侧。此外,tool_choice 参数控制调用策略:auto 让模型自行判断是否需要调用工具,required 则强制每次都调用,none 则禁止调用。在生产环境中,auto 是最常用的设置,能够让模型根据上下文灵活决策,避免不必要的函数调用带来的延迟和成本。
天气查询实战:手写一次完整的函数调用
教程用"查询实时天气"这个经典场景做演示,因为大模型本身无法获取实时天气,必须借助外部函数。
第一步定义函数 get_weather,接收一个 location 参数(城市或区域)。演示中并没有真正实现天气查询逻辑,而是用模拟数据返回 JSON,目的是先把 Function Calling 的机制讲透。
第二步接入模型。这里直接使用 OpenAI 的原生 API(通过 .env 管理 API Key,并配置了国内代理的 base_url),创建 client 后调用 client.chat.completions.create。请求参数中 model 选用了较便宜的 gpt-4o-mini,messages 里放入用户输入"今天北京天气怎么样"。
关键在于 tools 参数:需要把之前定义的函数转换成一个 JSON 格式的工具描述。这个 JSON 对象包含 type(function)、函数名、函数描述(description),以及参数结构(properties 中的 location、类型、描述,以及 required 标明哪些参数必填)。教程反复强调:description 一定要写清楚,因为模型正是靠它来判断何时调用。
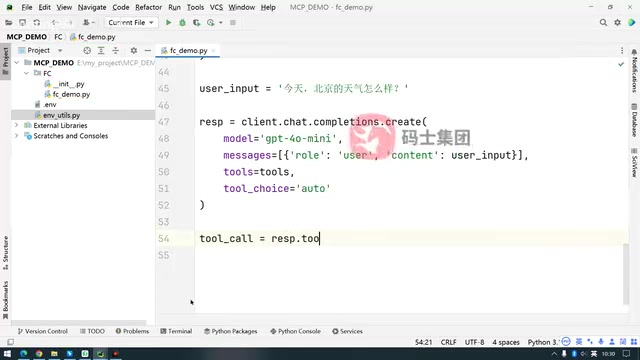
还有一个参数 tool_choice:设为 required 表示必须调用,设为 auto 则由模型自行决策。演示中选择 auto,让模型自己判断。
拆解模型返回的"调用指令"
运行后,模型返回的 response 是一个 ChatCompletion 对象。注意,此时并没有真正执行函数——模型返回的其实是一个"调用函数的指令"。
通过 response.choices[0].message.tool_calls 可以取到这个指令数组(本例中只有一个)。每个 tool_call 里包含 function 对象,其中 name 是要调用的函数名 get_weather,arguments 是模型准备好的参数(如 location=北京)。
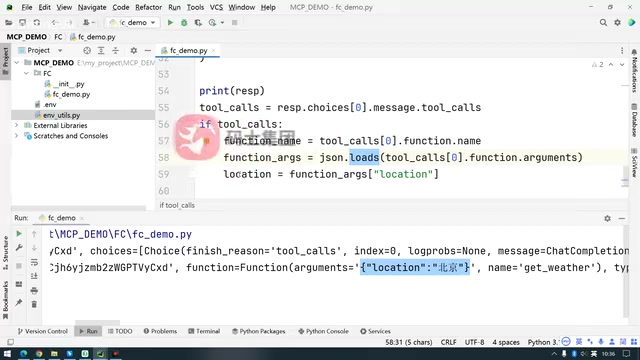
拿到指令后,代码要做的是:解析函数名,用 json.loads 把 arguments 字符串转成字典,取出 location。接着做一层保护性判断——如果函数名等于 get_weather,就真正执行本地函数,得到结果 result。
最后一步,把工具调用信息和执行结果一起放进 messages,再发起第二次请求给模型,模型据此生成自然语言回答,例如"今天北京的天气气温是……风是……"。至此,五步流程完整走通。
为什么今天不再手写这样的代码
教程结尾抛出了一个务实的观点:这套手动拼装 Function Calling 的写法,只是为了让你理解底层原理,在实际开发中已经不会这么写了。
讲师直言,这种底层写法在早期或许有人这么做,但如今做大模型开发,最基础的也应该是构建 Agent,而不是从最底层手工处理每一次函数调用。这恰好呼应了开篇的逻辑链条:Function Calling 是地基,MCP 是标准化的协议层,Agent 和 A2A 才是上层应用形态。
理解了这条演进路径,你就能明白 MCP 到底优化了什么——它把原本零散、各家各写的工具调用方式,收敛成一套统一协议,让工具能够被更规范地发现、描述和调用。而这一切的起点,正是这节课手把手拆解的 Function Calling。
目前主流的 Agent 框架(如 LangChain、LlamaIndex、AutoGen、以及 OpenAI 官方的 Assistants API)都已经在内部封装了 Function Calling 的完整流程,开发者只需声明工具的名称和描述,框架会自动处理工具列表的构建、模型返回指令的解析、函数的分发执行以及结果的回传。以 LangChain 为例,使用 @tool 装饰器即可将一个 Python 函数注册为可调用工具,Agent 会自动完成五步流程中的所有中间环节。这种抽象大幅降低了开发门槛,但也正因如此,很多开发者在遇到调试问题或需要定制行为时,因为不了解底层机制而束手无策。手动拆解一次完整的 Function Calling 流程,正是为了在使用高层框架时心中有数。
小结
这节课的价值不在于教你如何在生产环境写代码,而在于帮你建立正确的心智模型:Function Calling 的五步流程、它与 Agent 的本质区别、以及它作为 MCP 底层机制的地位。掌握了这些,再去学 MCP 协议和多智能体协作时,才不会停留在"会用不懂原理"的层面。
相关推荐
NVIDIA cuML 加速谱聚类:Scikit-Learn 提速100倍实测
NVIDIA cuML 让 Scikit-Learn 谱聚类无需重写代码即可在 GPU 上运行,大规模数据下提速超 200 倍。本文解析其原理、接入方式及在金融期权数据中的实测表现。
谷歌DeepMind成立新机构:把AGI大辩论摆上台面
Google DeepMind成立新机构,旨在把通用人工智能(AGI)的重大问题带入公共辩论。本文分析这一举措背后的行业信号,以及从技术竞赛走向公共治理的转向意义。
Crusoe完成39亿美元融资 剑指AI数据中心与模块化"AI工厂"
数据中心巨头Crusoe完成39亿美元融资,估值达309亿美元,将用于建设大型数据中心及小型模块化"AI工厂",成为AI算力基础设施赛道的重量级玩家。