从Function Calling到MCP与Agent:大模型工具调用原理详解
Function Calling 是 MCP 与 Agent 的底层基础,本文以天气查询为例拆解其五步原理与实战代码。
本文以一位 B 站 UP 主的教程为蓝本,系统讲解了 Function Calling(函数调用)的工作机制及其在大模型技术栈中的基础地位。核心论点是:MCP 本质上是对工具调用的规范化协议,而工具调用的底层就是 Function Calling,因此理解函数调用是学习 MCP 和 Agent 的必要前提。文章将函数调用拆解为定义函数、模型推理判断、生成调用指令、执行函数、回传结果五个步骤,并指出其与智能体的本质区别——Agent 具备多步规划和记忆能力,而 Function Calling 只做单次无状态决策。实战部分以查询北京实时天气为例,用 OpenAI gpt-4o-mini API 演示了工具描述定义、tool_choice 参数配置与调用结果解析的完整流程。最终结论是:手写底层 Function Calling 仅用于理解原理,现代开发应直接使用 Agent 框架,推荐的学习路径为 Function Calling → MCP → Agent/工作流 → A2A。
为什么理解 Function Calling 是学好 MCP 的前提
在深入 MCP(Model Context Protocol)、A2A(Agent to Agent)和智能体工作流之前,绕不开一个更底层的概念——Function Calling(函数调用)。这位 B 站 UP 主在教程里点明了一个关键逻辑:MCP 本质上是对工具调用的一种优化,或者说是基于工具调用规范出来的一套大家公认的协议,而工具调用的底层就是 Function Calling。
换句话说,如果不明白 Function Calling 是怎么运作的,直接学 MCP 和 Agent 就容易只知其然不知其所以然。搞懂了函数调用,后面理解 MCP 乃至 Agent to Agent 都会顺理成章。
Function Calling 最早由 OpenAI 推动,核心作用是允许大模型与外部工具连接,将自然语言转换为 API 调用。这解决了一个根本问题:大模型训练结束后就进入了知识停滞状态,无法获取训练截止之后的新信息。而通过调用外部或内部函数,模型可以在训练完成后依然获得额外功能或实时数据。
目前几乎所有主流通用大模型都支持 Function Calling,包括国外的 Gemini、Claude,以及国内 DeepSeek 的 V3 版本。UP 主特别提到,DeepSeek R1(DeepThink 推理版)并不支持 Function Calling,但 V3 是支持的,部分模型如智谱也存在支持差异。
MCP(Model Context Protocol)是由 Anthropic 于 2024 年底提出并开源的一套标准化协议,目标是统一大模型与外部工具、数据源之间的交互方式。在 MCP 出现之前,每家模型厂商、每个框架对工具调用的描述格式和交互流程各不相同,开发者需要为不同模型单独适配,维护成本极高。MCP 的价值在于提供了一个统一的「插头标准」:工具提供方只需按 MCP 规范暴露接口(称为 MCP Server),任何遵守该协议的模型或 Agent 框架(MCP Client)就能直接使用,无需重复开发适配层。A2A(Agent to Agent)则更进一步,描述的是多个智能体之间如何协作、任务如何拆解与传递,属于比 MCP 更高层的编排协议。理解这条协议栈的层次关系——Function Calling 作为底层机制、MCP 作为工具接入规范、A2A 作为多智能体协作协议——有助于在学习时明确每项技术究竟在哪个抽象层解决了什么问题。
Function Calling 的五步工作原理
教程把函数调用拆解成五个清晰的步骤,这也是理解后续所有智能体技术的基础框架:
第一步:定义函数
定义函数时必须描述清楚三样东西——函数名称、函数的具体注释与描述、参数及其类型。这些信息决定了模型能否正确理解并使用这个工具。
第二步:模型推理判断
把函数信息交给大模型后,由模型来决策要不要调用这个函数。UP 主强调,你也可以强制模型每次都调用,但一般不这么做,主流做法是让模型自主判断。
第三步:生成 Function Call 指令
当模型确定需要调用某个函数时,它会生成一个 function call。这一步最重要的产出是准备好调用函数所需的参数,把参数先构造出来。
第四步:真正执行函数
注意,前三步模型都没有真正执行函数,只是做出了决策并准备了参数。第四步才是由开发者的代码去实际执行这个函数。
第五步:返回结果并生成答案
把函数执行的结果再返回给大模型,由模型基于这个结果生成最终的自然语言答案。
Function Calling 与智能体(Agent)的本质区别
很多初学者会把 Function Calling 和智能体混为一谈,但 UP 主明确指出两者有本质差异:
智能体的决策会生成计划。它需要确定先调用函数一还是函数二、调用完之后是否还要继续调用其他函数——这是一个有规划、多步骤的过程。而 Function Calling 中的模型推理只决定「要不要调用某个函数」,它没有计划,调用完一个函数就结束了,不会自动衔接下一步。
此外,Function Calling 默认没有记忆功能。如果开发者不额外增加记忆机制,它就是无状态的单次调用。这两点差异,正是 Agent 相比原始函数调用的进阶之处。
从工程实现角度来看,Agent 通常依赖一种称为「ReAct」(Reasoning + Acting)的循环模式:模型先推理当前状态,决定下一步动作,执行后观察结果,再继续推理——如此反复,直到任务完成或达到最大步数上限。这种循环赋予了 Agent「自主规划」的能力,使其能在不确定环境中动态调整策略,而不像单次 Function Calling 那样在一次调用后就终止。记忆机制通常分为短期记忆(当前对话上下文)和长期记忆(向量数据库存储的历史信息),Agent 框架如 LangChain 或 LangGraph 会显式管理这两类记忆,而原始 Function Calling 接口则完全不涉及记忆的维护,每次调用对之前的状态一无所知。这也是为什么即便是简单的多轮工具调用场景,现代实践也倾向于直接使用 Agent 框架,而非手工拼接消息列表来模拟状态管理。
实战:用天气查询演示完整调用流程
为了让原理落地,教程以「查询北京实时天气」为例,逐步演示了完整代码流程。之所以选天气,是因为大模型本身不具备实时天气数据,必须依靠外部函数获取。
定义函数与工具描述
首先定义一个 get_weather 函数,接收一个 location 参数。教程里先用模拟数据代替真实的 Web 接口,返回 JSON 格式的天气信息。
关键在于要把这个函数转换成一个 JSON 格式的工具描述(tools),其中包含:type 为 function、函数名 get_weather、函数描述「获取指定城市的天气信息」,以及请求参数 location(字符串类型,描述为城市名如北京、上海)。UP 主特别提醒,参数的 description 一定要写清楚,required 则标明哪些参数是必须传入的。
调用模型并传入工具
代码里没有使用 LangChain,而是直接用 OpenAI 官方 API,模型选择了较为便宜的 gpt-4o-mini。通过 .env 文件管理 API Key,并配置了国内代理的 base_url。
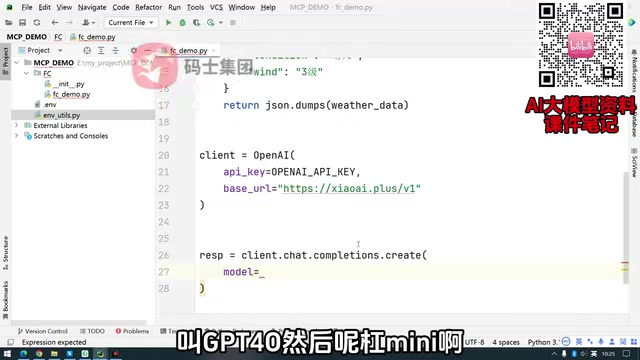
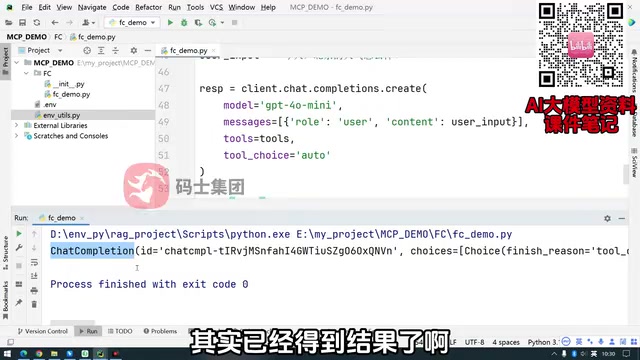
调用 client.chat.completions.create 时传入 model、messages(用户输入「今天北京天气」)、tools(工具列表),以及关键参数 tool_choice="auto"——表示由大模型自己决策是否调用工具。tool_choice 还有 none(不调用)和 required(必须调用)两个可选值。
解析模型返回的调用指令
模型第一次返回的 response 并不是最终答案,而是一个「调用函数的指令」。UP 主反复强调这一点:第一次响应本质上是一个决策,它告诉你需要调用哪个函数、要传什么参数。
从 response.choices[0].message.tool_calls 中可以拿到这个指令对象。里面包含 function 信息:调用的函数名是 get_weather,参数 location 等于「北京」。注意 tool_calls 是一个数组,意味着模型可能一次返回多个函数调用,如果有多个就需要用 for 循环处理。
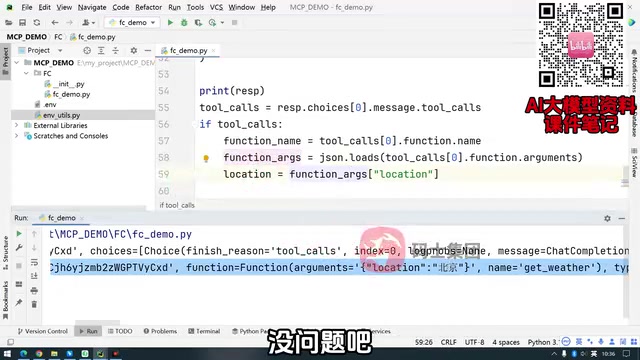
模型第一次响应中 finish_reason 字段的值为 tool_calls(而非通常的 stop),这是判断模型是否要求调用工具的标准信号。开发者在生产代码中应先检查该字段,再决定是否进入工具执行分支,而不能仅凭 tool_calls 数组是否为空来判断,因为不同模型厂商在边界情况下的行为可能存在差异。此外,tool_calls 数组支持并行调用(Parallel Function Calling),即模型在一次响应中同时请求调用多个函数——例如同时查询北京和上海的天气。OpenAI 在 GPT-4 系列中已支持该能力,处理时需为每个 tool_call 分别执行并将各自结果以独立的 role: tool 消息回传,每条消息须携带对应的 tool_call_id 以供模型匹配。正确处理并行调用既能提升效率,也是理解后续 Agent 框架中并发工具执行机制的基础。
执行函数并回传结果
提取出函数名和参数(参数是 JSON 字符串,需用 json.loads 转成字典)后,代码判断函数名是否为 get_weather,是则实际调用并拿到 result。最后把工具调用信息和执行结果一起打包进 messages,再次请求模型,得到最终回答:「今天北京的天气晴,气温、风速……」
手写 Function Calling 只是理解原理,实战应写 Agent
教程结尾给出了一个很有价值的判断:这样从最底层手写 Function Calling 的方式,在实际开发中已经不再使用。UP 主直言,这种写法只是帮大家理解函数调用的运作过程,现在做大模型开发「最次最次都要写 Agent」。
这也呼应了文章开头的技术演进脉络:Function Calling 是地基,MCP 是在其之上规范出来的协议,而 Agent 和 A2A 则是更高层的编排能力。理解了这条从原理到实战的链路,再去学 MCP、LangGraph 调用、智谱智能体等上层技术,就能明白每一层到底解决了什么问题。
对于想系统入门大模型应用开发的同学,这个由浅入深的顺序——Function Calling → MCP → Agent/工作流 → A2A——是一条值得参考的学习路径。
相关推荐
AI Agent智能体入门:大脑、记忆与工具三要素详解
从零理解AI Agent智能体:详解大脑、记忆、工具三大核心组件,梳理大模型从原生模型、提示工程、RAG到Agent的四阶段演进,帮你搞懂Agent到底解决了什么问题以及为何值得学习。
抵制不支持Linux的软件:一位开发者的选择哲学
一位只用Linux的开发者分享他抵制不支持Linux软件的选择哲学:不牺牲生产力,用编程Agent扩展开源工具,并点评Valve、Proton、Omarchi等推动Linux主流化的力量。
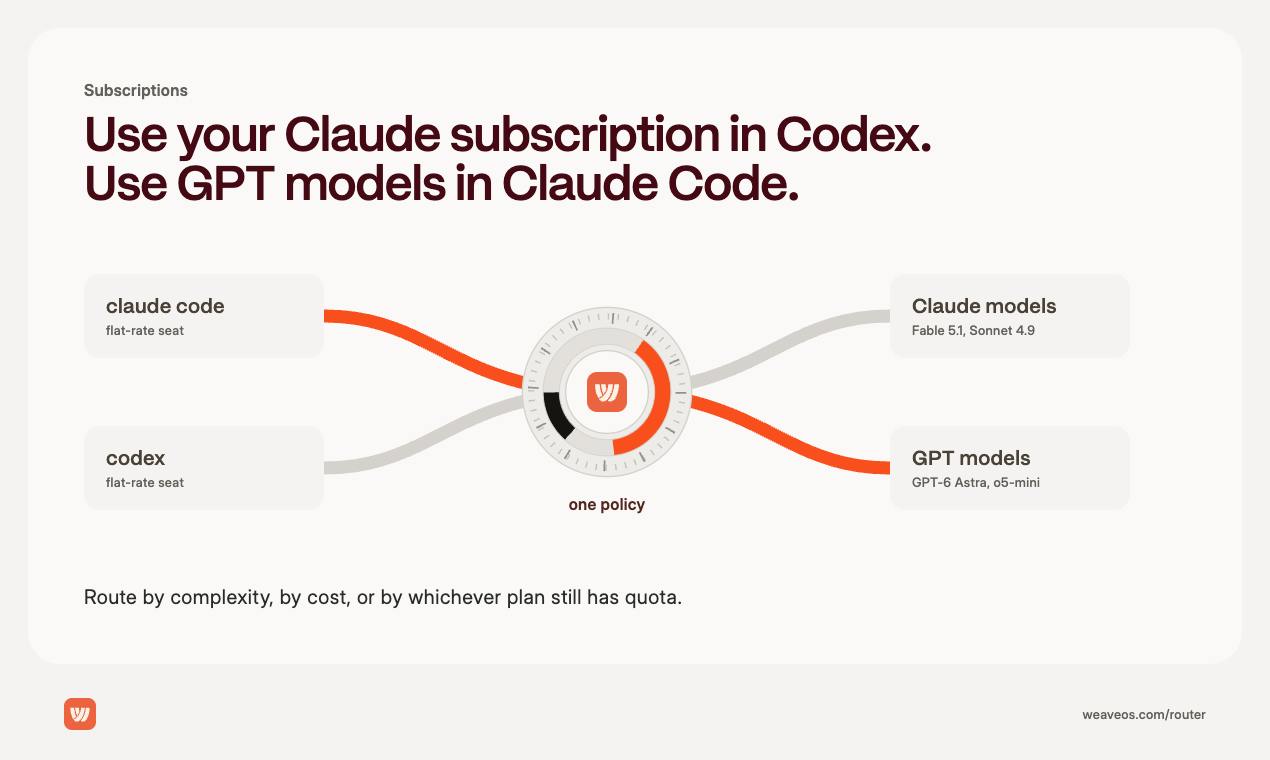
Weave Router 2.0:跨订阅智能路由的编程助手调度器
Weave Router 2.0 是一款订阅感知的 AI 编程助手路由器,可跨 Claude、Codex、GPT 订阅自动调度请求。官方称在 Terminal-Bench 4.0 与 SWE-Atlas 上对标 GPT-6 Astra,成本减半、速度翻倍。