从零搭建RAG知识库问答系统:接入DeepSeek的实战全流程
用Python加原生前端接入DeepSeek,拆解RAG私有知识库问答系统的完整入门实现路径。
本文介绍了一个面向入门者的RAG(检索增强生成)私有知识库项目。RAG通过"先检索本地文档片段、再交给大模型生成答案"的方式,解决了大模型知识盲区和幻觉问题,是搭建企业或个人知识库的主流低成本方案。该项目将RAG流程拆解为三个环节:文档上传并建立本地向量索引、基于用户提问检索相关片段、将问题与片段一并传入大模型生成可追溯的答案。技术栈刻意保持简洁——Python后端、原生HTML/JS/CSS前端、接入DeepSeek大模型——目的是帮助初学者在不被工程复杂度干扰的情况下,清晰理解智能体内部的核心机制。适合刚接触RAG概念、希望通过可运行项目建立直觉的开发者。
什么是RAG,为什么它是私有知识库的核心
RAG(Retrieval-Augmented Generation,检索增强生成)是当前构建私有知识库问答系统的主流技术方案。它解决的痛点很直接:大模型的知识存在时间截止和领域盲区,无法回答企业内部文档、个人资料库里的专有内容。RAG的思路是把「检索」和「生成」结合起来——先从本地文档中找到与问题相关的片段,再把这些片段连同问题一起交给大模型,让模型基于真实资料生成答案。
这种做法既避免了对大模型进行昂贵的微调,又能保证回答有据可依,大幅降低「一本正经胡说八道」的幻觉问题。对于想要搭建私有知识库的开发者来说,RAG几乎是性价比最高的路径。
RAG智能体的完整工作流程
本文参考的B站教程通过一个小型智能体项目,把RAG的完整链路拆解得相当清晰。整个流程可以概括为三个关键环节:
文档上传与建立本地索引
第一步是把文档喂给系统。用户上传文档后,程序会对文档内容进行处理,建立本地的向量索引(教程中称为「动向索引」)。这一步的本质是把文本切分成片段,并转换成可供检索的向量数据,存储在本地数据库中。
向量化(Embedding)是这一步的核心技术。文本片段被送入一个嵌入模型(Embedding Model),转换成一串高维度的浮点数数组,即"向量"。这个向量代表了文本的语义信息——语义相近的文本,其向量在高维空间中的距离也更近。检索时,用户的问题同样会被转换成向量,系统通过计算问题向量与所有文档片段向量之间的余弦相似度或欧氏距离,找出最相关的片段,这整个过程称为"向量检索"或"语义检索"。相比传统的关键词匹配,向量检索能理解同义表达,比如问"如何节省电量"也能匹配到文档中"电池续航优化"的相关段落。存储这些向量的数据库称为向量数据库,常见的有 FAISS、Chroma、Milvus 等;入门项目中通常使用轻量级的本地方案,如 FAISS,无需额外部署服务。
基于提问检索相关片段
当用户发送一个提问时,系统不会直接把问题丢给大模型,而是先拿着这个问题去检索本地数据库,判断已有文档中是否存在相关内容。如果检索命中,就会把相关的文档片段提取出来。
携带上下文交给大模型生成回答
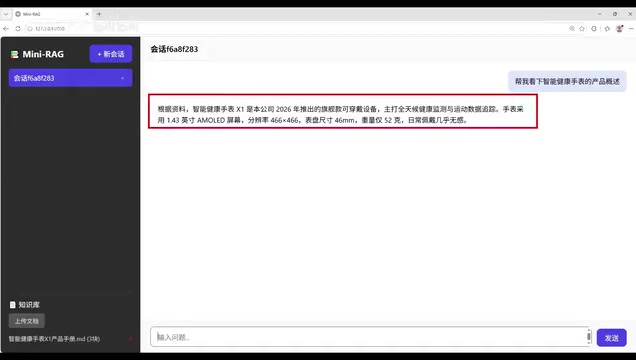
检索到相关片段后,系统会把「用户问题」和「相关文档片段」两条信息一并发送给大模型。大模型接收到这两部分内容后,就能结合真实资料给出针对性的回复。教程中演示了实际效果:创建新对话、上传一份产品文档,然后提问「帮我看一下智能电话手表的产品概述」,系统随即返回了与文档内容完全对应的答案。
这个演示直观说明了RAG的价值——回答的内容可以直接在原文档中找到对应出处,可追溯、可验证。
这个步骤在工程上通常被称为"Prompt 构造"(Prompt Construction)或"上下文注入"。系统会按照固定模板,将检索到的文档片段拼接到提示词(Prompt)中,并附上类似"请仅根据以下资料回答问题,不要编造资料中未提及的内容"的指令约束。这类指令是控制幻觉的关键手段——通过系统提示明确限制模型的回答范围,让模型扮演"资料阅读者"而非"知识生产者"。检索片段的数量(通常称为 top-k)和片段长度是影响回答质量的重要参数:片段太少可能遗漏关键信息,片段太多则会超出模型的上下文窗口限制(Context Window),并增加推理成本。入门项目中通常取 top-3 至 top-5 个最相关片段作为平衡点。
技术栈与项目结构
这个入门级项目在技术选型上刻意保持了简单,目的是让学习者能看清agent内部的核心框架,而不被复杂工程细节淹没。
后端
后端全部使用 Python 代码实现,负责文档处理、索引建立、检索逻辑以及与大模型的交互。教程中接入的大模型是 DeepSeek广告,这也是目前国内开发者搭建本地知识库时常见的选择——中文能力强、调用成本可控。
DeepSeek 是由深度求索(DeepSeek)公司推出的大语言模型系列,提供与 OpenAI API 兼容的调用接口,这意味着基于 OpenAI SDK 编写的 Python 代码只需修改 base_url 和 api_key 即可切换到 DeepSeek,迁移成本极低。RAG 系统中,大模型承担的角色是"阅读理解"而非"知识记忆"——它拿到检索片段后,负责理解、综合并用自然语言表达答案,而不是凭记忆背诵。因此模型本身的知识截止日期在这个场景下影响不大,中文理解与指令跟随能力才是关键评估维度。DeepSeek 在这两点上表现出色,且 API 定价相对 GPT-4 系列更低,非常适合个人或小团队构建知识库的预算控制需求。
前端
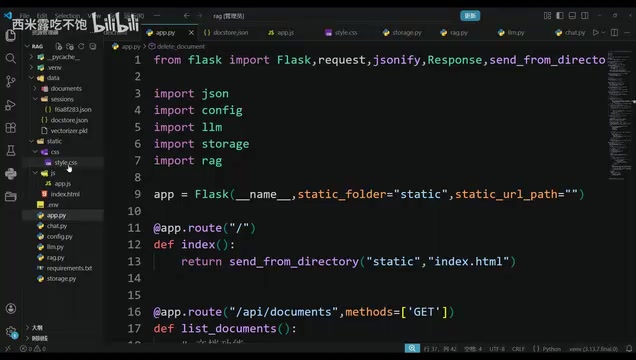
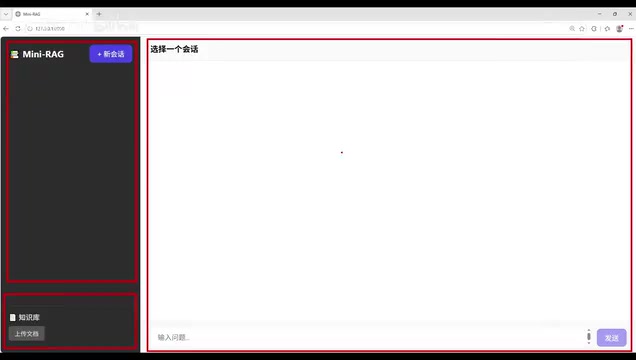
前端没有采用任何重量级框架,而是用最原生的 HTML、JS 和 CSS 完成。界面包含对话列表、文档索引区和消息输入框三大模块。对于初学者而言,原生实现反而更容易理解每个交互背后的逻辑。
这种「最简代码」的设计取向值得肯定:搭建RAG系统时,很多教程一上来就堆砌LangChain、向量数据库等一堆组件,反而让新手迷失在工具链里。用最基础的代码把原理跑通,再逐步替换成生产级组件,是更扎实的学习路径。
这个项目适合谁
从内容定位看,这是一个面向入门者的实战教学项目。它的价值不在于工程的完备性,而在于把RAG「上传—索引—检索—生成」的闭环用可运行的代码完整展示出来。如果你是刚接触RAG、想理解智能体内部机制的开发者,跟着这样一个小项目走一遍,会比单纯阅读概念文档收获更大。
据该教程作者说明,完整的项目源码和资料可通过评论区获取,后续课程还会逐个模块详细讲解。
小结
RAG之所以成为私有知识库的标配方案,在于它用较低的成本让大模型「学会查资料」。本文梳理的这个入门项目,用 Python 后端加原生前端、接入 DeepSeek 大模型,把检索增强生成的核心流程完整跑通。对于希望动手实践的开发者,理解这套流程是迈向更复杂智能体应用的第一步。真正搭建时,建议在跑通原理后再逐步引入专业的向量数据库和检索优化策略,以应对更大规模的文档场景。
相关推荐
AI Agent实战指南:三层用法让效率翻倍
一篇系统梳理AI Agent用法的实战指南,从填表格、视频转录等基础杂事,到CLI、Skill、插件的能力叠加,再到行程规划、Final Cut Pro剪片等复杂目标的自主实现,三层递进讲透如何用Agent让工作效率翻倍。
从0到1搭建企业级AI Agent:三阶段学习路径全解析
一套从0到1搭建企业级AI Agent的748集教程解析,涵盖ReAct框架、LangChain与AutoGen实战、RAG混合架构及智能客服、数据分析、多Agent协作三大落地项目,附完整学习路径。
好莱坞对AI末日警告的态度:眼前的威胁比生存危机更紧迫
科技行业警告AI可能毁灭人类,好莱坞娱乐劳工组织却呼吁关注眼前现实:生成式AI对创意工作岗位、版权和演员形象的冲击。迪士尼、Netflix等制片厂已在使用AI,两种AI焦虑正在碰撞。