从零构建生产级AI Agent:RAG与MCP实战指南
拆解生产级AI Agent的四层架构、MCP连接、RAG实战与成本评估全流程
本文基于B站Edureka教程,系统拆解了从Demo级到生产级AI Agent的完整构建路径。文章首先以AI七模块演进图谱说明Agent建立在全部前序技术之上,核心差异在于推理、任务执行与工具调用。随后给出生产级四层架构:用户界面层、智能体层(监督/规划/执行/记忆四类Agent)、记忆与知识库层、处理编排与大模型接口层。MCP协议通过Host-Client-Server链路标准化Agent与外部工具的连接。实战部分用ChromaDB+sentence-transformers构建RAG,用FastMCP接入天气服务,通过Anthropic API调用Claude完成本地部署与验证。最后讨论了Token成本、上下文窗口与多模型交叉验证的评估框架。
从零构建生产级AI Agent:RAG与MCP实战指南
大多数开发者对AI Agent的理解还停留在“调用API+提示词”的阶段,但真正要把一个Agent投入生产环境,需要解决的问题远不止这些:如何设计多智能体协作架构?如何用RAG让模型回答私有知识?如何通过MCP协议连接外部工具?如何评估模型选型的成本与性能?本文基于B站Edureka教程的完整实战内容,拆解一个生产级AI Agent从架构设计到本地部署的全流程。
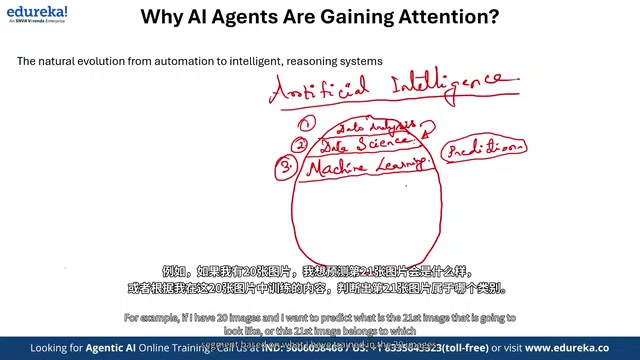
AI演进图谱:为什么Agent是第七个模块
Edureka将AI的发展拆解为七个递进模块:数据分析、数据科学、机器学习、深度学习、NLP/计算机视觉、生成式AI、Agentic AI。这个分层框架的价值在于揭示了一个关键事实——Agent并非凭空出现,而是建立在全部前序模块的骨干之上。
传统自动化依赖预定义规则,灵活性有限;生成式AI解决了内容生成和对话交互的问题;而Agentic AI在此基础上增加了推理、任务执行和工具调用能力。讲座中用一个形象的类比说明了这种差异:如果只训练过生成式AI课程的学生去解微积分题,他答不出来,因为灵活性受限于训练范围。Agent则不同,它可以通过多模型交叉验证来规避单一模型的幻觉风险——当一个模型算出10×5=48时,Agent可以调用另一个模型进行验证。
这种“不盲信单一模型输出”的设计哲学,是Agent区别于普通聊天机器人的核心所在。
RAG(检索增强生成) 是解决大模型“知识陈旧”和“私有知识缺失”问题的关键技术。其核心思路是:在模型生成回答前,先从外部知识库中检索与用户问题相关的文档片段,将这些片段作为上下文注入提示词,再由模型基于这些事实依据生成回答。完整RAG流程包含索引(文档切片、嵌入、存入向量库)和检索生成(问题嵌入、相似度搜索、上下文拼接、LLM生成)两个阶段。相比微调,RAG无需重新训练模型,知识更新只需更新向量库,更适合企业私有知识的动态管理。本文实战中ChromaDB+all-MiniLM-L6-v2的组合正是RAG的典型实现。
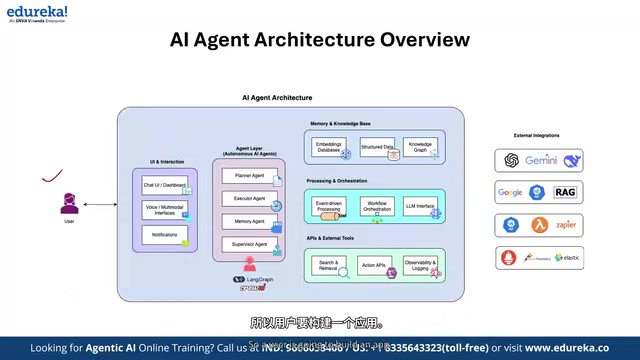
生产级AI Agent的四层架构
教程给出的标准AI架构覆盖了70%-80%的通用场景,分为四个核心层次:
用户界面与交互层
无论面向内部还是客户,UI层都是解决方案的入口。它承载领域标识(金融、零售、电商、制造)、多模态输入(语音、图片、文本)以及任务通知机制。没有UI的纯后端Agent很难被销售和采用——这一点在实际交付中经常被技术团队忽视。
智能体层:四种角色的分工
这是整个架构的处理核心,包含四类智能体:
- 监督智能体:扮演“经理”角色,汇总各Agent状态,判断任务是否完成、是否存在阻塞、是否需要转交。
- 规划智能体:决定任务是顺序执行还是并行处理。当任务超出单次上下文窗口时,由它决定拆分成几个批次——如果使用GPT系列模型(约20万上下文),可能需要分4批;如果使用Anthropic的Claude系列(可达40万上下文),分2批即可。
- 执行智能体:类似Jira工单系统,领取并执行分配给自己的具体任务。
- 记忆智能体:管理短期与长期记忆,决定哪些信息需要持久化。
LangGraph和CrewAI等框架提供了构建这些智能体的底层能力。
记忆与知识库层
以哈佛入学考试机器人为例:1500份PDF(历年试卷、标准答案、评分记录)需要经过嵌入、切片、存储,构建成可检索的知识库。这是RAG系统的数据基础。
处理编排与大模型接口层
事件驱动处理(如HR入职触发薪资流程)和工作流编排(顺序/并行)在这一层完成。大模型接口层则提供了在多模型间切换的灵活性——市场上主流厂商提供60-70个模型,Hugging Face上更有200多个可选。
MCP协议:Agent连接外部世界的标准接口
模型上下文协议(MCP)是教程重点讲解的连接层。它的核心价值是标准化Agent与外部工具的交互方式。
MCP的调用链路是:MCP Host(VS Code、Cursor、Claude Code等IDE或平台)→ MCP Client → MCP Server。教程中演示了三种典型的Server场景:从Google Drive读取文档并导入开发环境、连接PostgreSQL/MySQL/MongoDB等数据库进行读写分析、通过Web API连接天气服务或GitHub/Slack等平台。
这种设计的精妙之处在于,每个数据源或工具都可以作为独立的MCP Server被调用,Agent无需为每个集成点编写定制代码。
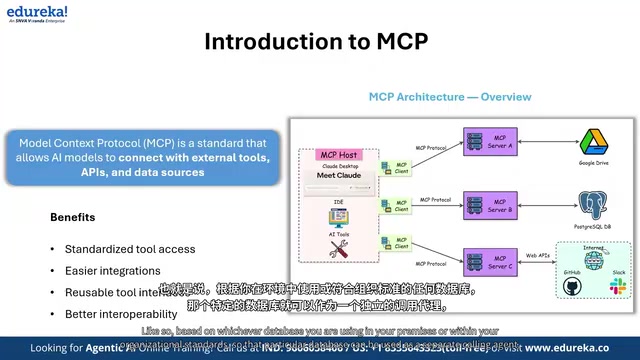
MCP(Model Context Protocol) 是由Anthropic于2024年底提出的开放协议,旨在统一大模型应用与外部数据源、工具之间的连接方式。在MCP出现之前,每个Agent集成新工具都需要编写定制化的适配代码,形成“N个模型×M个工具”的集成爆炸。MCP采用客户端-服务器架构:Host(如IDE、Agent运行时)内置MCP Client,通过标准化的JSON-RPC协议与MCP Server通信;每个Server封装一类资源(文件系统、数据库、API),对外暴露工具(Tools)、资源(Resources)和提示模板(Prompts)三类能力。这种解耦设计让Agent可以即插即用地接入任意符合MCP标准的工具,极大降低了集成成本,也被视为Agent生态互联的基础设施。
实战:RAG + MCP的本地Agent构建
教程的实战项目将RAG和MCP结合,构建了一个能回答私有知识并查询实时天气的Agent。技术栈如下:
- 向量数据库:ChromaDB(开源免费),用于存储嵌入后的多维语义数据
- 嵌入模型:sentence-transformers的all-MiniLM-L6-v2小型语言模型,专门用于语义搜索
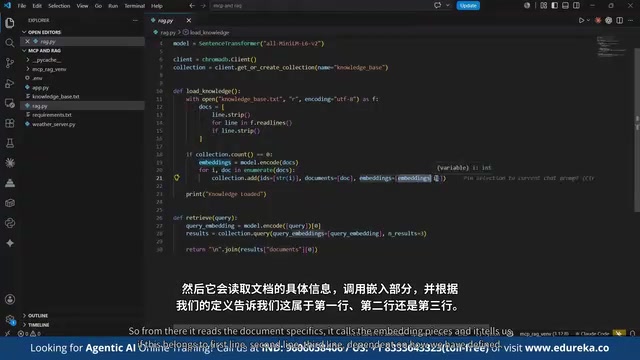
- RAG流程:读取knowledge_base.txt → 逐行分割(line_strip)→ 嵌入 → 存入ChromaDB集合 → 检索时返回相似度最高的前3条结果
- MCP天气服务:基于FastMCP构建,调用开源天气API,支持班加罗尔、伦敦、孟买三个城市
- 大模型:通过Anthropic API调用Claude
代码中几个值得注意的工程细节:使用.env文件管理API密钥,避免密钥泄露导致高额账单;在app.py中通过异步调用(asyncio)协调RAG检索和MCP工具调用;系统提示词明确定义了Agent的检索上下文格式和工具输出格式。
部署与验证
教程展示了完整的本地部署流程:创建虚拟环境 → 安装依赖(anthropic、chromadb、sentence-transformers等)→ 激活环境 → 运行app.py。Agent启动后加载向量嵌入,进入交互循环,输入exit退出。
验证环节出现了真实开发中常见的问题:首次运行时模型名称已过期,需要从Claude Opus 4切换到Opus 3.5才能正常调用。修正后,Agent正确回答了“哪个是最好的大语言模型”(基于知识库中的预设答案gpt-4o-mini),也正确处理了“伦敦当前天气”的MCP调用,返回温度约20摄氏度并提示有雨。
有趣的是,当询问“瑞士天气”时,Agent没有返回MCP格式的响应,而是给出了通用的大模型模板回复——因为天气服务器只配置了三个城市,瑞士不在范围内。这个细节恰好验证了意图识别和工具调用的边界条件。
ChromaDB 是一款开源的嵌入式向量数据库,专为LLM应用的语义检索场景设计。它以“集合(Collection)”组织数据,每个集合存储文档片段及其对应的嵌入向量和元数据,支持基于余弦相似度或欧氏距离的近似最近邻检索。ChromaDB的最大优势是轻量——可以作为Python库直接嵌入应用进程,无需独立部署服务端,同时支持持久化到本地磁盘。本文中使用line_strip逐行切分文档,是因为该知识库为问答对格式,每行即一个完整语义单元,无需采用固定长度重叠切片;而检索时返回Top-3结果,是在召回率与提示词长度/成本之间取的常见平衡点。
sentence-transformers的all-MiniLM-L6-v2 是一个仅约22M参数的轻量级嵌入模型,通过知识蒸馏从更大的教师模型训练而来,在保持语义检索质量的同时将推理速度提升数倍,输出384维向量。它适合本地CPU运行,是原型和中小规模RAG系统的常见默认选择;当知识库规模或语义精度要求提高时,可替换为BGE、E5等更大嵌入模型。
成本优化与模型评估
教程提到的评估维度值得单独关注:Token数量、输入Token成本、输出Token成本、总容量成本。当Gemini或Claude成本过高时,需要评估替代模型。这里的权衡逻辑与规划智能体的分批次策略直接相关——上下文窗口越大的模型单价越高,但可能减少调用次数,总成本需要综合计算。
评估还包括回答质量的衡量:模型思考方式是否正确、输出是否符合预期目标。多智能体架构的一个隐性优势正在于此——通过交叉验证可以低成本地发现幻觉。
上下文窗口(Context Window) 指模型单次调用所能处理的最大Token总量(输入+输出),是Agent规划任务分批的核心约束。当待处理文档总Token数超过窗口时,规划智能体会将其拆分为多个批次分别处理,每批次的输入Token都会重复计入成本。因此总成本并非简单等于“单价×文档量”,而是与窗口大小强相关:窗口越大,批次数越少,但单Token单价通常更高;窗口越小,单价低但批次多、重复开销大。实际选型时需建立“总成本=批次数×单批Token数×单价”的估算模型,并结合响应延迟和回答质量综合评估,而非仅比较每百万Token的标价。
写在最后
这套方案的完整产出物可以推送到AWS、GCP、SAP或任何Cloud Foundry应用,本地开发无需云端权限。对于想从Demo级Agent迈向生产级的开发者,教程提供的四层架构、MCP标准化连接和成本评估框架,构成了一个可复用的起点。真正的挑战不在于把Agent跑起来,而在于让它稳定、可观测、可扩展——这正是“生产级”三个字的重量。
相关推荐

Codex云端模式详解:环境配置与适用场景
本文详细解析Codex云端模式的工作原理、环境配置步骤及适用场景,包括如何创建环境、连接GitHub仓库、设置定时任务,并对比云端与本地模式的差异,帮助开发者高效利用Codex。

Claude Code免费使用真相:三条路与一个骗局
Claude Code 免费使用是否可行?本文拆解 Pro、Max 的真实成本(含汇率与税费)、社区免费方案的技术原理与隐私代价,以及假安装包、钓鱼页面等安全陷阱,并给出访客通行证、开源贡献者计划和本地模型三条合法免费路径。

REA:无需编码,用AI逆向任意应用
REA是一款爆火GitHub的开源AI逆向工程工具,可让Claude、Codex等AI代理直接分析任意应用并生成功能克隆,无需编码。本文介绍其工作原理、安装方法、实测案例及法律风险。