从零理解AI智能体:感知、决策、行动的核心闭环

本文系统介绍智能体的本质、三大核心能力、三代技术演进及关键技术栈。
文章从"传统程序与智能体的本质区别"切入,用售货机和助手的类比说明:传统程序固定输入固定输出,智能体则能理解模糊意图并动态生成结果。智能体的能力被拆解为感知、决策、行动三个闭环环节,分别对应多模态输入、大语言模型推理和工具调用执行。技术演进方面,文章梳理了从规则引擎(第一代)、NLP意图识别(第二代)到"大模型+工具调用+记忆系统"(第三代)的三代发展历程。最后,文章列出构建现代智能体所需的四项关键技术——LLM、工具调用、记忆系统和RAG检索增强,并以客服助手、数据分析、个人效率管家为例展示落地场景,为进一步学习LangChain等开发框架奠定概念基础。
传统程序与智能体的本质区别
人工智能技术近年来渗透进生活的方方面面——智能聊天机器人、自动驾驶、智慧医疗都是典型代表。用户对这些产品的体验往往两极分化:好用的会被认可为“人工智能”,难用的则被调侃为“人工智障”。而决定体验好坏的关键,恰恰在于后端采用的技术。近几年兴起的智能体(Agent),正是让产品变得“好用”的核心技术之一。
要理解智能体,先要看清它与传统程序的差异。传统程序有一个通用特征:输入固定指令,输出固定结果。这类似生活中的自助售货机——你选定可乐、投入钱币,它就把对应产品送出,不会有任何变化。无论用 Java、Python 还是其他语言,传统程序的逻辑都是预先写死的。
智能体则更像一个拥有思考能力的助手。当你给它一个模糊的需求,比如“我五一想去旅游”,它会自动分析五一期间适合出行的目的地、结合当前城市和交通状况给出推荐。它不需要你提供精确指令,而是能理解意图、动态生成结果。
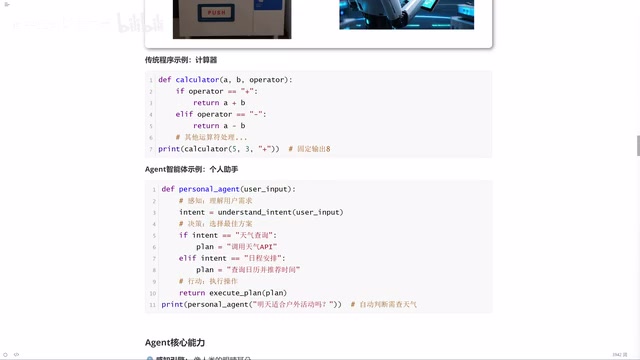
用代码对比更直观。传统计算器函数接收两个数字和一个运算符,输出结果完全可预期;而智能体函数只需传入自然语言需求,它会先理解用户想要什么,再决定如何反馈。重点在于输入内容可以是模糊的——用户可能说“帮我看看今天天气”或“后天适合出去玩吗”,智能体都能识别出这是“天气查询”意图,进而调用对应工具返回结果。
智能体的三大核心能力
智能体的能力可以拆解为一个闭环:感知、决策、行动。
感知引擎
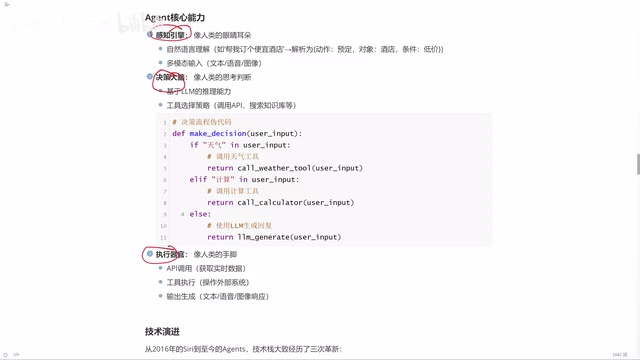
感知引擎相当于人类的眼睛和耳朵,负责接收和理解外界输入。当你对智能体说“帮我订一个便宜的酒店”,它会通过自然语言理解拆解出三个要素:动作是“预订”、对象是“酒店”、条件是“低价”。
更重要的是,感知引擎不局限于文本。语音、文字、图像都可以作为输入,这种多种类型输入的支持被称为多模态。多模态让智能体的感知能力更接近人类对世界的综合认知。
决策大脑
感知到输入之后,智能体需要做逻辑判断,决定该怎么做,这就是决策大脑的职责。它基于大语言模型(LLM)的推理能力工作,市面常见的 GPT、DeepSeek广告、通义等都属于此类。用户输入数据后,模型进行思维判断,得出应当反馈什么内容、需要调用哪些函数。
大语言模型(LLM)本质上是基于海量文本数据训练的概率模型,其核心机制是预测给定上下文后最合理的下一个词(Token)。以 GPT 系列为代表,这类模型通过"Transformer"架构实现对长距离语义关系的捕捉,使其能理解模糊表达背后的真实意图。在智能体场景中,LLM 不仅承担"理解"任务,还要完成"规划"——即将用户的一句话拆解成若干可执行子任务,并判断每个子任务需要调用哪个工具。这种能力也被称为"推理+规划"(Reasoning & Planning),是第三代智能体区别于前两代最核心的跃迁。不同模型在推理深度、上下文窗口长度和工具调用准确率上存在差异,这直接影响智能体在复杂任务中的表现。
执行器官
决策完成后,执行官负责落地。它调用相应的函数或硬件来完成实际操作,就像人类的手脚。至此,感知—决策—行动的闭环完整走通:感知用户需求、判断该做什么、最后执行并返回结果。
工具调用(Tool Calling / Function Calling)是第三代智能体实现"行动"的关键机制。其原理是:开发者预先向模型声明一批可用函数(如"查天气""订酒店""发邮件"),并描述每个函数的用途和所需参数;当模型判断需要使用某工具时,它不会直接执行代码,而是输出一段结构化的 JSON 描述(指定函数名和参数值),由外部程序真正调用该函数并将结果返回给模型,模型再据此生成最终答案。这种"模型决策、代码执行"的分工,既发挥了 LLM 的语义理解优势,又保留了传统程序对真实系统的精确控制能力,是连接"语言世界"与"现实操作"的桥梁。
智能体的技术演进:三代革新
从早期的 Siri 到小爱同学、小度,智能助手大致经历了三代技术革新。
第一代基于规则引擎和固定模板。你问“现在几点”,它能准确回答;但你换个说法要求“帮我调整时间”,它就识别不了,只会回复“听不懂你的指令”。只要不是预设指令,一律失效。如今市面上的部分智能音箱仍停留在这一阶段。
第二代引入 NLP 模型和意图识别,能初步理解需求,不再因为换个说法就失效。但它缺少记忆系统——你先问“今天天气怎么样”,再追问“今天适合出去玩吗”,它无法关联上一轮对话,每次提问都相当于一次全新会话。
第三代是大语言模型 + 工具调用 + 记忆系统的组合。无论问题多模糊、多刁钻,都能通过大模型分析出真实需求,再调用对应工具(不限于内置函数,还可能是数据库、摄像头等外部资源)。同时,记忆系统让它记住此前的操作,支持多步骤连续任务。这正是当下主流智能体所处的阶段。
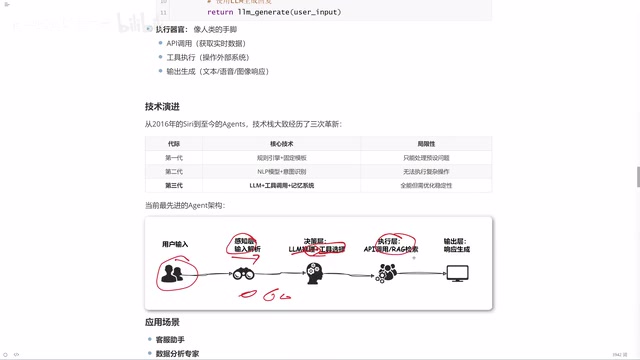
从整体架构看,一个先进智能体的工作流程是:用户输入需求 → 感知层分析关键词 → 大模型推理并选择工具 → 执行层调用 API 或 RAG 数据库 → 生成结果并返回。
典型应用场景
智能体的落地场景已经相当丰富。
客服助手是最常见的一类。早期客服机器人回复死板,而应用了智能体技术的平台,回复更有“人味”,交互体验接近真人。
数据分析专家能在接收数据后自动完成常见的基础分析,也可以根据用户提出的具体需求进行定向分析。
个人效率管家则处理生活化任务。比如“明早9点提醒我提交报告并推荐通勤路线”,智能体会拆解成两件事:创建日历事项、查询实时交通,分别执行后统一反馈。
技术栈解析:搭建智能体需要什么
真正动手做一个智能体,需要掌握几项关键技术。
- 大语言模型(LLM):智能体的“大脑皮层”,负责理解、推理和内容生成,如 GPT-4、Claude、DeepSeek。
- 工具调用:大模型判断出要做什么后,通过调用工具完成执行,开发者无需自己实现所有底层功能。
- 记忆系统:相当于“海马体”,让智能体记住此前操作,支持多步骤任务。记忆又分短期记忆和长期记忆。
- 检索增强(RAG):可选但强烈推荐。由于大语言模型基于历史数据训练,知识可能陈旧,RAG 通过外部检索补充最新信息,弥补这一短板。

用代码对比更能体现差异:传统程序的字符串模板固定不变,你传入什么都套进同一个流程;而智能体是动态响应的,它会根据需求判断,经不同结果反馈不同内容。核心区别就在于“动态”而非“固定”。
RAG(Retrieval-Augmented Generation,检索增强生成)的工作原理值得单独说明。大语言模型的训练数据有截止日期,对训练后发生的事件一无所知,且无法访问企业私有文档。RAG 的解决思路是:在模型生成回答之前,先从外部知识库(如向量数据库)中检索与问题最相关的文本片段,将这些片段连同用户问题一起送入模型,让模型基于"实时补充的上下文"生成回答。向量数据库的核心是将文本转化为高维向量,通过计算语义相似度实现快速检索,而非传统的关键词匹配。这使得智能体既能利用大模型的推理能力,又能访问最新或私有信息,有效弥补了"知识过期"和"数据孤岛"两大痛点。
小结
理解智能体,抓住三条主线即可:一是它与传统程序的本质区别——固定输入输出 vs 动态感知决策行动;二是感知、决策、行动的核心闭环;三是构成现代 Agent 的技术栈——大语言模型、工具调用、记忆系统与 RAG 检索增强。掌握这些基础概念,才能进一步展开 LangChain、Ollama 等具体框架的实战开发。
相关推荐

Normalizing Trajectory Models:让少步生成重拾精确似然框架
Normalizing Trajectory Models(NTM)将扩散模型反向过程的每一步建模为条件归一化流,实现少步生成下的精确似然训练,兼顾速度与概率框架完整性,突破蒸馏与一致性训练的局限。

LangGraph生产级实战:五年Agent架构经验的沉淀
一位五年Agent开发老兵开源LangGraph生产级参考项目并撰写博客系列,分享从条件树到图状态机的架构演进经验,剖析LangGraph在可维护性与团队协作上的真正价值。

Claude Opus 15分钟逆向工程麦克风:AI为Linux补齐硬件支持
一位Reddit用户用Claude Opus在15分钟内逆向工程Maono DGM20麦克风,使其在Linux上可调节设置,并封装为系统服务与Web UI开源发布。本文解析AI编程助手如何降低硬件逆向门槛,补齐长尾设备的Linux支持。