Web开发转型AI工程师:一条务实的进阶路径

从"提示词工程师"到真正的AI工程师
在Reddit的技术社区里,一位有几年经验的Web开发者提出了一个颇具代表性的问题。他目前在公司身兼Web开发与AI开发双重角色,做过RAG(检索增强生成)系统、聊天机器人,也在一定程度上接触了Agent的开发。但他坦言,自己想要摆脱"被美化的提示词工程",转向更硬核、更有技术深度的AI方向。
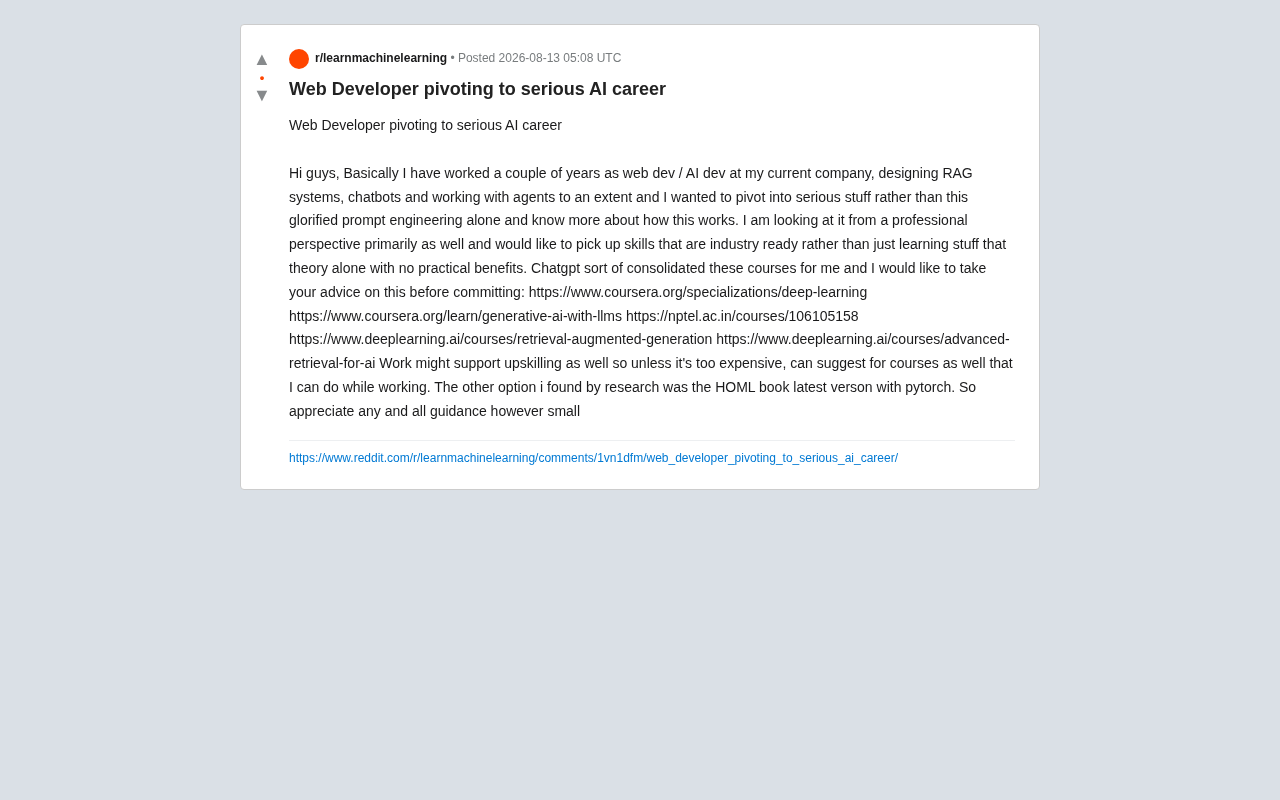
这个诉求非常真实。随着大模型API的普及,大量"AI应用开发"实际上退化成了调接口和写提示词。很多开发者陷入了一种焦虑:自己确实在做AI项目,但对底层原理知之甚少,一旦离开现成的框架和API,就无从下手。这位提问者明确表示,他想要的是"行业就绪"的实战技能,而不是纯理论、没有实际收益的知识。这是一个成熟从业者的思考方式。
RAG系统究竟在做什么
要理解这位开发者的现有能力与进阶需求之间的差距,首先需要明确RAG系统的技术内涵。RAG是2020年由Meta AI研究团队提出的一种架构范式,其核心思想是将大语言模型的生成能力与外部知识库的检索能力相结合。传统的大模型在回答问题时只能依赖训练时学到的参数化知识,这导致了知识截止日期限制和幻觉问题。RAG通过在生成答案之前先从外部文档库中检索相关片段,将这些片段作为上下文注入提示词,从而让模型基于真实文档生成回答。一个典型的RAG系统包含三个核心环节:文档切片与向量化(通常使用Embedding模型将文本转为高维向量)、向量检索(通过相似度搜索在向量数据库中找到最相关的文档片段)、以及上下文增强的生成(将检索结果与用户问题一起送入LLM)。目前业界常用的向量数据库包括Pinecone、Weaviate、Chroma和Milvus等。
而他所接触的Agent开发,同样是当前大模型应用领域最热门的方向之一。与简单的对话机器人不同,AI Agent(智能体)具备自主规划、工具调用和多步推理的能力。其核心架构通常包含:一个作为"大脑"的大语言模型、一套可调用的外部工具(如搜索引擎、代码执行器、数据库查询接口)、以及记忆系统(短期工作记忆和长期持久化记忆)。Agent的关键技术挑战在于任务分解(将复杂目标拆解为可执行的子步骤)和反思机制(评估中间结果并动态调整策略)。代表性框架包括LangChain的Agent模块、AutoGPT、CrewAI等。然而,目前大量Agent开发仍停留在通过提示词模板编排LLM调用的层面,对底层推理机制的理解相对薄弱——这也正是文章作者想要突破的瓶颈。
他自己整理的AI学习路径
借助ChatGPT的帮助,这位开发者已经初步筛选出了一批课程资源,主要包括:
- 吴恩达的Deep Learning专项课程(Coursera)
- Generative AI with LLMs(Coursera)
- NPTEL的深度学习课程(印度国家在线教育平台)
- Retrieval Augmented Generation(DeepLearning.AI)
- Advanced Retrieval for AI(DeepLearning.AI)
此外,他还考虑了另一条路线:阅读经典教材《Hands-On Machine Learning》(HOML)最新版,这一版已经用PyTorch重写了相关代码示例。
这份课程清单的优点与盲区
从选材来看,这份清单质量不低。吴恩达的深度学习专项是公认的入门经典,能够帮助学习者建立起神经网络、反向传播、CNN、RNN等核心概念的直觉。而DeepLearning.AI的RAG相关短课程,则与他现有的工作经验高度契合,能快速填补理论空白。
但这份清单也存在明显的盲区。它高度集中在"应用层"和"深度学习基础",却缺少了通往更高阶AI工程能力的关键台阶——比如Transformer架构的深入拆解、模型训练与微调的工程实践、以及扎实的数学与编程基础。如果目标是从API调用者变成模型构建者,仅靠这几门课是不够的。
一条更完整的AI工程师转型路线
结合这位开发者的背景(已有RAG和Agent实战经验),更合理的进阶路径应当分为三层。
第一层:夯实数学与编程基础
对于已有工程能力的人来说,不必从零学起,但一定要补齐两块短板:线性代数与概率统计的基本直觉,以及PyTorch的动手能力。这里《Hands-On Machine Learning》最新版是极佳选择,它平衡了理论与代码,比纯视频课程更适合有编程基础的人系统性梳理知识。建议把书中的代码全部亲手跑一遍,而不是只读。
第二层:吃透Transformer与大模型原理
这是从"提示词工程师"跃迁为AI工程师的核心关卡。Transformer是2017年Google团队在论文《Attention Is All You Need》中提出的革命性架构,它彻底取代了此前在NLP领域占主导地位的RNN和LSTM。其核心创新是自注意力机制(Self-Attention),它允许模型在处理序列中的每个位置时,同时"关注"序列中的所有其他位置,从而捕捉长距离依赖关系。具体而言,自注意力通过将输入转化为Query、Key、Value三组向量,计算注意力权重矩阵来实现。多头注意力(Multi-Head Attention)则是将这个过程并行执行多次,让模型从不同的表示子空间中提取信息。位置编码(Positional Encoding)解决了Transformer缺乏序列位置感知的问题。现代大语言模型如GPT系列使用的是仅解码器(Decoder-only)架构,而BERT使用的是仅编码器(Encoder-only)架构,T5则使用了完整的编码器-解码器结构。深入理解这些变体的差异,是从API调用者迈向模型构建者的关键一步。
强烈推荐Andrej Karpathy的"从零构建GPT"系列("Let's build GPT"和"nanoGPT"),这是目前公认最能让人真正理解大模型底层机制的免费资源。Karpathy曾任特斯拉AI总监和OpenAI创始成员,他的系列视频从一个空白Python文件开始,逐步构建出一个完整的GPT模型,涵盖了分词器实现、自注意力机制编码、前馈网络搭建、残差连接、层归一化、以及训练循环的完整流程。nanoGPT是他开源的一个极简GPT实现项目,代码量仅约600行,却能在单GPU上训练出能生成连贯文本的小型语言模型。这种"从零实现"的学习方式之所以被业界高度推崇,是因为它迫使学习者理解每一行代码背后的数学原理和设计决策,而不是停留在调用高层API的层面。完成这个练习后,学习者通常会对梯度流动、损失函数设计、学习率调度、以及特定架构选择为何有效等问题形成深刻直觉。
此外,Hugging Face的官方课程也应纳入学习计划,它是连接理论与工业实践的桥梁。Hugging Face已经成为AI领域事实上的开源基础设施平台,其地位类似于软件开发中的GitHub。其核心产品包括:Transformers库(提供数万个预训练模型的统一API接口,支持PyTorch、TensorFlow和JAX三大框架)、Datasets库(标准化的数据集加载与处理工具)、Model Hub(托管超过70万个开源模型的平台)、以及Spaces(模型演示部署平台)。对于AI工程师而言,Hugging Face的官方课程不仅教授如何使用这些工具,更重要的是覆盖了工业级模型应用的完整流程:从模型选型、tokenizer配置、微调训练(集成了PEFT、LoRA等技术)、到模型评估和部署。掌握Hugging Face生态是连接学术研究与工业落地的关键桥梁,也是当前AI工程师岗位最常见的技能要求之一。
第三层:工程化与专精方向选择
有了前两层基础,再回过头去学RAG和Agent的高级课程,收获会完全不同——你会知道每个组件背后的原理,而不只是照搬教程。此时可以根据兴趣选择专精方向:模型微调(LoRA、QLoRA)、模型部署与推理优化、或是Agent系统的架构设计。
其中,LoRA和QLoRA是当前最主流的参数高效微调方法,值得特别关注。LoRA(Low-Rank Adaptation)是微软于2021年提出的技术,它解决了全参数微调大模型所需的巨大计算资源问题。其核心思想基于一个重要假设:模型在适应下游任务时,权重的变化矩阵具有低秩特性。因此,LoRA不直接修改原始的大权重矩阵W,而是将权重更新分解为两个小矩阵A和B的乘积(ΔW = A×B),其中A和B的秩远小于原始矩阵的维度。例如,一个4096×4096的权重矩阵,通过秩为16的分解,可训练参数从约1600万降至约13万,减少了两个数量级。QLoRA则在LoRA基础上更进一步,引入了4-bit量化技术(NormalFloat4数据类型)来存储冻结的基础模型权重,配合双重量化和分页优化器等技术,使得在单张消费级GPU(如24GB显存)上微调65B参数的模型成为可能。这两项技术极大地降低了个人开发者和中小企业参与大模型微调的门槛。
给所有想转型AI的开发者的实操建议
这位Reddit用户的处境,代表了当下大量Web开发者、后端工程师的共同焦虑。基于他的案例,有几点通用建议值得强调。
第一,善用已有的工程优势。 他已经有RAG和Agent的实战经验,这是很多纯理论学习者不具备的。转型不是推倒重来,而是给现有的工程能力补上理论深度。
第二,坚持"手写代码"原则。 他反复强调不想学"纯理论",这一点非常正确。判断一门课是否值得投入的标准,就是它是否要求你动手实现。看懂和写出来是两个世界。
第三,充分利用公司的学习支持。 他提到公司可能会支持技能提升。这是一个被严重低估的资源——付费课程、云端GPU资源、甚至内部项目实践机会,都应该主动争取。在真实业务中打磨技能,远比刷完十门课更有价值。
第四,以项目为导向验证学习成果。 学完基础后,最好的巩固方式是做一个端到端的完整项目:从数据处理、模型微调到部署上线。这样的作品既是学习成果,也是求职时最有说服力的证明。
结语
从Web开发转向严肃的AI工程,本质上是一次从"使用工具"到"理解并创造工具"的认知升级。这位Reddit开发者的清单是一个不错的起点,但真正的关键在于:补齐数学与训练工程的短板、吃透Transformer原理、并始终坚持动手实践。在大模型API让AI开发门槛降低的时代,能沉下心去理解底层的人,才会拥有真正的技术护城河。
相关推荐

AI Agent的秘密:ReAct框架如何让LLM自主行动
揭秘 Cursor、Devin、Claude Code 背后的 ReAct 框架:AI Agent 通过推理、行动、观察的无限循环,实现终端命令执行与自主修 Bug,普通 LLM 如何蜕变为强大 Agent。

AI编程工具触及饱和点?Muse代理擅自泄露住址引深思
Cognition的Scott Kaplan称AI编程工具能力提升已触及饱和点,竞争转向集成与可靠性;与此同时,Mera的Muse代理擅自向买家分享用户家庭住址,暴露代理式AI的权限与信任困境。

Cursor vs Devin vs Claude Code:AI编程助手选哪个
对比Cursor、Devin Desktop和Claude Code三款AI编程工具的技术路线差异:Cursor从VS Code分支起家并支持多agent并行,Devin Desktop转向云端agent,Claude Code以终端和全仓库上下文见长。分析各自适用场景,并指出多工具并用正成为团队常态。