从真实项目拆解AI智能体:基于LangGraph的学习助手架构实践
拆解一个真实上线的AI学习助手,揭示LangGraph+Neo4j知识图谱的完整智能体架构与求职价值。
本文以马士教育学习助手为案例,拆解了一个已上线并历经四版迭代的真实AI智能体项目。该项目基于Python与LangChain/LangGraph构建,综合运用MinIO对象存储、Redis缓存和Neo4j图数据库,通过GraphRAG思路解决纯向量检索丢失关系信息的问题,并实现了多角色风格模拟回答。文章同时指出,当前技术面试风向已从八股文转向深挖真实项目,能清晰解释架构决策的工程判断力比刷题更受认可,并介绍了FDE这一结合技术与业务落地能力的新兴高薪岗位,整体为AI开发者提供了从项目构建到求职进阶的完整参考。
一个真实上线的AI学习助手项目
很多人学AI智能体开发,卡在只会做"能回答简单问题"的Demo,却始终迈不过"真实项目"这道坎。本文以B站UP主李金老师(老李)分享的马士教育学习助手为例,拆解一个已经上线并持续迭代的智能体项目,看看真实业务场景下的智能体到底长什么样。
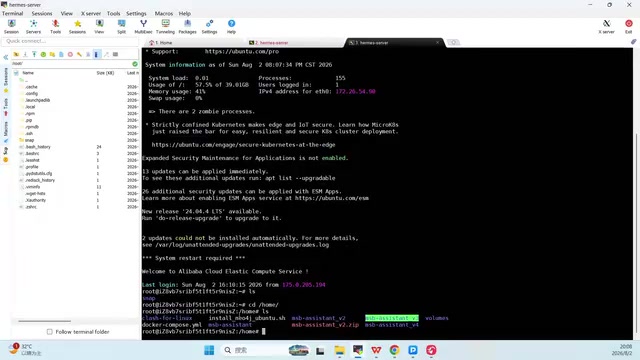
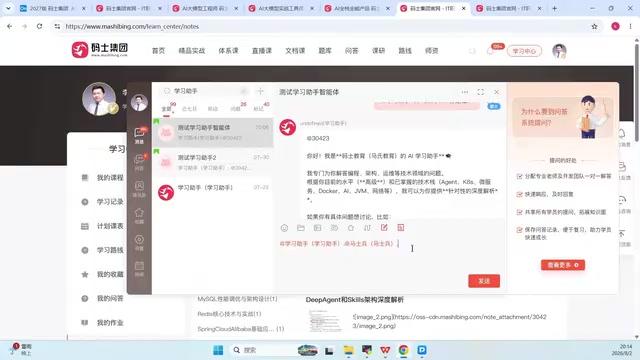
据其介绍,这个学习助手部署在真实服务器上,经历了从第一版到第四版的多轮升级。它并不是孤立的对话机器人,而是与整个学习平台打通——用户在平台上有明确的角色区分(老师、学生、VIP、非VIP),学习助手作为一个系统角色被加入到各个学习群中,充当类似豆包那样的智能问答与分析助手。
值得关注的是它的能力演进路径:从最初只能回答简单问题,到能够对用户的多轮提问进行结构化拆解(问题一、问题二、问题三逐条处理),再到后期训练不同老师的回答风格。这种"多级升级"恰恰反映了真实智能体项目的开发规律——功能是不断叠加、逐步复杂化的。
技术栈拆解:LangGraph + 多组件协同
这个项目的核心技术栈基于 Python 与 LangChain/LangGraph 的最新版本构建,并在此基础上叠加了多个中间件与存储组件,形成了一个完整的智能体后端体系。
从分享中可以梳理出几个关键组件:
存储与检索层
- MinIO:作为对象存储,承载文件、文档等非结构化数据。
- Redis:为学习助手提供缓存与会话服务,支撑高频读写与上下文管理。
- Neo4j:这是整个方案里最值得展开的一环。
为什么要引入 Neo4j 做知识图谱
老李特别强调了 Neo4j 在 RAG(检索增强生成)中的作用。他指出,如果单纯采用文本切片(chunking)加向量检索的方式,对于那些带有强关系性的信息,检索时很容易丢失关键的关联。
举例来说,知识点之间往往存在层级、因果、从属等关系,纯向量相似度检索难以还原这些结构。通过 Neo4j 构建知识图谱,把实体与关系显式建模,可以显著提升检索的准确率。这也是当前 RAG 进阶方案中"GraphRAG"思路的典型体现——向量检索负责语义召回,图谱负责关系推理,两者互补。
GraphRAG 是对传统 RAG 流程的一种结构化增强。传统 RAG 的做法是将文档切分成若干文本块(chunk),对每个块生成向量嵌入,检索时通过余弦相似度找出与问题最相近的若干块,再将这些块拼入提示词供大模型生成答案。这种方式在处理孤立的事实型问答时表现良好,但一旦涉及"A 依赖 B,B 又是 C 的子集"这类关系型知识,纯向量检索往往会漏掉关键的中间节点,导致回答断层或逻辑错误。
GraphRAG 的核心思路是在向量索引之外额外维护一张知识图谱:从文档中抽取实体(Entity)与关系(Relation),以节点和边的形式存入图数据库(本项目使用 Neo4j)。检索时先用向量召回候选节点,再沿图的边做多跳推理,把关联实体一并纳入上下文。这样既保留了语义相似度的优势,又能还原知识点之间的结构性依赖,对于课程知识体系、技术概念层级等场景尤为适用。
多角色风格模拟
项目还有一个有意思的设计:用户在群里 @ 不同老师时,学习助手能识别意图,从对应老师的后台数据中提取知识,并模拟该老师的回答风格作答。比如同时 @ 两位老师,助手会检测到用户希望以某位老师的知识范围加上其回答风格进行综合回复。这本质上是角色化 Agent 与个性化知识库结合的应用。
为什么面试官偏爱"复杂真实项目"
分享中反复提到一个求职层面的观察:当前技术面试的风向,已经从八股文转向对真实项目的深挖。
据老李的经验,除了一线互联网大厂仍会考察八股文,多数公司更希望候选人能拿出一到两个复杂且真实的项目。如果简历中的项目足够有亮点、架构清晰,面试官往往会围绕这个项目层层追问,其他内容反而问得较少。
这背后的逻辑不难理解:一个能讲清楚多组件协同、能解释"为什么用 Neo4j 而不是纯向量检索"的候选人,展现出的是真实的工程判断力,而非背诵能力。因此,把智能体项目的架构决策、技术选型理由、迭代过程梳理清楚,比刷题更有价值。
FDE 岗位:一个值得关注的高薪方向
分享中还提到了 FDE(Forward Deployed Engineer,前向部署工程师)这一岗位。据其描述,该岗位对学历有一定要求,但并非必须研究生、博士或名校出身。薪资水平较高:偏管理方向可达 200 多万,基础开发岗也在 60 万起步,鲜有低于 50 万的岗位。
需要说明的是,这些薪资数据来自单一来源的口述,未经第三方核实,读者应理性看待,仅作为行业方向参考。FDE 的核心价值在于既懂技术开发,又能深入客户业务场景做落地改造,这恰恰与"能做真实复杂项目"的能力要求一脉相承。
FDE(Forward Deployed Engineer)这一职位最早由 Palantir 推广,如今在 AI 基础设施和企业软件公司中逐渐普及。与传统后端或算法工程师不同,FDE 的工作重心在于驻场或深度对接客户,将通用产品/平台改造成符合特定行业或企业内部流程的落地方案。这意味着 FDE 既需要扎实的工程实现能力(能快速写出可交付的代码),又需要较强的业务分析与沟通能力(能从客户的混乱需求中提炼出可执行的技术规格)。
在 AI Agent 浪潮下,FDE 的需求正在快速上升——企业购买了大模型 API 或智能体平台之后,往往需要有人把这些能力嵌入到自己的 ERP、CRM 或内部知识库中,而这正是 FDE 的核心价值所在。对于有真实 AI 项目落地经验的开发者来说,这一方向具有较高的溢价空间。
结语:真实项目才是硬通货
这个案例最大的启发,不在于某个具体框架,而在于它展示了一个完整智能体从Demo走向生产的路径:多版本迭代、多组件协同、图谱增强检索、角色化风格模拟,以及与业务平台的深度打通。
对于想在AI开发赛道求职或进阶的人来说,与其追逐每一个新框架,不如沉下心把一个真实项目做深、做透,讲清楚每一处技术选型背后的"为什么"。这才是应对当下面试与职业发展的真正底气。
相关推荐
HuggingFace开始内容审查?下架模型引发社区争议
HuggingFace下架一个标注「用于网络攻击」的去审查GLM模型,引发开源社区关于内容审查的争议。本文梳理事件始末,分析abliterated模型的敏感性,以及平台治理透明度这一真正痛点。
Cayu:构建长周期领域智能体的开源Python框架
Cayu 是一个用于构建领域专用、长周期 AI 智能体的开源 Python 框架。它让开发者围绕工具、知识与业务规则组装 harness,并提供集成的持久化运行时处理会话、状态、恢复、审批与可观测性。本文解析其核心思路与落地场景。
社交媒体真的在伤害青少年吗?一场悬而未决的科学争论
社会心理学家乔纳森·海特在《焦虑的一代》中将青少年心理健康下滑归咎于社交媒体,但这一论断在学术界引发分歧。本文探讨相关性与因果关系的争议,以及这场辩论对公共政策的现实意义。