Cursor、Claude、ChatGPT底层如何运转?AI技术栈全解析
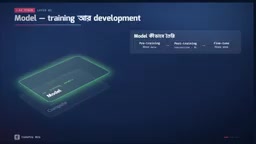
AI产品是从输入框延伸到GPU的五层技术栈,问题定位需逐层排查。
文章把日常使用的Cursor、Claude、ChatGPT背后的系统拆解为五层:应用层、Agent循环层、模型层、推理优化层和GPU基础设施层。Agent在规划-执行-观察的循环中运行,LangGraph等框架用图状状态机组织步骤,MCP协议则把API标准化为工具以降低集成成本。模型层经历预训练、指令微调和强化学习三步,token逐次生成与显存、KV Cache、量化构成推理侧的核心约束。推理优化层通过RAG检索、模型路由和流式输出平衡准确性、成本与感知延迟。最终一切落到GPU算力与网络上。分层视角的价值在于:答错先查检索,Agent卡住先查循环与权限,变慢先看流式与路由,成本高则用量化与大小模型分流。
从产品界面到GPU:AI其实是一个多层技术栈
日常使用Cursor写代码、在Claude里讨论问题、跟ChatGPT聊天时,我们面对的只是一个清爽的输入框。但这个输入框背后,藏着一整套从应用层一直延伸到GPU裸金属的分层系统。据YouTube技术频道(孟加拉语讲解)的分析,整个AI技术栈可以自上而下拆解为应用层、Agent循环层、模型层、推理优化层和基础设施层。每一层解决的问题不同,也各自对应着不同的工程取舍。
理解这套栈的价值在于:当模型答错、工具调不到、响应变慢时,你能判断问题出在哪一层——是检索没召回对的文档,是Agent陷入了错误循环,还是推理侧的算力和内存带宽撞到了天花板。
Agent循环:一个会自己动手的软件实体
规划、执行、观察的闭环
Agent并不是「模型回答一次就结束」的问答接口。据该频道描述,Agent运行在一个循环里:先做规划(plan),然后调用工具、编辑文件、跑测试,观察结果后再调整下一步。这一循环让它能够连续完成多步操作,而不需要人每一步都介入。
实现这类循环的常见框架包括LangGraph等,它把Agent的各个步骤组织成图状的状态机结构,使流程可控、可调试。该频道还提到,循环中存在专门的权限/许可层——在Agent执行写文件、跑命令这类动作前,需要先拿到授权,避免误操作。
为什么工具调用需要标准化协议
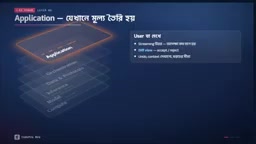
如果每个模型、每个工具都各自定义接口,集成成本会高得离谱。MCP(Model Context Protocol,模型上下文协议)的作用就在于此:它提供一个标准方式,把一个API包成工具,再把工具包成MCP Server,模型即可按统一的协议调用。这样一来,换模型或换工具时不必重写整个链路。
MCP采用客户端-服务器架构:模型所在的宿主应用作为MCP Client,通过标准化的JSON-RPC消息与一个或多个MCP Server通信。每个MCP Server暴露三类能力——工具(可执行函数)、资源(可读取的数据)和提示模板(预设指令),客户端在会话初始化时自动发现这些能力及其参数schema,再把它们注入模型的上下文。这样模型无需预先硬编码任何工具细节,只要按schema发起调用即可。由于协议层与模型解耦,同一个MCP Server可以被不同厂商的模型复用,而更换模型也不必改动工具实现,这正是标准化带来的可组合性。
模型层:预训练、指令微调与强化学习
从原始文本到可用助手
大模型的训练大致分三步走。第一步是预训练:用海量文本让模型学会预测下一个token,这一步产出了模型的「知识底座」。第二步是指令微调(instruction tuning),让模型学会按人类指令的形式作答。第三步则是强化学习(RL),用反馈信号把模型的行为校准到更符合期望的方向。
据该频道讲解,在实际产品中,用户输入并不会直接用来做指令微调的训练数据,行为校准主要依靠强化学习完成。这里的关键工程约束是:预训练极其昂贵,而微调和后续推理才是产品迭代中反复发生的部分。
token、显存与量化的经济学
模型输出是按token逐个生成的,每个token都要走一遍前向计算,因此响应时间与生成长度直接相关。更大的瓶颈在内存:数十亿参数的模型,权重本身就要占用大量显存,运行时的KV Cache还会进一步推高占用。量化(quantization)通过降低数值精度来压缩权重和显存占用,是让大模型跑在有限硬件上的关键手段。该频道提到,量化会带来一定的能力损失,需要在实际效果和资源消耗之间做测量和权衡。
KV Cache是自回归生成中的关键内存开销:每生成一个新token,模型都要对先前所有token的Key和Value向量做注意力计算,为避免重复计算,推理引擎会把它们缓存下来。缓存大小与序列长度、层数、注意力头数和批大小成正比,长上下文场景下可能超过模型权重本身。因此实际部署中常用分页管理(如vLLM的PagedAttention)、分组查询注意力(GQA)等技术压缩KV Cache。这也解释了为什么长对话、大并发会显著推高显存占用和延迟——瓶颈往往不在算力,而在显存容量与内存带宽。
推理优化:RAG、路由与流式输出
检索与模型路由
一条请求进入模型之前,往往先经过两层优化。其一是检索增强(RAG):把文档转换成向量(embedding),在向量数据库中建立索引,问题到来时召回最相关的片段。该频道特别强调,如果检索到的文件本身不相关或属于「垃圾进」,模型的回答就会出错——检索质量直接决定回答质量。
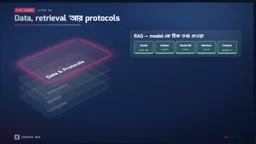
其二是模型路由(model routing):根据请求难度,把简单任务交给小模型(更快、更便宜),复杂任务交给大模型;当大模型侧不可用或出错时,再回退到备用提供方。这套分流机制直接决定了产品的成本结构和可用性。
Embedding是把文本映射为高维稠密向量的过程,语义相近的文本在向量空间中距离更近。RAG通常采用双塔结构:文档侧离线切块(chunking)后编码入库,查询侧在线编码,再用余弦相似度或近似最近邻(ANN)算法(如HNSW、IVF)快速召回Top-K片段。切块粒度、是否重叠、是否需要重排序(rerank)都会影响最终召回质量。纯向量检索对关键词精确匹配不敏感,实践中常与BM25等稀疏检索做混合召回,再交由交叉编码器重排,以兼顾语义与字面匹配。
流式输出让等待感消失
流式(streaming)输出是体验层的关键优化:模型边生成边推送token,用户不必等整段回答完成才看到内容,感知延迟大幅降低。对开发者工具而言,界面上还会实时展示差异对比(diff),让用户看清改了什么、并决定接受还是拒绝某次修改。
流式输出依赖底层协议支持增量传输:服务端通常通过Server-Sent Events(SSE)或HTTP chunked encoding逐块推送token,前端在收到每个增量后立即渲染。为降低首token延迟,推理引擎会做prefill与decode的分离调度,并配合连续批处理(continuous batching)在多个请求间交错推进。流式也带来工程复杂度:错误可能发生在流的中途,需要设计可恢复的断流处理;同时逐token渲染会频繁触发前端重绘,需做节流与增量DOM更新。
基础设施:GPU、算力与延迟
整个栈最终落到硬件上。推理负载主要依赖GPU,而GPU供给紧张、成本高昂,是行业里公开的瓶颈。大型科技公司在这一层有自己的数据中心和算力储备,中小团队则更多依赖云服务。该频道还提到网络与延迟的重要性——低延迟的互联直接影响推理服务的响应速度。
分层视角带来的实践启示
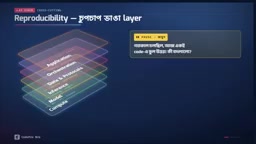
把AI产品看成技术栈而非单一模型,会改变很多工程决策。模型答错时先查检索,Agent卡住时先查循环与权限,响应慢时先看流式与路由,成本高时量化与大小模型分流是首选手段。每一层的取舍都会沿着栈向上传导,最终体现在用户看到的那个输入框里。
(本文基于YouTube孟加拉语技术频道的讲解整理,部分细节为该频道的单一来源表述。)
相关推荐
核战真能终结文明吗?科学解析常见误区
核战争会终结文明吗?本文基于核武器物理机制,解析爆炸、辐射尘与城市火灾的真实影响,区分空爆与地爆、剂量与污染,说明为何核战是巨大灾难却非文明终结,并探讨打击后社会重建的关键因素。

泰坦尼克号沉没真相:国家地理纪录片中的关键决策与通讯失灵
国家地理纪录片《The Unsinkable Ship》通过幸存者口述还原泰坦尼克号沉没前的关键决策:从MSG电报前缀缺失、锅炉房与舰桥通讯断裂,到“永不沉没”认知偏差如何延误损管与疏散。

74M参数开源模型在测试中部分超越Jev AI
Fastino AI 的 Glider 2.5 系列模型仅 7400 万到 3 亿参数,据 YouTube 实测在部分防护栏基准测试中超越 Jev AI,且可在消费级硬件运行,甚至用于玩《Doom》。本文分析小模型在特定任务上的竞争力与部署价值。