Cursor内部爆火插件Stack开源:一周调用9000次,用工程纪律驯服AI编程

Cursor内部插件Stack用23条剧本和24条原则把工程判断力变成可分发执行的Markdown。
Stack是Cursor团队内部爆火的工程纪律插件,作者Potato将资深工程师的日常工作方式打包成23条任务剧本和24条工程原则,用Potato Mode统一入口,强制Agent在汇报完成前交出可验证的证据。插件采用多模型分工与对抗审查减少盲区,并持反共识立场:不做计划、不轻易打断Agent,主张用运行结果建立信任后再实现无畏并行。开源后社区迅速移植到Claude Code、Codex等平台,证明工程判断力可以被压缩成Markdown并分发执行。
AI编程工具正在陷入一场集体焦虑:代码产量飙升,但合并代码的勇气却在下降。模型一口气生成800行代码,跑起来却暗坑无数,review时间快赶上自己重写。Cursor团队内部一个叫Stack的插件,试图用一套工程纪律解决这个问题——作者晒出的内部排行榜显示,他的技能一周被同事调用约9000次。开源后,社区迅速将其移植到Claude Code、Codex、GitHub Copilot等平台,其中一个移植仓库几个月冲到2700多star、200多fork。这个插件到底做对了什么?
Stack是什么:把资深工程师的日常操作写成Markdown
Stack不是新模型,也不是收费SaaS。它是一堆Markdown文件加上几个脚本,MIT协议开源。作者网名Potato(本名Laurentan),简历上写着Meta和Netflix,经手过几百万行级别代码库,后来加入Cursor做Member of Technical Staff,同时是React核心团队成员,参与维护React Compiler。他把自己每天在Cursor写代码用的整套工作方式打包成了插件,原话很直白:“这些就是我现在每天在用的技能。”
插件内容分为四类二十多个工作流技能:23条任务Playbook(剧本),覆盖从修Bug到通宵自动跑任务的各种场景;24条工程原则,一条一个文件;以及两个专门的子代理。整个插件的思路浓缩成README第一段的一句话:"If you want to go fast, go deep first"——想快,先往深了做。
核心机制:Potato Mode与证据偏执
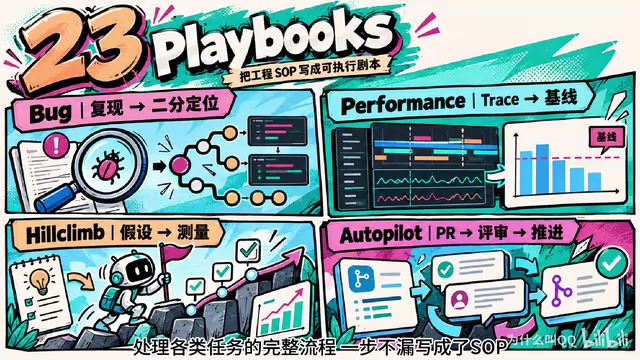
用起来很简单,二十多个技能不用记,只需要记住一个命令:斜杠Potato Gun Mode,把想做的事用大白话写在后面。接到任务后,插件会自动匹配对应的Playbook,把剧本里的步骤逐字复制进任务列表,然后按步骤调用其他技能,把活分派给子代理。干完活必须交出证据,才允许汇报完成。
23个剧本覆盖了丰富场景:修Bug的剧本要求先复现,复现不了就人为制造条件逼它出现,然后二分定位找到根因;性能问题剧本要求先跑CPU Trace,对着基线数据说话;还有一个叫"Hue Claimed"的剧本盯着一个指标持续优化,每轮先提假设,测前后对比,有收益才提交。最狠的是Autopilot剧本,一条线把一串PR挨个验证推进,每一轮都有一个评审团给结论。
多模型分工是另一个前卫设计。它不绑定单一模型:默认配置里,写代码、功能开发、重构、修Bug派给Grok;需要判断力的决策、写文档交给Opus;代码审查用一个叫Interrogate的技能,让不同家族的模型同时审同一个Diff,互相挑刺。逻辑很直接——不同模型有不同盲区,让它们对抗,漏网之鱼会少很多。
子代理(Subagent)与多模型对抗的工程背景
子代理指的是在一个主任务流程中,由主Agent动态派生出专门负责子任务的独立Agent实例,每个实例可以绑定不同的模型、上下文和工具权限。Stack把“写代码”和“做决策”分派给不同模型,本质上是利用了当前大模型能力分布的不均衡:有些模型在代码生成上吞吐高、成本低,有些模型在长上下文推理和判断上更稳。而“对抗审查”借鉴的是软件工程里的红蓝对抗和多人评审思想——让不同训练数据、不同对齐策略的模型同时审同一个Diff,能显著降低单一模型因训练偏差而产生的系统性漏检。这种做法在学术界被称为“多智能体辩论”(Multi-Agent Debate),Stack把它工程化成了可重复执行的Playbook步骤。
工程原则:把“只可意会”的判断力变成文本资产
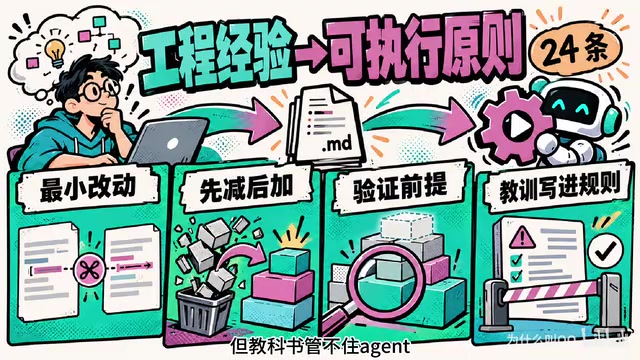
24条工程原则是这套插件的灵魂。比如“懒惰协议”:倾向于删除,用最小改动解决问题,先减后加,动手前先把冗余校验器和死代码清掉。“攻击前提”:两个共享同一前提的修复都失败了,就把前提写下来直接测前提。“把教训编码进结构”:能写成Lint规则的就别再写口头叮嘱。
这些原则单看每一条都是老生常谈,教科书里都有,但教科书管不住agent。把这些品位写成agent每次开工前必须重读的条文,效果完全不同。这大概是Stack最值钱的地方:它把只可意会的工程判断力,变成了可以分发和执行的文本资产。
还有一条原则叫“Prove It Works”:别拿编译通过当交付,去把功能真的跑起来,把真实的值读出来,把Diff摊开看,汇报完成前必须拿出能验证的证据。另一条“Explain the Number”专门治数字幻觉:Agent跑出性能提升30%,先别信,要搞清楚瓶颈到底在哪,会不会测的根本不是你想测的逻辑。
Lint规则与“把教训编码进结构”
Lint规则是静态代码分析工具(如ESLint、Clippy)中可配置的检查项,能在不运行代码的情况下发现风格违规、潜在Bug和危险模式。把口头叮嘱转成Lint规则的价值在于:agent每次生成代码都会经过同一套确定性检查,不依赖它“记住”某条原则。Stack的“懒惰协议”和“攻击前提”属于判断层面的原则,难以完全Lint化,但作者仍强调能结构化的就别留在文本里——因为文本原则依赖模型每次重读和执行,而Lint是强制门禁。这其实对应了传统工程里“约定优于配置”和“自动化守门”的取舍:原则负责方向,Lint负责底线。
反共识立场:不做计划,不轻易打断
Stack里藏着几个反共识的立场。整个插件没有任何一个做计划的技能,作者解释很直接:他不相信先规划再动手,最好的规格说明就是代码本身。你可以做计划,Potato Mode里有对应剧本,但它永远不会是默认动作。另一个立场是Agent不该动不动停下来问人,原则写得很清楚:继续干,干完把结果摆出来让人事后纠偏,只有不可逆操作才需要确认。
这两条放一起,能读出作者的完整主张:把判断权留给运行结果,把打断次数压到最低。这背后是一个完整的信任模型——多数人用agent要么全信要么全盯,全信被坑,全盯白用。Stack给出第三条路:先让agent在严格纪律下干活,每次都交证据,证据攒够了信任就有了依据,信任有了依据才敢同时开第二个、第三个agent。作者把这叫"Fearless Parallelism"(无畏并行)。顺序很重要:并行是结果,信任是前提,纪律是地基。
“无畏并行”与Agent信任模型
在传统多线程编程中,并行意味着共享状态和竞态风险;在AI编程里,同时开多个Agent的風險是它们互相覆盖修改、产生冲突的Diff,或者各自基于过时上下文做决策。Stack的“无畏并行”不是鼓励盲目多开,而是把纪律和证据作为并行的前置条件:每个Agent在独立分支上按Playbook干活,汇报时附带可验证的证据(测试通过、Trace数据、Diff对比),主控者只需审证据而非盯过程。这实际上是把软件工程里的持续集成/持续交付(CI/CD)思路搬到了Agent协作上——用自动化验证替代人工逐行盯守,从而让并行规模可以安全扩展。
社区移植与普通人的用法
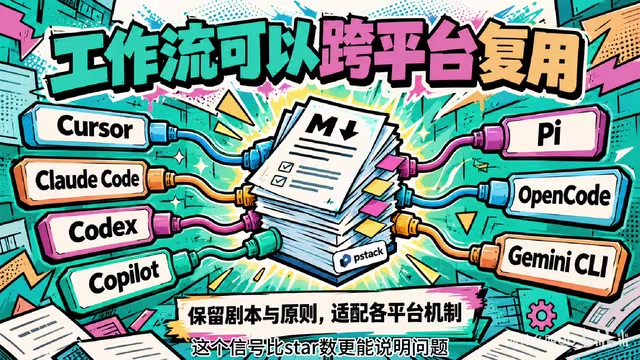
Stack本来是Cursor专属,依赖其内部子代理和插件机制。开源后社区反应迅速:有人做了Claude Code移植版,顺带支持Codex、GitHub Copilot、OpenCode和Gemini CLI。移植者很克制,明确说Cursor用户直接用原版,他把Cursor特有部分逐一翻译成对应平台的等价物,保留全部剧本和原则。一个插件能让其他平台用户主动搭桥,这个信号比star数更能说明问题。两个仓库都是MIT,随便Fork。
如果你不用Cursor,这套东西依然有意义。安装门槛很低,各平台现在都有入口。就算一个技能都不用,光是读一遍24条原则和23个剧本,就等于白嫖了一份资深工程师的方法论清单,哪条戳中你拿走就行。最值得抄作业的一点是它自带一个"Ultimate Me"技能:翻你最近和Agent的聊天记录,分析你实际的工作习惯,生成一个以你名字命名的专属Mode。Potato把自己的品位做成了插件,同时把做插件的方法也给了你——你的工作经验同样可以沉淀成资产。
Stack火的真正原因只有一件事:它证明了工程判断力可以被压缩成Markdown,被分发,被执行。AI编程的竞争正在从比谁的模型强,转向比谁的工作流更扎实。
相关推荐

大厂AI工程化面试:前端监控到Agent全链路可观测性
从PerformanceObserver采集性能指标、onerror与unhandledrejection捕获异常,到RAG链路重排优化、上下文压缩控制token成本,再到对标LangSmith与Sentry的全站AI全链路可观测性体系设计,拆解大厂AI工程化面试的三层递进考点。

WorkBuddy保姆级教程:手把手搭建专属AI Agent工作助理
WorkBuddy保姆级教程:从豆包等聊天模型的局限讲起,手把手教你搭建专属AI Agent工作助理,实现本地文件批量处理与自动化操作,非程序员也能轻松上手。

Windows下用LangChain-Chatchat+DeepSeek搭建本地知识库
本文整理B站教程,详解Windows下用LangChain-Chatchat与DeepSeek搭建本地知识库的全流程,包括Anaconda环境配置、Ollama模型管理、镜像源加速及常见报错解决,助你快速实现RAG问答。