大模型如何选择书写系统?研究揭示末层决策机制

LLM脚本选择遵循"早编码、晚承诺"两阶段机制,中间层存在拉丁默认偏置,模型深度决定多语言输出质量。
这篇论文研究了大语言模型(LLM)在生成多语言输出时如何选择书写系统(script)。研究者使用逻辑回归探针与logit-lens两种可解释性方法对Transformer各层进行逐层分析,发现了清晰的两阶段机制:输入与指令要求的书写系统信息在最早期层即已被编码,而对输出脚本的实际"承诺"却直到网络最末几层才发生;在漫长的中间层里,模型表征始终默认倾向拉丁字母。研究还发现较小模型在脚本跟随任务上表现更弱,说明脚本承诺能力与模型深度密切相关。这一发现对多语言模型架构设计有直接启示:过度压缩模型深度可能不成比例地损害非拉丁语言的输出质量,真正包容的多语言能力需要足够的网络深度来完成末层的脚本切换。
一个被忽视的多语言难题:脚本选择
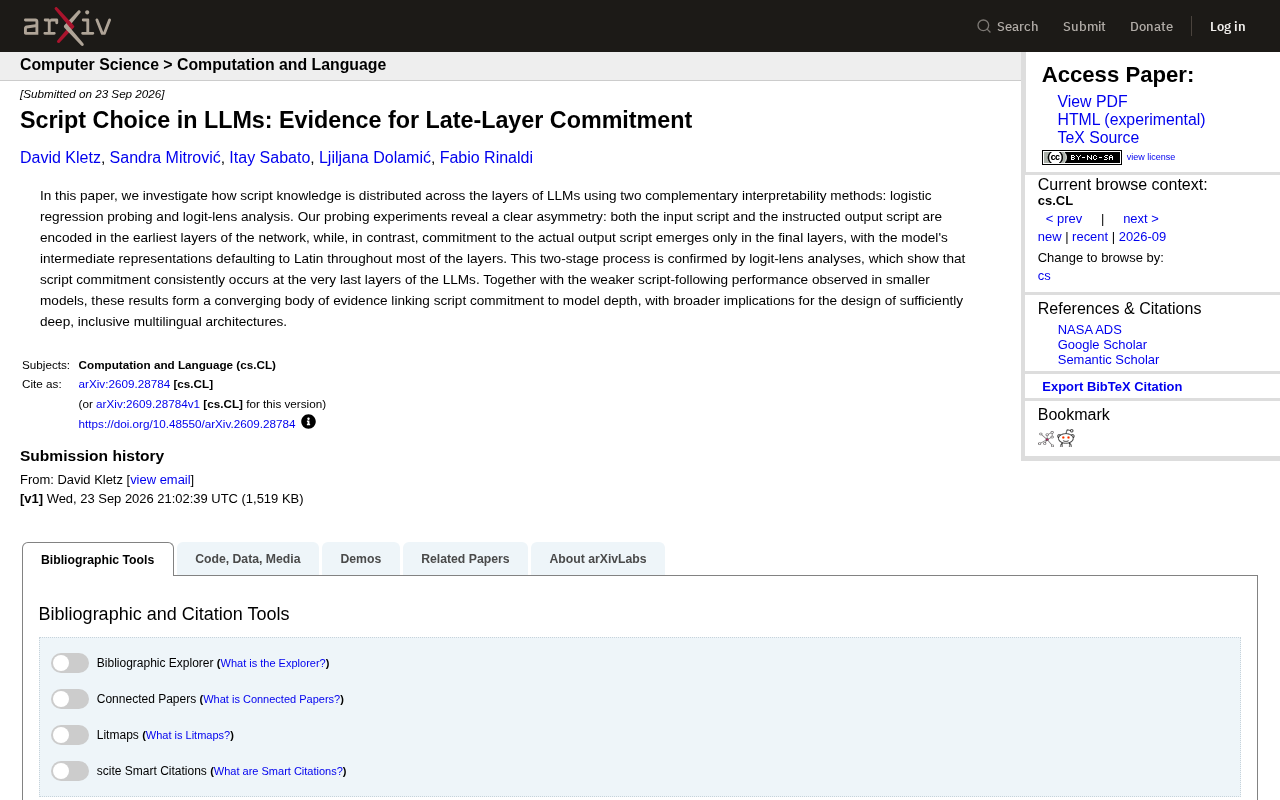
当我们要求大语言模型(LLM)用阿拉伯语、印地语或中文回答问题时,模型不仅要选对语言,还要选对书写系统(script)。同一种语言可能对应不同脚本,而错误的脚本选择会直接导致输出无法阅读。这篇发表于 arXiv 的论文(arXiv:2609.28784)聚焦一个此前研究较少的问题:书写系统的知识究竟分布在模型的哪些层?模型又是在哪个阶段真正"下定决心"使用某种脚本?
研究者采用了两种互补的可解释性方法——**逻辑回归探针(logistic regression probing)**与 logit-lens 分析——对模型内部表征展开逐层剖析。这类方法能够透视 Transformer 各层的中间表征,判断特定信息在何处被编码、何时被最终使用。
逻辑回归探针(logistic regression probing) 是可解释性研究中的经典技术:在 Transformer 的某一中间层提取隐藏状态向量,训练一个轻量级线性分类器,检验该向量是否线性可分地携带某类信息(如"当前目标脚本是阿拉伯文还是拉丁文")。若探针准确率显著高于随机基线,即可认为该层已编码了这一信息。logit-lens 则是另一路径:将各层的隐藏状态直接投影到词汇表的 logit 空间,观察"如果在此层强制解码,模型会输出什么",从而追踪预测结果在层间的演变轨迹。两者的关键区别在于:探针回答"信息是否存在于该层的表征中",而 logit-lens 回答"该层的表征是否已足够驱动正确的最终输出决策"——前者揭示编码,后者揭示承诺。
核心发现:编码在前,承诺在后
论文揭示了一个清晰的非对称结构。探针实验显示,无论是输入文本的脚本,还是指令要求的输出脚本,都在网络的最早期层就已被编码。也就是说,模型很早就"知道"了应该用什么书写系统。
然而,真正对输出脚本做出承诺(commitment)却发生在最后几层。在中间的大部分层里,模型的表征默认倾向于拉丁字母(Latin)。这意味着模型内部存在一种"拉丁默认"的惯性,直到临近输出时才切换到目标脚本。
这种"两阶段过程"得到了 logit-lens 分析的印证:脚本承诺始终发生在 LLM 的最末端层。两种独立方法指向同一结论,构成了较强的交叉验证。
所谓拉丁默认(Latin default) 现象,是指 LLM 的预训练语料中英语及其他拉丁字母语言占据压倒性比例,导致模型在中间层的表征空间天然向拉丁字母倾斜。这一偏置并非模型主动"选择"拉丁脚本,而更像一种统计惯性——在尚未到达最终决策层时,最高概率的候选词元往往来自拉丁字符集。类似的现象也被其他研究发现:多语言模型在推理链(chain-of-thought)中往往默认以英语进行内部"思考",即使最终输出是目标语言。本文的贡献在于将这一直觉具体化,精确定位到了 Transformer 的哪些层发生拉丁偏置、哪些层完成脚本切换。
模型深度为何关键
研究还观察到,较小的模型在脚本跟随(script-following)任务上表现更弱。将这一现象与逐层分析结合,作者得出一个收敛性的判断:脚本承诺与模型深度密切相关。
逻辑上不难理解——如果脚本决策依赖于末层的表征转换,那么层数不足的浅模型就缺少完成这一转换的"空间",从而更容易在脚本选择上出错,尤其是对非拉丁书写系统的语言。这也解释了为何小模型在多语言场景下常常"退化"为拉丁转写或直接输出错误脚本。
对多语言架构设计的启示
这项研究最具实践价值的推论在于:要构建真正包容的多语言模型,网络必须足够深。如果脚本承诺天然发生在末层,而中间层普遍存在拉丁偏置,那么为低资源、非拉丁语言提供良好支持的前提,就是保证足够的模型深度来完成末端的脚本切换。
对于追求轻量化、边缘部署的模型压缩方向而言,这是一个需要权衡的信号:过度削减深度可能会牺牲非拉丁语言的输出质量。
这一发现对模型剪枝(pruning)与知识蒸馏(knowledge distillation) 的实践具有具体警示意义。当前常见的压缩策略往往均匀削减层数,或优先保留靠近输入/输出的层。但若脚本承诺高度集中在末尾少数几层,均匀裁剪反而会不成比例地损伤非拉丁语言的输出能力,而对英语等拉丁语言影响甚微——因为后者在中间层已被隐式支持。这意味着面向多语言场景的压缩方案,应在末层附近保留更多容量,或通过语言特定的评测指标(而非仅看英语 benchmark)来衡量压缩代价。
方法论价值
从可解释性研究的角度看,这篇论文示范了如何用两种正交方法定位一种"能力"在模型中的物理位置。探针方法回答"信息是否存在",logit-lens 回答"信息何时被使用",二者结合能够区分编码与承诺这两个容易被混淆的概念。
这一区分本身颇具启发性:模型在早期层"知道"答案,不代表它已经"决定"输出答案。类似的"知道—承诺"分离,或许在其他多语言、多模态能力中也普遍存在,值得后续研究进一步探索。
小结
这篇论文用严谨的可解释性实验,勾勒出 LLM 处理书写系统的内部机制:脚本信息早早编码,拉丁默认贯穿中层,最终承诺留给末层完成,而这一切都受模型深度制约。对于关注多语言公平性与包容性的研究者与工程师来说,它提供了一个明确的设计方向——深度不足,多语言难以真正落地。
相关推荐

MCP工具投毒:被忽视的AI智能体攻击面与防御之道
MCP工具投毒正成为智能体AI的新攻击面。本文解析工具描述为何可被恶意利用,剖析信息鸿沟与数据外泄链条,并给出白名单注册表、哈希固定、最小权限与链路策略等分层防御方案。
MCP联合创造者:智能体需要的是连接性,而非更强模型
MCP联合创造者David Soria Parra在演讲中指出,决定智能体未来的是连接性与开放标准,而非更强的模型。本文梳理模型能力演进、编程Agent落地逻辑、MCP的无状态改造及Tasks、Skills、身份授权等未来路线图。
SageMaker新技能上线:为编码智能体赋能生成式AI推理优化
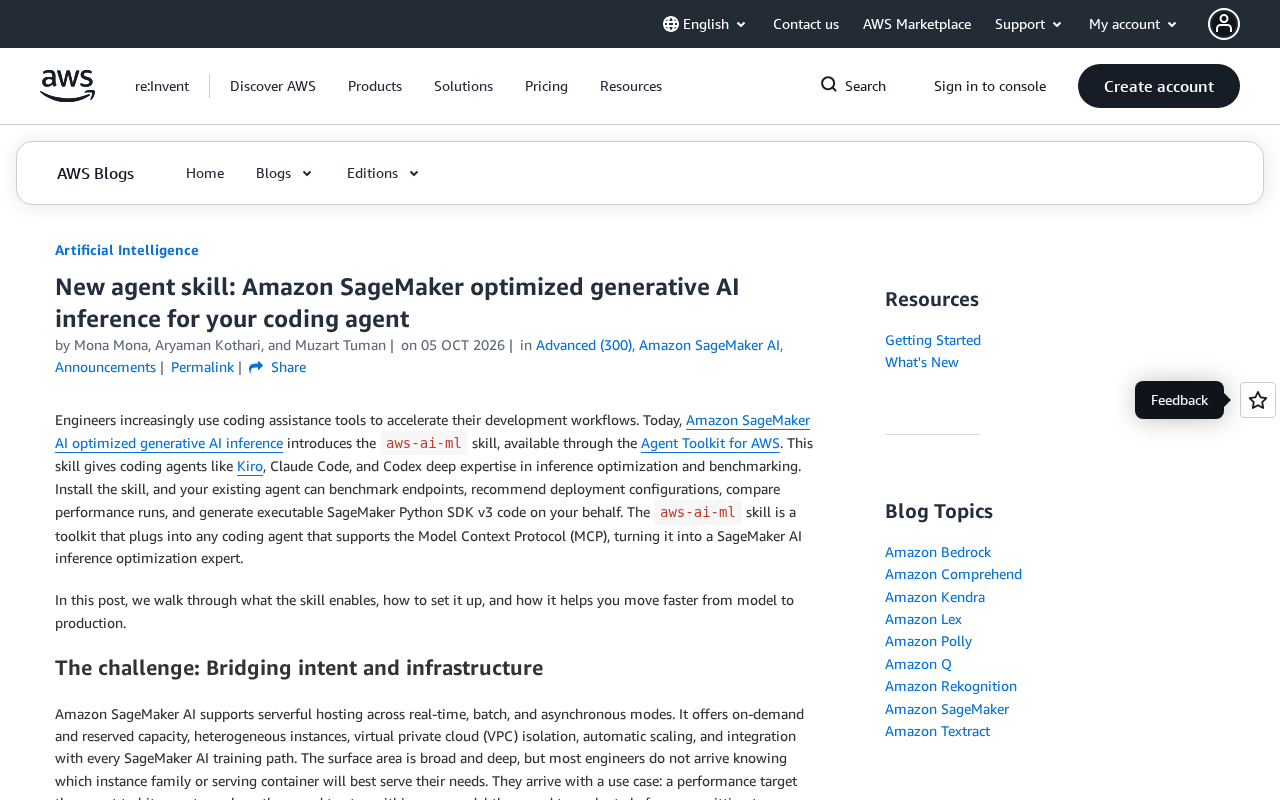
Amazon SageMaker 推出 aws-ai-ml 新技能,通过 Agent Toolkit for AWS 为 Kiro、Claude Code、Codex 等编码智能体注入生成式AI推理优化专长,支持自然语言生成可执行的 SageMaker Python SDK v3 代码完成基准测试、推荐与对比。