大模型「中间迷失」:长提示词为何漏掉关键信息及应对方法

LLM处理长上下文时准确率呈U形曲线,中间内容被系统性忽视,应将高信号内容刻意置于首尾。
「中间迷失」是一个经实验反复验证的现象:当关键信息落在长提示词的中间位置时,模型准确率显著下降,甚至低于完全不提供任何文档的闭卷成绩。根本原因在于Transformer的注意力机制天然对输入序列的开头和结尾赋予更多权重,与内容本身的相关性无关。扩大上下文窗口或增加检索文档数量均无法解决这一问题。实用对策包括:将规则与约束置于提示词顶部,在末尾重述任务,在RAG流水线中用reranker精排后将最相关文本块交错放置于两端,并通过移动关键事实位置做实测验证。这些低成本的布局调整,往往比盲目扩大上下文带来更实质的性能提升。
把一份 40 页的政策文档粘进提示词,问一个问题,模型却自信地回答得像第 19 页根本不存在。你需要的那个事实明明就在那里——只不过恰好落在了中间。
这不是运气不好,而是一个被反复测量验证的现象,叫做**「中间迷失」(Lost in the Middle)**。今天最值得记住的一条经验很简单:把信号最强的内容放在长提示词的开头和结尾,绝不要只塞在中间。
研究到底发现了什么
在论文 Lost in the Middle: How Language Models Use Long Contexts(Liu 等,TACL 2024)中,来自斯坦福、UC Berkeley 和 Samaya AI 的研究者做了一个干净利落的实验。他们给模型一个问题外加 10、20 或 30 段检索到的维基百科文段,其中恰好只有一段包含答案。然后他们把这段含答案的文段挪动位置:开头、中间某处、结尾,其他一切保持不变。
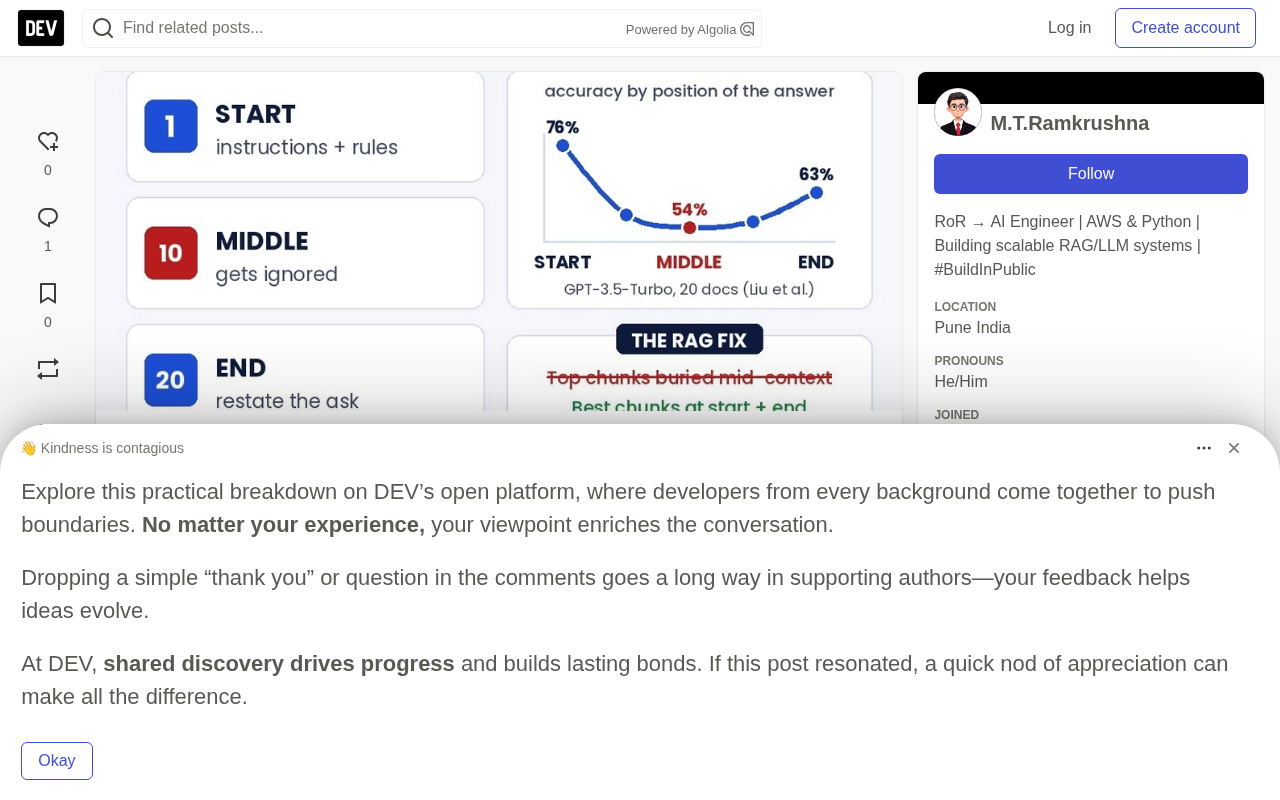
如果模型能均匀利用上下文,无论答案在哪儿准确率都应该是平的。但结果并不平,而是呈现一条明显的 U 形曲线:
- 上下文开头:准确率最高,论文称之为首因偏差(primacy bias)。
- 上下文结尾:次高,即近因偏差(recency bias)。
- 中间:出现明显的凹陷。
具体数字更让人印象深刻。在 20 篇文档的设定下,当正确文段排在最前面时,GPT-3.5-Turbo 答对率约 75.8%;排在最后时约 63.2%;而落在中间时只有 53.8%。而它的「闭卷」成绩——完全不给任何文档——是 56.1%。换句话说,在最差位置上,给模型答案的效果竟然略逊于什么都不给。
对开发者而言,还有两个发现同样关键:
- 更大的上下文窗口并不能解决问题。 扩展上下文版本(16K、100K)在输入能同时放进两种窗口时,表现几乎和短窗口版本一模一样。窗口更大只意味着你能发送更多,不代表模型用得好。
- 检索更多文档很快触顶。 在开放域问答案例中,把检索文档从 20 篇增加到 50 篇,GPT-3.5-Turbo 只提升了约 1.5%(Claude-1.3 约 1%),却付出了大量额外的 token 和延迟成本。
为什么会发生
后续论文 Found in the Middle(Hsieh 等,ACL Findings 2024)把这个效应直接归因于模型的注意力机制:输入开头和结尾的 token 会获得更多注意力,无关其实际相关性如何。他们提出的校准方法削弱了这种偏差,相比已有方法把 RAG 结果提升了最多 10 个百分点。
可以把它想象成一场漫长的会议。人们记得会议是怎么开场的、怎么收尾的。而有人在第 34 分钟提出的重要观点,往往是没人记下来的那一个。
较新的模型在简单的「大海捞针」测试上已经比论文中那些 2023 年的模型表现好得多。但在真实的多文档任务里,位置效应并未消失。所以应把「放置」当成一个需要主动设计的变量,而不是靠运气碰出来的结果。
注意力机制(Attention Mechanism)是 Transformer 架构的核心组件,它让模型在生成每个输出 token 时,能够对输入序列中不同位置的 token 赋予不同的权重。理论上,注意力头可以自由地「关注」序列中任意位置——无论是第 1 个 token 还是第 10000 个。但实践中,预训练数据的分布会塑造模型习得的注意力模式:大多数训练文本(书籍、网页、代码)的关键信息都集中在段落开头和结尾,这使得模型在推理时天然倾向于更多地「关注」这两个位置。此外,位置编码(Positional Encoding)的设计方式也可能强化这一偏差:相对位置编码在处理极长序列时对中间位置的区分度往往低于两端,导致中段 token 的身份信号更模糊。这一结构性偏差并非某个模型的 bug,而是整个 Transformer 系列在当前训练范式下共同呈现的系统性特征。
改造前后对比
下面是一个典型的长提示词,按数据到达的顺序堆叠而成:
You are a support assistant.

<documents>
  [doc 1: general company FAQ]
  [doc 2: shipping policy]
  [doc 3: refund policy  <- 答案在这里]
  [doc 4: warranty terms]
  [doc 5: holiday hours]
</documents>

Answer the customer's question. Only use the documents.
Keep it under 80 words. Cite the doc number.

Question: Can I get a refund after 45 days?
关键规则(「只使用文档」、字数限制)和那一篇真正重要的文档,全都被挤在了文档堆的中间。
同样的内容,有意识地重新放置:
You are a support assistant. Answer only from the documents below.
If the answer isn't in them, say so. Keep it under 80 words. Cite the doc number.

Task: answer a customer question about refunds.

<documents>
  [doc 3: refund policy]      <- 最相关的放最前
  [doc 4: warranty terms]
  [doc 1: general company FAQ]
  [doc 5: holiday hours]
  [doc 2: shipping policy]    <- 第二相关的放最后
</documents>

Question: Can I get a refund after 45 days?
Reminder: answer only from the documents, under 80 words, cite the doc number.
规则放在顶部,问题和对规则的一句话重述放在底部,而最强的内容块坐落在模型注意力最集中的两端。
这与 Anthropic 的长上下文建议 高度一致——他们建议把长文档放在查询之上,并指出把查询放在末尾在其测试中可将回答质量提升最多 30%,在复杂的多文档输入场景中尤为明显。
RAG 的陷阱:排序过≠放对位置
大多数 RAG 流水线会检索出 top-k 文本块,按得分排序后直接塞进去。这会把第 1 块放在顶部——没问题——但当你有 10 块以上时,往往同样重要的第 2 到第 4 块就落到了中间。
更好的做法:
- 先重排,再裁剪。 用一个 reranker,并保留更少的块。五个好块胜过二十个平庸的块。
- 把最好的块放在两端。 让 rank 1 排第一、rank 2 排最后、rank 3 排第二、rank 4 排倒数第二,让最弱的落进中间。LangChain 把这个思路做成了
LongContextReorder,自己写也就十来行代码。 - 不要给上下文「灌水」。 每多塞一个块,就会把别的内容往中间推。
def edge_order(chunks_by_score):
    """最好的块放头尾,最弱的放中间。"""
    front, back = [], []
    for i, chunk in enumerate(chunks_by_score):
        (front if i % 2 == 0 else back).append(chunk)
    return front + back[::-1]


RAG(Retrieval-Augmented Generation,检索增强生成)是一种将外部知识库与语言模型结合的架构范式:系统先从向量数据库或搜索引擎中检索与问题最相关的文本块(chunk),再将这些块拼入提示词,让模型基于检索结果生成答案。Reranker(重排序模型)是 RAG 流水线中的可选精排层,通常是一个经过微调的交叉编码器(cross-encoder),它对「查询–文档」对进行细粒度相关性打分,比向量检索的近似最近邻算法更精准,但计算成本也更高。先用向量检索快速召回 top-50,再用 reranker 精排取 top-5,是目前工程上常见的两阶段策略。`LongContextReorder` 是 LangChain 内置的文档排列工具,正是基于「中间迷失」论文的发现实现:它将 reranker 输出的有序列表按奇偶交错分配到提示词头尾,使得相关性最高的若干块天然落在模型注意力最集中的位置。
# [r1, r2, r3, r4, r5] -> [r1, r3, r5, r4, r2]
快速检查清单
- 指令和硬性约束放在顶部
- 问题或任务在末尾重述一遍
- 对于 RAG,把最相关的块放在开头或结尾附近,而不是仅按得分排序后堆进中间
- 重排并保留更少的块
- 在任务允许的前提下尽量缩短上下文
- 实测验证:把关键事实分别移到真实提示词的开头、中间、结尾,看模型的回答是否变化
最后这一条只需十分钟,但它告诉你的关于自己模型的信息,比任何基准测试都多。
写在最后
「中间迷失」提醒我们,模型的上下文窗口再大,也不等于它能平等地利用窗口里的每一个字。位置是一个可以主动设计的工程变量:把高信号内容放在首尾两端,重排并精简检索结果,再用一个简单的 A/B 实验去验证。这些成本极低的调整,往往比盲目扩大上下文或堆更多文档带来更实在的收益。
相关推荐

主流世界之外:被忽视地区的安全与隐私困境
人本安全研究长期集中于西方,导致安全方案在主流世界失效。研究者Collins Minando基于肯尼亚移动贷款应用、网吧认证困境及九国本地专家研究,揭示社会经济约束如何重塑隐私实践,并提出移动货币隐私重设计与PETs部署路径。

Claude被曝可在正常图片中隐藏秘密信息
Reddit帖子称Claude Fable 5.1能在正常图片中隐藏秘密信息,本文梳理事件背景、图片隐写技术原理及潜在安全风险,并给出从传闻走向验证的测试路径建议。

AI助手何时该主动建议?时机决定一切
AI助手何时该主动建议?Reddit讨论揭示:同样的建议在不同时机感受迥异。本文分析主动建议的双面性、用户期待的分界线及设计原则,探讨如何平衡自动化与用户控制。