代数完全交的统计检验:从流形假设到可计算算法

论文提出在代数完全交假设类下检验高维数据的流形假设,并将其转化为可解的优化问题。
该研究针对高维数据是否集中在一个低维流形附近这一流形假设,提出在限定假设类下的严格检验方案。假设类被限定为具有指定维数、有界次数和有界条件数的实代数完全交,从而可借助代数几何中成熟的结构与工具。作者设计显式学习过程,其输出为两种情形:在近似阈值受控放宽下认证不存在满足条件的完全交,或返回几何复杂度受控的候选回归流形。方法核心是利用正则多项式系统的定量几何估计,把对无穷多候选流形的几何检验压缩为有限维、结构明确的辅助优化问题。作者进一步开发了数据驱动算法求解该优化问题,并给出显式的样本复杂度与算术复杂度界。这项工作的意义在于把代数几何的定量结果引入统计检验框架,为具备足够代数结构的假设类提供了可行的检验路径。
当高维数据落在代数簇附近
高维数据分析中有一个被广泛使用的假设:真实数据虽然表面维数很高,但其内在结构往往集中在一个低维流形附近。这就是所谓的「流形假设」。但如何严格检验一个数据集是否真的支持这一假设,一直缺乏可行的计算方案。
近期一项理论研究针对这个空白提出了具体方案。论文《Testing Algebraic Complete Intersections》研究了这样一个问题:给定来自高维实空间概率分布的独立同分布样本,能否检验该分布是否集中在一个代数完全交附近?这里的目标流形被限定为具有指定维数、有界次数和有界条件数的实代数完全交。
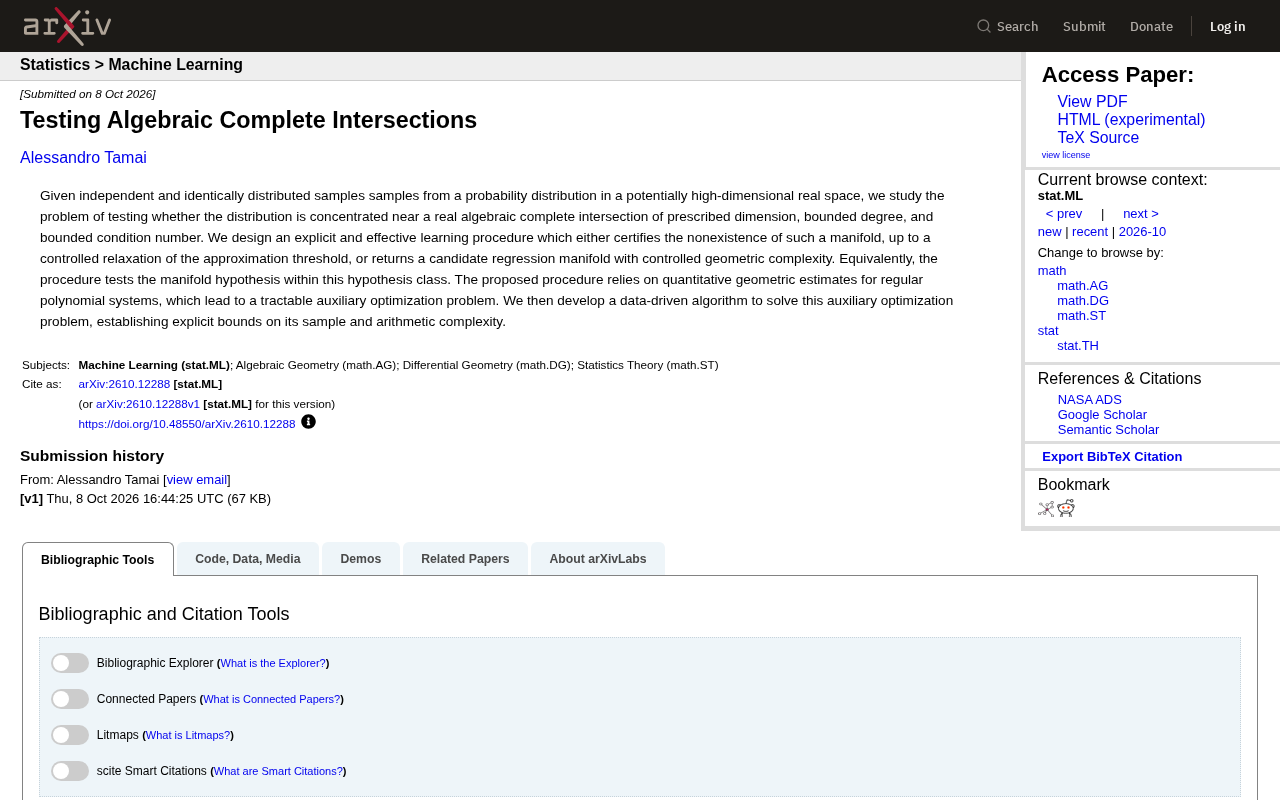
这个设定比一般的流形检验更具体,也更有代数几何的结构可以利用。代数完全交是多项式方程组零集的交集,在代数几何和计算代数中都有成熟的工具。把假设类限制在这个范围内,使得检验问题有可能转化为一个可处理的优化问题。
流形假设(manifold hypothesis)是机器学习与高维统计中的基础性先验:它认为尽管观测数据嵌入在 (\mathbb{R}^D) 这样的高维空间中,其有效自由度却由某个低维结构支配,因此数据点近似落在维数为 (d \ll D) 的流形上。这一假设是降维(PCA、自编码器)、半监督学习和表示学习的理论依据之一。但严格地说,流形假设多数时候只是一个建模约定,而非经过检验的结论。要检验它,需要把「数据落在某个流形附近」形式化为一个可证伪的统计命题——通常要指定流形族、距离度量与显著性阈值。一般光滑流形的族过于庞大,缺乏有限参数化,导致检验不可计算;这正是本文把流形族收紧到代数完全交的动机。
检验流程的核心思路
作者设计了一个显式的学习过程,其输出有两种可能:
- 认证不存在:在近似阈值受控放宽的前提下,证明不存在满足条件的代数完全交;
- 返回候选流形:给出一个几何复杂度受控的回归流形。
换句话说,该过程在给定的假设类内对流形假设进行检验——如果数据不支持这个假设,它会告诉你「没有」;如果支持,它会给出一个具体的候选。
有意思的是,这里「认证不存在」并非绝对否定,而是允许近似阈值有一定程度的放松。这种放松在统计检验中是必要的,因为有限样本无法支撑精确的几何断言。
条件数(condition number)在代数几何语境下衡量的是多项式系统解集在扰动下的敏感性,可粗略理解为解流形偏离奇异点或变形的程度。条件数有界排除了解集出现剧烈弯曲、近乎自交或维度塌缩等病态情形,从而保证几何量的估计是稳定的。若不作此限制,即使维数与次数固定,代数完全交也可能在极小的尺度上出现难以数值区分的结构,使任何有限样本检验失去意义。论文要求条件数有界,本质上是为可计算性和统计稳定性设置一道门槛,代价是假设类随之收窄,可能无法覆盖一些真实的复杂数据分布。
几何估计如何转化为可解优化
该方法的关键技术支撑来自正则多项式系统的定量几何估计。这类估计给出了多项式系统解集的几何量(如维数、次数、条件数)与系数之间的显式关系。作者利用这些估计,把原始的几何检验问题转化为一个辅助优化问题。
这一转化的意义在于:原始的检验问题涉及对无穷多个可能的代数完全交进行搜索,直接处理不可行;而借助定量几何估计,问题被压缩成一个有限维、结构明确的优化问题。
用原文的话说,这些估计「导向了一个可处理的辅助优化问题」(lead to a tractable auxiliary optimization problem)。
代数完全交(algebraic complete intersection)指由 (\mathbb{R}[x_1,\dots,x_D]) 中 (D-d) 个多项式 (f_1,\dots,f_{D-d}) 的公共零点集,且这些多项式在稠密开集上梯度线性无关。此时该零点集的维数恰为 (d),其余维数等于多项式个数,这一「完全」条件排除了冗余方程,使维数可由方程个数直接读出。此外,若各多项式次数为 (d_i),则总次数由 Bezout 定理给出为 (\prod_i d_i)。相比一般的实代数簇,完全交的维数与次数都有显式公式,这正是它可以被参数化、被有限维优化所刻画的关键,也是作者选择它作为假设类的技术原因。
数据驱动算法与复杂度保证
仅有优化问题的形式化还不够,还需要真正能跑的算法。作者随后开发了一个数据驱动算法来求解这个辅助优化问题,并给出了两方面的显式复杂度界:
- 样本复杂度:需要多少样本才能保证检验的可靠性;
- 算术复杂度:算法运行需要多少次算术运算。
这两个界都是显式的,而不是仅存在性的。这意味着从理论到实践之间少了一层障碍——尽管实际部署仍需考虑常数因子和数值稳定性等问题。
样本复杂度刻画为了以高概率保证检验结论正确,最少需要多少独立同分布样本;算术复杂度则刻画算法在给定精度下需要多少次基本运算,二者共同界定了问题的可学习性。在这类几何检验中,样本复杂度通常随内在维数、次数上界和条件数上界呈多项式或指数增长,而算术复杂度还与多项式系统的求解代价相关。论文给出显式界意味着:这些依赖关系被写成了可用参数直接计算的公式,而非仅存在性定理,从而使读者能够判断在具体参数下问题是否实际可解。需要注意,显式界通常隐藏了较大的常数因子,实际实现还受数值稳定性和条件数估计误差影响。
这项工作意味着什么
从方法论上看,这项工作的贡献不在于提出某个新的统计检验量,而在于把代数几何中的定量结果引入统计检验框架。代数完全交作为假设类,比一般光滑流形有更强的结构,这使得「检验」这个通常难以形式化的问题变得可计算。
当然,实际数据是否真的落在代数完全交附近,是另一个问题。有界条件数的要求在许多真实场景中未必满足,放宽条件后理论保证是否仍然成立,原文并未展开讨论。这项研究更像是在理论层面打开了一条路径:当假设类具备足够代数结构时,流形假设的检验可以是可行的。
对于关注高维统计、计算代数或机器学习理论的读者,这篇论文提供了一个值得跟踪的方向——它把两个通常分离的领域(代数几何的定量估计与统计假设检验)连接成了一个统一的算法框架。
相关推荐

大厂AI工程化面试:前端监控到Agent全链路可观测性
从PerformanceObserver采集性能指标、onerror与unhandledrejection捕获异常,到RAG链路重排优化、上下文压缩控制token成本,再到对标LangSmith与Sentry的全站AI全链路可观测性体系设计,拆解大厂AI工程化面试的三层递进考点。

WorkBuddy保姆级教程:手把手搭建专属AI Agent工作助理
WorkBuddy保姆级教程:从豆包等聊天模型的局限讲起,手把手教你搭建专属AI Agent工作助理,实现本地文件批量处理与自动化操作,非程序员也能轻松上手。

Windows下用LangChain-Chatchat+DeepSeek搭建本地知识库
本文整理B站教程,详解Windows下用LangChain-Chatchat与DeepSeek搭建本地知识库的全流程,包括Anaconda环境配置、Ollama模型管理、镜像源加速及常见报错解决,助你快速实现RAG问答。