单张RTX 5090跑出16 FPS:LingBot-World 2.0实时世界模型优化实战
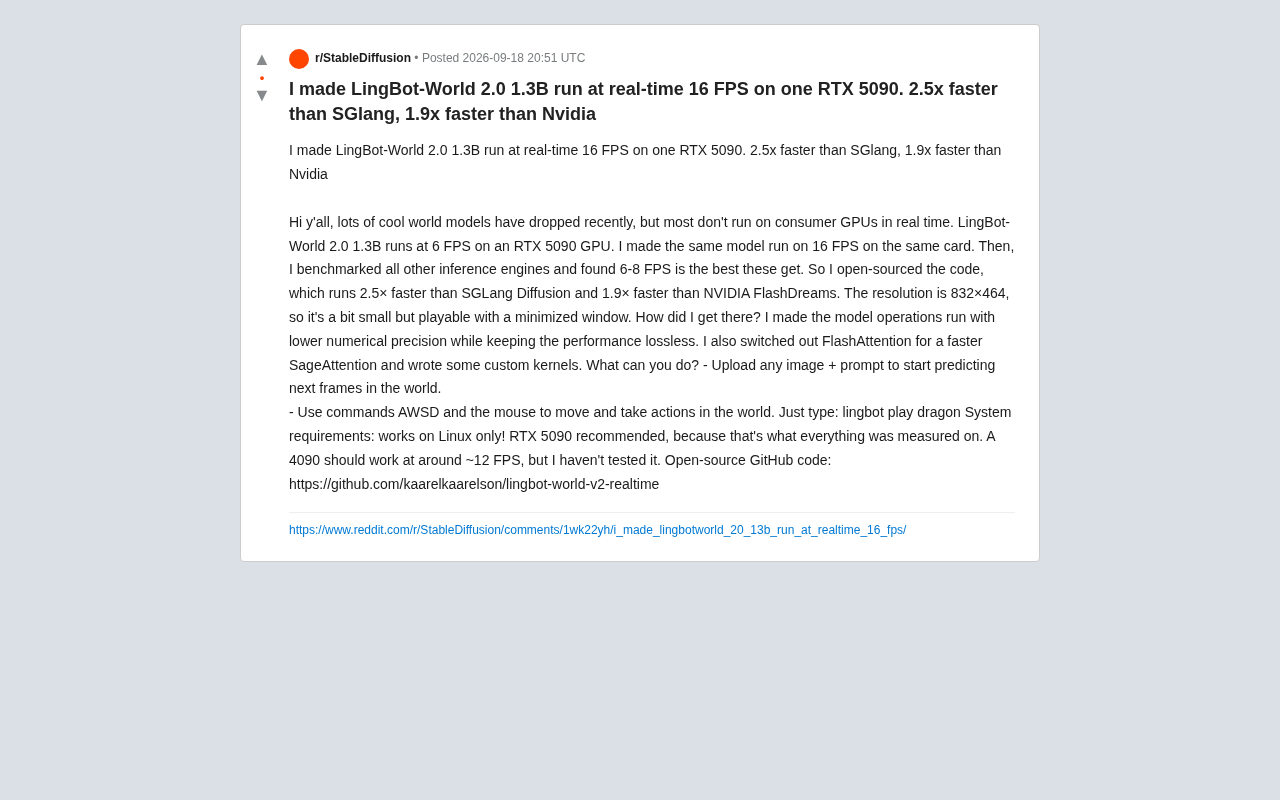
开发者通过三项推理优化将LingBot-World 2.0在RTX 5090上从6 FPS提升至16 FPS并完全开源。
一位开发者通过低精度运算、SageAttention替换FlashAttention、自定义CUDA内核三项组合优化,将交互式世界模型LingBot-World 2.0 1.3B在单张RTX 5090上的推理帧率从6 FPS提升至16 FPS,分别比SGLang Diffusion快2.5倍、比NVIDIA FlashDreams快1.9倍。该项目支持用户上传图片配合文字提示生成虚拟世界,并用键盘和鼠标实时操控,输出分辨率为832×464。代码已完全开源,但目前仅支持Linux系统。项目的核心价值在于证明:通过扎实的推理工程优化,消费级显卡已能跨越世界模型实时交互的基本门槛,无需替换底层模型或牺牲生成质量。
世界模型的实时化难题
近期涌现了不少令人惊艳的世界模型(World Model),它们能够根据一张图片和文字提示,实时预测并生成下一帧画面,让用户像玩游戏一样在生成的虚拟世界中移动。但这类模型有个共同的痛点——大多数无法在消费级显卡上实现真正的实时运行。
一位开发者在 Reddit 上分享了他的优化成果:将 LingBot-World 2.0 1.3B 模型在单张 RTX 5090 上的推理速度从原本的 6 FPS 提升到了 16 FPS,并将代码完全开源。这一速度相比业界主流的推理引擎有显著优势:比 SGLang Diffusion 快 2.5 倍,比 NVIDIA FlashDreams 快 1.9 倍。
世界模型(World Model)在 AI 领域特指能够对环境动态进行预测和模拟的生成模型,其概念源自认知科学与强化学习,核心目标是让模型"理解"物理规律、空间关系和因果逻辑,而不仅仅是拟合像素分布。近年来随着视频扩散模型(Video Diffusion Model)的成熟,世界模型开始具备交互能力:给定一张初始帧和动作指令,模型可以自回归地预测后续帧,形成可操控的虚拟环境。Google 的 Genie、OpenAI 的方向性探索以及国内多个团队的工作都属于这一范畴。LingBot-World 属于此类交互式视频扩散世界模型,其 1.3B 参数规模在同类产品中属于轻量级,但实时推理仍面临巨大挑战——视频扩散模型每生成一帧往往需要数十步去噪迭代,叠加 Transformer 注意力的二次复杂度,使得帧率成为消费级硬件上最难突破的瓶颈。
性能对比:主流推理引擎的天花板
根据作者的基准测试,他对市面上主流的推理引擎进行了横向对比,发现这些引擎在同样硬件上运行该模型时,速度普遍卡在 6-8 FPS 这个区间,很难突破。
具体的性能数据如下:
- 原始 LingBot-World 2.0 1.3B:RTX 5090 上 6 FPS
- 优化后的开源版本:RTX 5090 上 16 FPS
- 相比 SGLang Diffusion:快 2.5 倍
- 相比 NVIDIA FlashDreams:快 1.9 倍
值得一提的是,16 FPS 对于实时交互式世界模型来说已经进入了「可玩」的门槛。虽然分辨率被限制在 832×464,画面尺寸偏小,需要在最小化窗口下体验,但对于本地运行的世界模型而言,这样的帧率已经相当难得。
技术揭秘:如何榨干显卡性能
作者在帖子中简要说明了他的三大优化手段,这些方法组合起来实现了近三倍的加速:
低精度数值运算
第一项优化是让模型的运算以更低的数值精度执行,同时保持性能无损(lossless)。降低数值精度是推理加速的常见手段,但要在不损失生成质量的前提下做到这一点,需要对哪些算子可以降精度、哪些必须保留高精度有精细的把控。
更快的注意力机制
第二项优化是将模型中使用的 FlashAttention 替换为速度更快的 SageAttention。注意力机制往往是 Transformer 类模型的计算瓶颈,SageAttention 通过量化等技术在注意力计算上提供了更高的吞吐,这也是近年来推理加速的一个重要方向。
SageAttention 是由清华大学等机构提出的一种高效注意力计算方案,其核心思路是对注意力矩阵中的 Q、K 进行 INT8 量化,对 V 保留较高精度,从而在大幅降低显存带宽压力的同时,将精度损失控制在感知阈值之内。与 FlashAttention 系列通过分块(tiling)减少 HBM 读写次数不同,SageAttention 主要通过混合精度量化来提升算术强度(arithmetic intensity),两种技术的优化维度并不相同,因此在某些模型和硬件组合上,SageAttention 能够提供超越 FlashAttention 2/3 的实测吞吐。对于扩散类世界模型而言,每一帧的生成都需要完整跑一遍 Transformer 的注意力层,注意力计算的延迟直接决定帧率上限,因此这一替换带来的收益格外显著。
自定义 CUDA 内核
第三项优化是编写了一些自定义内核(custom kernels)。当通用框架无法充分利用硬件特性时,手写针对性的 kernel 往往能带来额外的性能提升。这三项优化叠加,才共同实现了从 6 FPS 到 16 FPS 的跨越。
自定义 CUDA 内核(custom CUDA kernel)是指开发者绕过 PyTorch、JAX 等高层框架,直接用 CUDA C/C++ 或 Triton 语言编写在 GPU 上运行的底层计算程序。通用框架为了兼容性往往无法针对特定算子的形状、数据布局或访存模式做深度优化,而手写内核可以精确控制线程束(warp)调度、共享内存使用和指令流水,消除框架开销并最大化硬件利用率。在推理场景中,常见的优化目标包括:将多个连续算子融合(kernel fusion)以减少中间张量的显存读写、针对特定分辨率或批量大小手动调整 tile 尺寸,以及利用 Tensor Core 的特定指令集获得更高的矩阵乘法吞吐。对于世界模型这类对延迟极度敏感的应用,自定义内核往往是在前两项优化已经到达瓶颈后,进一步"榨干"硬件性能的最后手段。
如何上手体验
这个项目的交互方式很直观,基本还原了「在生成世界里玩耍」的体验:
- 输入起点:上传任意一张图片,配合文字提示,模型即可开始预测这个世界的后续帧
- 实时操控:使用键盘的 AWSD 键和鼠标,在生成的世界中移动、执行动作
- 快速启动:只需在命令行输入
lingbot play dragon即可开始体验
系统要求
需要注意的是,这个项目目前仅支持 Linux 系统。作者推荐使用 RTX 5090,因为所有的性能数据都是基于这块卡测得的。他估计 RTX 4090 大约能跑到 12 FPS,但坦言尚未实际测试验证。
完整的开源代码已发布在 GitHub 上:kaarelkaarelson/lingbot-world-v2-realtime。
一点观察
世界模型是当前 AI 领域一个热度很高的方向,但推理成本和实时性一直是它走向消费端的障碍。这个项目的意义不在于模型本身,而在于展示了通过低精度运算、注意力优化和自定义内核这一整套工程手段,能够在不换模型、不损失质量的前提下大幅提升实时性能。
对于希望在本地折腾世界模型的开发者和爱好者来说,这套开源代码提供了一个很好的参考样本——它证明了消费级硬件距离实时世界模型的门槛,往往就差一层扎实的推理优化。当然,832×464 的分辨率和 Linux-only 的限制说明这仍是一个早期项目,实际体验和跨硬件表现还有待社区进一步验证。
相关推荐
Gemini Live API重磅更新:原生音频首次支持前沿级推理
Gemini Live API迎来重磅更新:主动式音频、上下文注入、异步函数调用四大功能落地,更首次将前沿级高阶推理引入原生音频体验,为语音AI应用带来突破。
自托管Whispersync:让电子书与有声书进度自动同步
Concordance是一个开源自托管Whispersync方案,通过KOReader、Calibre-Web-Automated和Audiobookshelf实现电子书与有声书进度双向同步。采用分层强制对齐与字符级定位,MIT许可,适合自托管电子书爱好者。
陶哲轩:数学不止是证明,我们该如何看待其余部分
菲尔兹奖得主陶哲轩撰文指出,数学远不止于证明,提出问题、构建概念、阐释直觉等工作同样重要却被低估。在AI辅助证明兴起的当下,重新认可这些贡献关乎数学的未来定位。