DantinoX:统一三大范式的开源语言建模框架
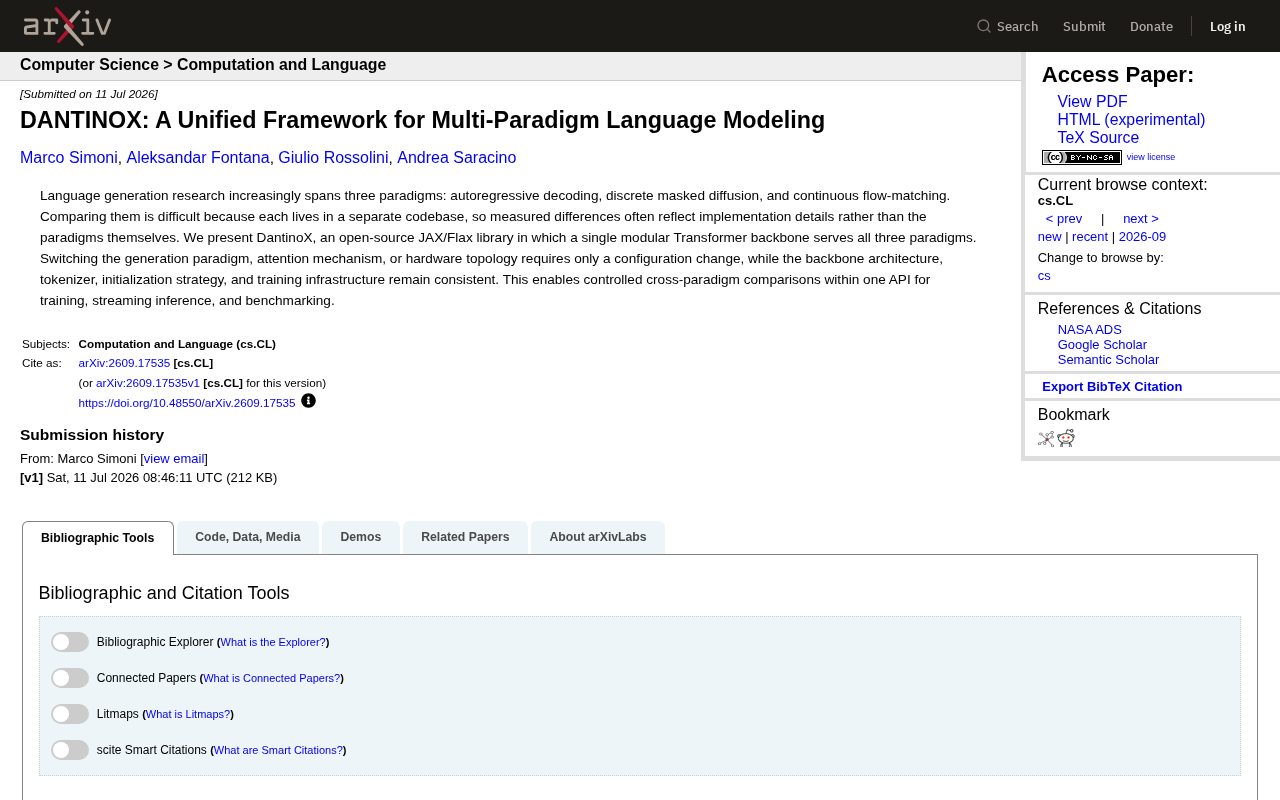
DantinoX用单一模块化Transformer主干统一自回归、扩散与流匹配三大生成范式,实现跨范式受控比较。
语言生成领域的自回归解码、离散掩码扩散和连续流匹配三大范式长期各自割据独立代码库,导致跨范式比较的结论难以区分"范式差异"与"实现差异"。DantinoX是一个基于JAX/Flax的开源框架,通过将三种范式统一到单一模块化Transformer主干之下,使研究者只需修改配置项即可切换生成范式、注意力机制或硬件拓扑,同时保持分词器、初始化策略和训练基础设施完全一致。框架在同一套API中整合了训练、流式推理和基准测试三个环节,从方法论上为语言生成研究提供了"受控实验"的基础设施,有助于沉淀更可靠的领域共识,其价值超出单一工具本身。
语言生成的范式割裂问题
当下的语言生成研究正沿着三条技术路线并行推进:自回归解码(autoregressive decoding)、离散掩码扩散(discrete masked diffusion)以及连续流匹配(continuous flow-matching)。三者代表了截然不同的生成哲学——自回归逐词预测、扩散模型从噪声逐步还原、流匹配则在连续空间中构建概率路径。
问题在于,这三种范式几乎各自生长在独立的代码库中。研究者想要横向对比它们的优劣时,往往会陷入一个陷阱:测出来的性能差异,究竟是范式本身带来的,还是实现细节(分词器、初始化策略、训练基础设施)造成的?这种"苹果对橘子"的比较,长期困扰着语言生成领域的实证研究。
自回归解码是目前最主流的大语言模型生成方式,GPT系列即采用此路线:模型每次根据已生成的所有token预测下一个token,逐词串行输出。其优势是训练目标简单、采样可控,缺点是推理速度受序列长度线性制约。离散掩码扩散借鉴了BERT的掩码语言建模思路,并将扩散模型的"逐步去噪"框架移植到离散token空间——训练时对序列随机掩码并还原,推理时从全掩码序列出发,多步迭代填充内容,代表工作有MDLM、SEDD等。连续流匹配则彻底跳出离散token空间,在词向量的连续嵌入空间中构建从噪声分布到数据分布的概率流,用常微分方程(ODE)描述生成轨迹,推理时沿轨迹积分即可采样,在图像生成领域已取得显著成果(如Stable Diffusion 3),语言侧的探索尚在早期阶段。三种范式在解码并行性、训练稳定性和生成质量上各有取舍,正是缺乏统一比较基准,使得哪种范式在语言任务上更优仍无定论。
DantinoX 给出的解法
针对这一痛点,一篇发表于 arXiv 的论文提出了 DantinoX——一个基于 JAX/Flax 的开源库。它的核心设计理念可以用一句话概括:用单一的模块化 Transformer 主干,同时服务于全部三种生成范式。
这意味着,当研究者想从自回归切换到扩散、或者调整注意力机制、甚至更换硬件拓扑时,只需要修改一处配置项即可。主干架构、分词器、初始化策略和训练基础设施在整个过程中保持完全一致。
这种"控制变量"式的设计,正是 DantinoX 最有价值的地方。它把此前难以剥离的实现噪声固定下来,让范式之间的比较回归到范式本身。
一套 API 打通训练、推理与评测
DantinoX 在同一套 API 下整合了三个关键环节:
- 训练:三种范式共享统一的训练流程
- 流式推理(streaming inference):支持实时生成场景
- 基准测试(benchmarking):在可控条件下进行跨范式评估
这种一体化的设计降低了研究者的迁移成本——不再需要为每种范式维护一套独立的工程栈。
为什么这件事值得关注
从方法论角度看,DantinoX 的意义超出了工具本身。语言生成领域近年来涌现了大量新范式,但缺乏公平的对比基准,导致很多结论难以复现或相互矛盾。一个能够剥离实现干扰、进行"受控实验"的框架,有助于沉淀出更可靠的领域共识。
选择 JAX/Flax 作为技术底座也颇具考量。JAX 在硬件并行、函数式编程和大规模训练方面的优势,让这个框架天然适合探索不同的硬件拓扑配置,这也解释了为何切换硬件拓扑只需改配置。
作为一个开源项目,DantinoX 的价值还在于可复现性。研究社区可以在同一代码基础上验证彼此的结论,减少因工程差异带来的争议。
JAX 是 Google 开发的数值计算框架,其核心特性是函数变换(function transformations):jit(即时编译到XLA)、vmap(自动向量化)和pmap/shard_map(跨设备并行)可以任意组合,使同一份Python代码能以极低的工程成本在CPU、GPU和TPU Pod上运行,并且自动适配不同的硬件拓扑(数据并行、模型并行、流水线并行)。Flax 是基于JAX的神经网络库,提供类似PyTorch Module的模块化抽象,同时保留JAX的函数式风格——模型参数作为显式状态传入而非隐式绑定在对象上,这使得多设备参数分片(sharding)的控制更加透明。对于需要在不同硬件拓扑下测试同一模型的研究场景,这一技术栈能够在配置层面完成切换,无需重写模型逻辑,这也是DantinoX选择JAX/Flax而非PyTorch的关键动因。
小结
DantinoX 试图解决的是语言生成研究中一个基础却棘手的工程与方法论问题:如何公平地比较不同的生成范式。通过将自回归、离散掩码扩散和连续流匹配统一到一个模块化 Transformer 主干之下,它让跨范式的受控比较成为可能。对于关注语言模型底层机制的研究者而言,这类基础设施型工作往往比单一模型的性能刷榜更具长期价值。
(注:本文基于 arXiv 论文摘要整理,具体实现细节与实验结果请以原论文为准。)
相关推荐
冰岛Treble获1800万美元融资,押注语音仿真平台
冰岛语音仿真公司Treble完成1800万美元融资,其平台服务于语音AI模型开发者、AI可穿戴设备及机器人公司。本文解析语音仿真技术价值与融资背后的行业信号。
开源之痛:非自回归架构的先行者,为何被前沿实验室抢了风头
一位独立开发者在 Reddit 发帖称,其一年前开源的非自回归 RL 架构,被前沿实验室重新包装为突破。本文拆解 PPO 序列嵌入与 RLCD 并行采样两种路线的异同,并探讨开源生态的溯源与署名困境。
AI全程规划葡萄园:一场100株葡萄藤的真实实验
华盛顿州斯波坎一位爱好者让Muse AI全程规划葡萄园,从品种选择、行距到灌溉全部交给AI,最终种下100株品丽珠。这场AI主导、人类执行的公开实验,揭示了AI辅助农业的机会与边界。