Databricks数据仓库与BI实践指南:从架构到AI就绪

Databricks发布实战指南,阐述如何在Lakehouse架构上融合数仓、治理与AI能力以加速洞察交付。
Databricks《数据仓库与商业智能大全》提出,数据团队的价值不应止步于仪表盘,而需构建涵盖架构、治理与AI集成的完整平台基础设施。指南围绕Lakehouse(湖仓一体)架构展开,提供迁移策略、维度建模落地方法及规模化性能与成本优化方案。治理层面,Unity Catalog统一覆盖访问控制、数据血缘与合规管理。前瞻性内容则探讨"AI/BI就绪"理念——强调在架构设计初期就为AI应用预留数据质量与接口基础,使平台从回答"发生了什么"延伸至"为什么"和"接下来会怎样"。作为厂商官方材料,读者应结合自身技术栈独立判断。
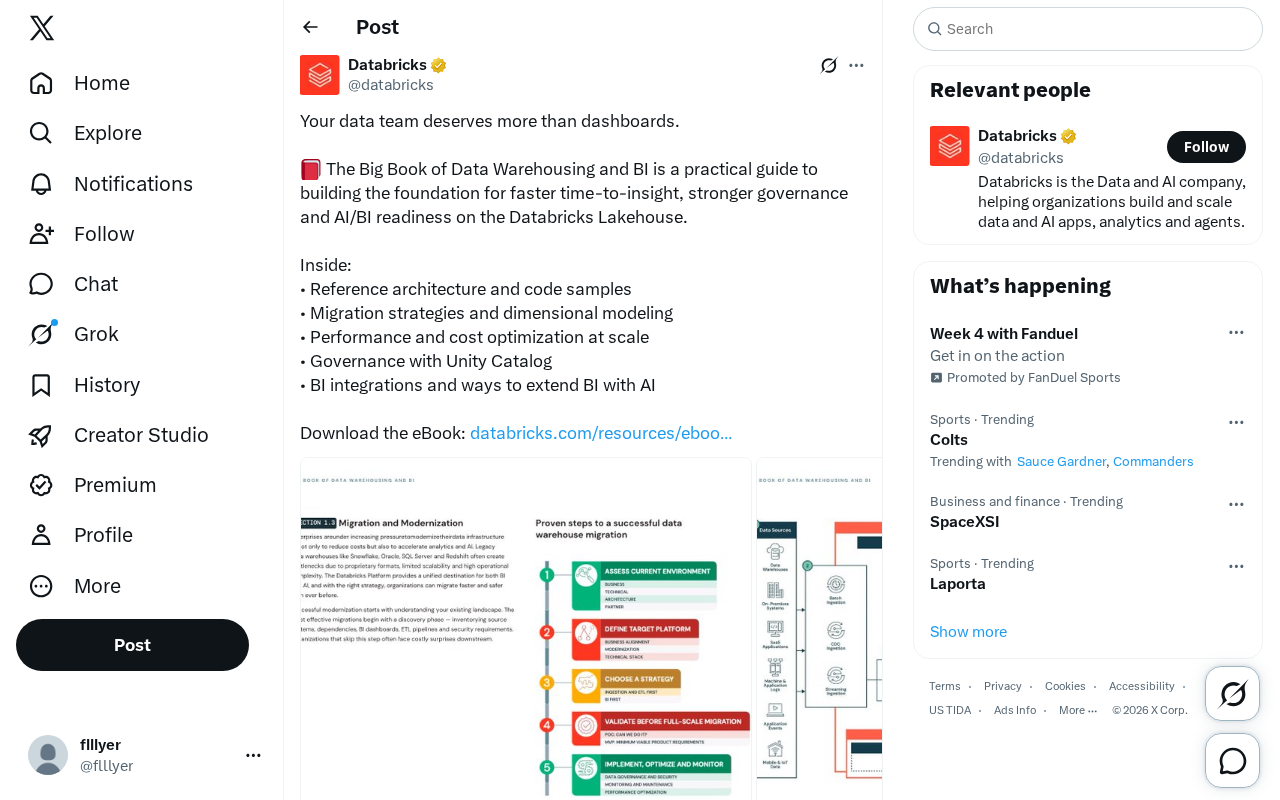
数据团队的价值不应止步于仪表盘。Databricks近期推出的《The Big Book of Data Warehousing and BI》(数据仓库与商业智能大全)是一本面向实战的指南,聚焦如何在Databricks Lakehouse架构上构建更快的洞察交付能力、更强的数据治理,以及面向AI/BI的就绪能力。本文基于该电子书的核心内容,梳理现代数据平台建设的关键要点。
为什么仪表盘不够用了
长期以来,许多企业的数据团队把工作重心放在交付BI仪表盘上。但在数据规模持续膨胀、AI应用快速落地的背景下,仪表盘只是最终呈现层,真正决定洞察速度和质量的是底层架构。
这本指南提出的核心观点是:数据团队需要的是一套完整的基础设施,而不只是可视化的终端产品。只有把数据仓库、治理和AI能力整合到统一的架构中,才能实现"更快的洞察时间"(faster time-to-insight)。这一思路反映了行业从单纯报表驱动,向数据平台工程化转型的趋势。
Lakehouse架构:仓库与湖的融合
Databricks主推的Lakehouse(湖仓一体)理念,是把数据湖的灵活性与数据仓库的结构化查询能力结合起来。这本指南提供了参考架构(reference architecture)和可直接复用的代码样例,帮助团队快速搭建符合最佳实践的平台骨架。
迁移与建模策略
对于已有传统数据仓库的企业,迁移往往是最棘手的环节。指南专门讨论了迁移策略,并详细介绍了维度建模(dimensional modeling)——这是构建分析型数据模型的经典方法论。把成熟的维度建模思路落地到Lakehouse平台上,意味着团队既能保留原有的分析逻辑,又能享受新架构的扩展性。
维度建模(Dimensional Modeling)由数据仓库先驱Ralph Kimball于1990年代系统化提出,其核心是将业务数据组织成"事实表"(Fact Table)与"维度表"(Dimension Table)两类结构。事实表存放可度量的业务指标(如销售额、订单量),维度表则存放描述性上下文(如时间、地区、产品类别)。两者通过星型模式(Star Schema)或雪花模式(Snowflake Schema)连接,使分析查询既直观又高效。这套方法论之所以历经三十年仍是主流,在于它高度贴合业务人员的思维方式,同时为OLAP(联机分析处理)查询提供了天然优化的数据结构。将其迁移至Lakehouse架构时,最大的挑战在于传统维度建模依赖严格的ETL流程和关系型数据库约束,而Lakehouse的开放格式(如Delta Lake)需要在Schema灵活性与分析性能之间重新寻找平衡点。
规模化的性能与成本优化
当数据量和查询并发达到企业级规模时,性能与成本成为无法回避的问题。指南围绕"规模化下的性能和成本优化"(performance and cost optimization at scale)给出了具体方法。这部分内容对于控制云端数据平台的长期运营成本尤为关键,也是衡量一个数据架构是否可持续的重要指标。
用Unity Catalog做统一治理
数据治理是现代数据平台的另一块基石。指南把治理能力落在Unity Catalog上——这是Databricks提供的统一治理组件,覆盖数据资产的访问控制、血缘追踪和合规管理。
随着数据在不同团队和应用间流转,缺乏统一治理会带来安全风险和合规隐患。通过Unity Catalog建立集中式的权限与元数据管理,团队可以在保证开放协作的同时,守住数据安全与合规的底线。这也是"更强治理"(stronger governance)承诺的技术支撑。
数据血缘(Data Lineage)是数据治理中的关键能力,指追踪数据从源头到最终消费全链路的能力——包括数据来自哪里、经过哪些转换、被哪些下游系统或报表使用。当某张上游表发生结构变更或数据质量问题时,血缘图谱能帮助团队迅速定位影响范围,而不必逐一排查所有下游依赖。Unity Catalog的血缘追踪在列级别(Column-level Lineage)实现可见性,这对满足GDPR等数据隐私法规尤为重要——监管机构要求企业能够证明特定个人数据在系统中的完整流转路径。对于同时运营多条业务线、数据流向复杂的大型企业,列级血缘往往是数据合规审计的核心依据。
BI与AI的融合:下一步方向
指南最具前瞻性的部分,是探讨如何用AI扩展传统BI的能力(extend BI with AI)。传统BI回答的是"发生了什么",而结合AI能力后,平台可以进一步回答"为什么发生"以及"接下来会怎样"。
所谓"AI/BI就绪"(AI/BI readiness),指的是数据平台在架构设计之初就为AI应用预留好数据质量、治理和接口能力。当底层数据经过规范建模和统一治理后,无论是训练模型、驱动自然语言查询,还是构建智能分析助手,都能获得更可靠的数据基础。这也解释了为什么指南强调架构、建模、治理要和AI能力整体规划,而非事后补救。
自然语言查询(Natural Language Query,NLQ)是"AI扩展BI"最直接的落地形式之一,允许业务用户用日常语言提问(如"上季度华东区销售额同比变化多少"),由AI层将其翻译为SQL并返回结果,从而绕过对专业分析师或SQL技能的依赖。这类能力的实际效果高度依赖底层数据的规范程度:表名、字段命名、业务含义注释(元数据)越清晰,大语言模型生成的SQL越准确。这也是指南强调"AI/BI就绪需在架构设计初期规划"的深层原因——事后为混乱的数据模型套上NLQ接口,往往产生大量幻觉性错误答案,反而损害业务对数据平台的信任度。
对数据团队的启示
从这本指南的结构可以看出,构建现代数据平台是一项系统工程,涉及架构设计、迁移规划、建模、性能调优、治理和AI集成等多个层面。对于正在评估技术选型或推进平台升级的团队,这类实践指南的价值在于提供了端到端的参考路径,以及可落地的代码样例。
需要提醒的是,作为厂商发布的官方资料,内容自然会围绕Databricks自身生态展开。读者在参考其方法论的同时,也应结合自身的技术栈和业务场景做独立判断。完整电子书可通过Databricks官方渠道免费下载。
相关推荐

MCP工具投毒:被忽视的AI智能体攻击面与防御之道
MCP工具投毒正成为智能体AI的新攻击面。本文解析工具描述为何可被恶意利用,剖析信息鸿沟与数据外泄链条,并给出白名单注册表、哈希固定、最小权限与链路策略等分层防御方案。
MCP联合创造者:智能体需要的是连接性,而非更强模型
MCP联合创造者David Soria Parra在演讲中指出,决定智能体未来的是连接性与开放标准,而非更强的模型。本文梳理模型能力演进、编程Agent落地逻辑、MCP的无状态改造及Tasks、Skills、身份授权等未来路线图。
SageMaker新技能上线:为编码智能体赋能生成式AI推理优化
Amazon SageMaker 推出 aws-ai-ml 新技能,通过 Agent Toolkit for AWS 为 Kiro、Claude Code、Codex 等编码智能体注入生成式AI推理优化专长,支持自然语言生成可执行的 SageMaker Python SDK v3 代码完成基准测试、推荐与对比。