Datasette 流式导出新插件 datasette-arrows 发布
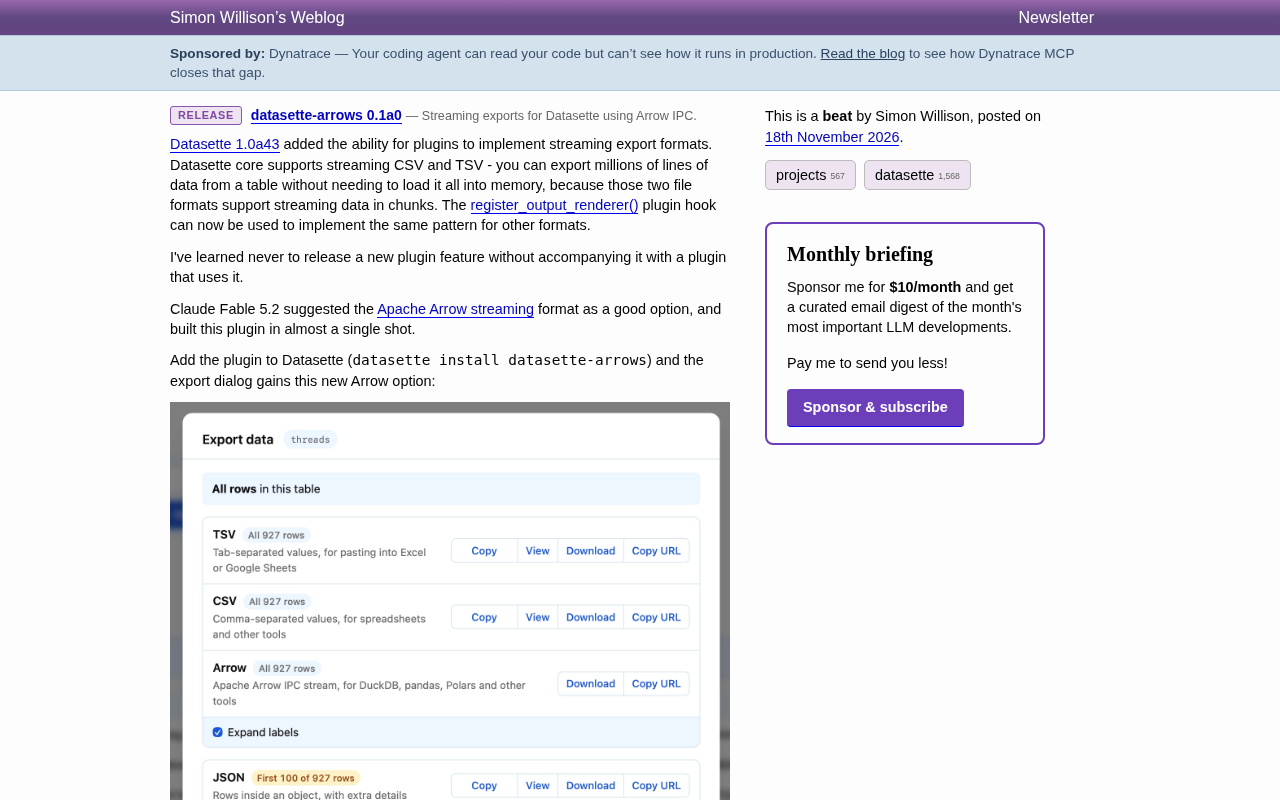
Datasette 新插件 datasette-arrows 借助流式导出钩子提供 Apache Arrow IPC 流格式导出。
Simon Willison 发布了 datasette-arrows 0.1a0 插件,为 Datasette 增加 Apache Arrow IPC 流格式导出能力。该插件基于 Datasette 1.0a43 开放的新能力:`register_output_renderer()` 钩子现在支持流式导出,插件可以像核心的 CSV/TSV 导出一样逐块输出数据,而无需将全部结果加载进内存。datasette-arrows 是该钩子的首个参考实现,作者坚持“发布新插件功能时必配示例插件”的原则。选择 Arrow 是因为其列式内存格式被 DuckDB、pandas、Polars 等分析工具广泛支持,导出的流可直接读取,省去格式转换。安装只需 `datasette install datasette-arrows`。当前 main 分支已展示 Arrow 选项,正式版本的分组调整将在下个 alpha 到来。
Datasette 生态迎来一个有意思的新成员。Simon Willison 发布了 datasette-arrows 0.1a0,为 Datasette 增加了 Apache Arrow IPC 流格式的导出能力。这个插件的诞生,源于 Datasette 1.0a43 引入的一项底层能力升级:插件现在可以实现流式导出格式。
流式导出:从核心能力到插件生态
Datasette 核心此前已经支持流式 CSV 和 TSV 导出。这意味着即使表里有数百万行数据,导出过程也不需要把全部内容一次性加载进内存,而是按块流式输出。对于数据量大的场景,这是很实际的能力。
Datasette 1.0a43 把这项能力开放给了插件作者。register_output_renderer() 插件钩子现在可以让第三方插件实现同样的流式模式,而不再局限于核心内置的两种格式。
datasette-arrows 就是这个钩子的第一个实践者。作者在发布说明里提到一个原则:"我从不在没有配套插件的情况下发布新的插件功能。"这种"功能加示例"的发布方式,对生态建设有实际价值——插件作者有了可参考的实现,用户也能立刻看到新能力的用途。
register_output_renderer() 是 Datasette 插件体系中的核心钩子之一,允许插件注册自定义的导出格式。它接收一个包含 datasette、columns、rows(或流式游标)、sql 等参数的对象,并返回一个三元组:响应体、内容类型和可选的文件名。在 1.0a43 之前,该钩子只能接收完整的结果集列表,无法处理生成器或异步迭代器,因此插件无法实现真正的流式输出。1.0a43 的改动使钩子支持传入可迭代的流式数据源,插件可以逐块消费数据并直接写入响应,从而避免将全部结果加载到内存。这一升级对处理大规模 SQLite 表尤为关键,因为 Datasette 的典型使用场景就是快速暴露可能包含数百万行的数据库。
为什么选 Apache Arrow
据发布说明,这个插件由 Claude Fable 5.2 建议采用 Apache Arrow 流格式,并且几乎一次性完成了插件构建。
Apache Arrow 的 IPC 流格式适合这个场景有几个原因。它是一种列式内存格式,在数据分析工具链里被广泛支持。通过 Datasette 导出的 Arrow 流,可以直接被 DuckDB、pandas、Polars 等工具读取,省去了格式转换的中间步骤。对于需要把 Datasette 里的数据接入分析流程的用户,这比 CSV 更贴近下游工具的输入需求。
安装方式很简单:datasette install datasette-arrows。安装后,导出对话框会多出一个 Arrow 选项。
Apache Arrow IPC 流格式是一种跨语言的内存列式数据表示标准,其核心设计目标是在不同系统之间零拷贝地共享数据。IPC(Inter-Process Communication)流格式将数据按批次(record batch)序列化到连续的字节流中,每个批次包含固定数量的行,并附带描述 schema 的元数据。与 CSV 相比,Arrow 保留了严格的数据类型(如 int64、timestamp、decimal),无需在读取端重新推断类型,也避免了浮点数精度丢失和日期解析歧义。列式布局还使得下游工具可以只读取需要的列,并利用向量化执行引擎加速分析。DuckDB、pandas(通过 pyarrow)、Polars 等工具均原生支持从 Arrow IPC 流读取数据,因此 Datasette 导出的流可以直接被这些工具消费,无需中间转换。
当前状态与后续计划
截图展示的是 Datasette main 分支上的效果。导出对话框里,TSV 和 CSV 旁边新增了 Arrow 选项,显示"All 927 rows",并标注了 Apache Arrow IPC stream,说明适用于 DuckDB、pandas、Polars 等工具,提供 Download 和 Copy URL 两个按钮。
需要说明的是,最近一次正式发布还没有把 Arrow 这类流式格式和 TSV、CSV 一起归入"All rows in this table"分组,这个调整会在下一个 alpha 版本里到来。也就是说,插件的功能已经可用,但界面归类还会继续打磨。
一点观察
这个发布体现了 Datasette 插件体系的一个特点:核心保持精简,能力通过插件扩展,而新钩子上线时配套一个参考实现。这种做法既降低了核心的维护负担,也让生态里的插件作者有明确的范式可循。
对数据分析工作流而言,Arrow 导出的加入让 Datasette 更像一个数据中转站——从 SQLite 表直接流式输出到分析工具,中间少了一道格式转换。对于经常在 Datasette 和 Python 数据栈之间搬数据的人来说,这个插件值得一试。
相关推荐

Gemini 4 Hydrogen 对比测试:仅耗1%周配额,表现不输Sonnet
实测Gemini 4 Hydrogen与Sonnet完成同一CRUD任务:Hydrogen仅耗1%周配额,表现相当且UI细节更优,而Anthropic模型耗7%。开发者建议日常任务不必迷信高价模型。

Gemini 4 Neon发布:多项基准超越Opus 5.5,谷歌重回第一梯队
谷歌DeepMind发布Gemini 4 Neon,Artificial Analysis智能指数61分排名第三,编程指数登顶第一,多项基准超越Opus 5.5,定价每百万token输入3美元输出15美元,已在Gemini API和AI Studio开放。

Gemini 4 Neon评测:跑分直逼Carbon,API性价比解析
Google Gemini 4 Neon 全面评测:跑分直逼 Carbon,API 定价为 Hydrogen 两倍,Antigravity 额度消耗仅一倍而 Carbon 为三倍,实测可替代 90% Carbon 场景。附渠道限制、封号风险与组合策略分析。