DeepSeek+RAGFlow本地部署个人知识库全流程教程
用Ollama + RAGFlow在本地搭建隐私可控的私有知识库,让DeepSeek读懂你的私有文件。
本文介绍了一套完整的本地私有知识库搭建方案,核心目的是解决网页版大模型的两大痛点:数据隐私泄露和文件上传限制。方案采用RAG(检索增强生成)技术,通过Embedding模型将私有文档转为语义向量,在用户提问时实时检索相关内容并注入模型上下文,让大模型「边考边抄」而非靠记忆回答。部署分三步:用Ollama在本地运行DeepSeek(建议从1.5B模型起步)、用Docker一键部署RAGFlow(完整版自带Embedding模型)、在RAGFlow中上传文件并完成解析。对不追求绝对隐私的用户,也可只部署RAGFlow并接入在线API,在便捷性与隐私保护之间灵活取舍。
为什么要在本地搭建自己的知识库
网页版的 DeepSeek广告 已经足够好用,但一旦涉及私有资料,痛点就暴露出来了。视频作者举了一个生动的例子:作为「谢宝王」的员工去问 DeepSeek「如何接待一只沙丁鱼」,它只会告诉你「立刻放进冷藏室」——因为模型根本不知道你公司的规章制度。
要让大模型理解你的私有内容,传统做法是上传附件,但这带来三个绕不开的问题:一是数据隐私,所有内容都会上传到 DeepSeek 服务器;二是文件上传数量受限,且往往需要付费,构建包含几百个文件的知识库时模型无力支撑;三是扩展上下文很繁琐,每次新建对话都要重新上传附件,增删改也很困难。
本地部署要解决的正是两个核心需求:绝对的隐私保护和个性化知识库构建。前者通过本地部署 DeepSeek 大模型实现,请求不再发往他人服务器;后者则依靠 RAG(检索增强生成)技术来完成。作者坦言,这套方案其实是他上学期的期末作业,属于「实践验证过」的可行路径。
RAG 与 Embedding:原理速览
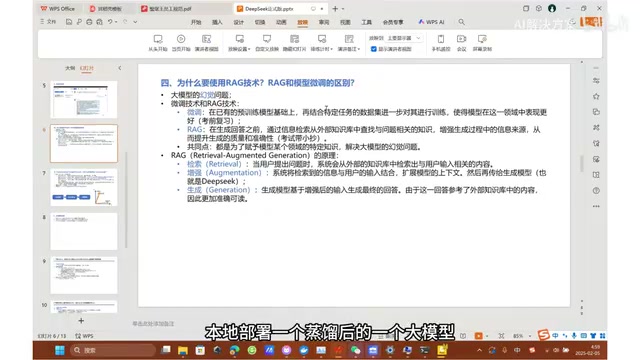
RAG 和模型微调都是为了解决大模型的「幻觉」问题——即模型在不知道答案时会胡编乱造。作者用了一个很形象的比喻:微调是「考前复习」,模型通过训练把知识吸收进参数里;RAG 则是「开卷考试,边考边抄」,看到问题就疯狂翻你的知识库。
对个人和企业来说,本地微调一个大模型成本极高,退而求其次微调小模型效果又差。因此,本地部署一个蒸馏后的模型 + RAG 针对性检索生成,被验证为性价比出色的方案。
RAG 的工作流程分三步:检索(Retrieval)从外部知识库找到与问题相关的内容;增强(Augmented)把检索结果与用户输入结合,扩展模型上下文;生成(Generation)由对话模型基于增强后的输入产出最终回答。
那么为什么还需要 Embedding 模型?因为文本是自然语言,机器无法直接计算文本之间的相似关系。Embedding 模型的作用是把 PDF、Word 中的文本转换为高维向量。作者用「谢宝王、比奇宝、深度学习」三个词举例:Embedding 后会把「谢宝王」和「比奇宝」映射到相近的向量空间,而「深度学习」则被映射到较远的位置。用户提问同样会被转成向量,系统通过余弦相似度等度量方式,在知识库中匹配最相关的文段。作者把这个过程比作「给每个文段生成独一无二的指纹,再拿用户问题的指纹去指纹库里匹配」。
这也解释了为什么网页版聊天免费、上传文件却要收费——文件解析、Embedding 嵌入、图片表格处理等都需要额外的存储与算力。
幻觉(Hallucination) 是大语言模型的一种固有缺陷:由于模型的知识被「冻结」在训练数据截止时间点,且参数中存储的知识并非完全精确,当被问到训练数据未覆盖的问题时,模型倾向于「自信地编造」看似合理的答案,而非坦承不知。RAG 通过在每次推理时动态注入外部文档,让模型「有据可查」,从源头减少幻觉发生的概率。值得注意的是,RAG 并不能完全消除幻觉,检索到的文段如果本身不相关,或模型在整合多段内容时出现逻辑混淆,仍可能产生错误答案。因此实际使用中,检索质量(即 Embedding 模型的语义理解能力)和分块策略(如何把文档切分成合适的段落)对最终回答质量影响很大。
本地部署三步走
整个部署过程分为三步:用 Ollama 拉取并运行 DeepSeek 模型、通过 Docker 部署 RAGFlow、在 RAGFlow 中构建知识库。
第一步:用 Ollama 运行 DeepSeek
Ollama 是一个用于本地运行和管理大语言模型的工具,可以理解为存放开源模型的平台加下载运行工具。从 ollama.com/download 下载安装后,有两个关键的环境变量需要配置:
- OLLAMA_HOST 设为
0.0.0.0:11434:这一步是必须的。默认情况下 Ollama 只监听 localhost,Docker 里的 RAGFlow 无法访问。设为0.0.0.0后可监听所有 IP。如果配置后虚拟机仍无法访问,可能是本机防火墙拦截了 11434 端口,需要放行。 - 模型下载路径:模型动辄几十 GB,最好改一下默认存放位置。
作者特别提醒:配置完环境变量一定要重启电脑。他曾经改完配置后下了一小时模型,第二天重启才发现自定义位置生效、模型列表清空,「感觉天都塌了」。
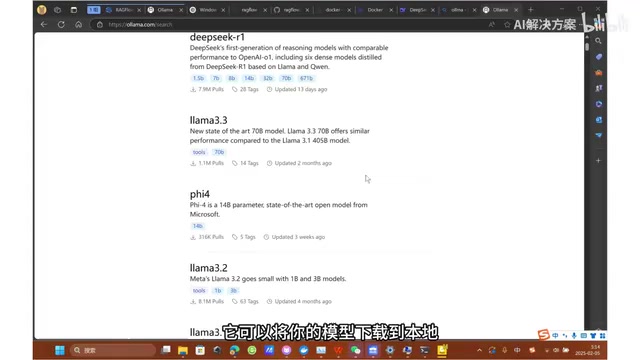
配置完成后,在 ollama.com/models 选择 DeepSeek R1 模型。完整的原始模型参数量高达 671B、大小 404GB,个人电脑带不动,建议从 1.5B 开始尝试;有外接 GPU 可试 14B、32B,据说 32B 已能达到非常高的效果。复制命令行在 CMD 中运行,能正常回复即表示部署成功。
模型参数量(B 即 Billion,十亿)直接决定了模型的推理能力与运行所需的硬件资源。以 DeepSeek R1 为例,1.5B 模型约需 2-4GB 显存或内存,普通笔记本也可运行,但复杂推理能力较弱;7B/8B 约需 8GB 显存;14B 约需 16GB;32B 则需要 24GB 以上的高端显卡。此外,模型还分为全精度(FP16/BF16)和量化版本(Q4、Q8 等),量化版通过降低每个参数的比特位数来压缩体积与显存占用,以略微牺牲精度换取可在消费级硬件上运行的能力。Ollama 上提供的模型通常已经过 GGUF 格式量化,1.5B 与 7B 是个人用户最常见的入门选择。
第二步:用 Docker 部署 RAGFlow
先从 GitHub 下载 RAGFlow 源代码(可直接 Download ZIP 解压),再下载对应系统版本的 Docker。
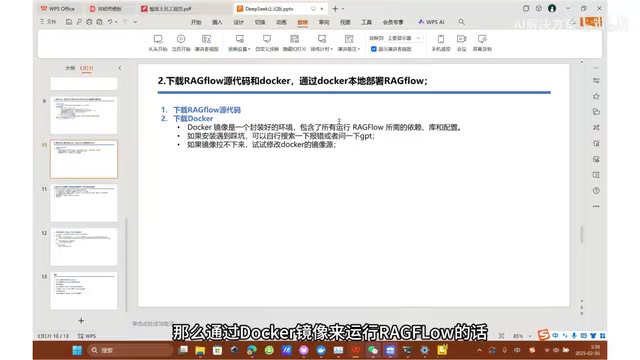
为什么需要 Docker?因为 RAGFlow 运行需要数据库(如 ChromaDB、MySQL、Redis)等大量依赖和配置,手动配置极其复杂。Docker 镜像相当于一个封装好的环境,「像在你电脑里装了一台小电脑」,所有依赖都预置好了。如果镜像拉不下来,可以自行配置 Docker 镜像源。
一个关键配置:进入源代码的 docker 文件夹,打开 .env 环境文件,在约 84 行处把轻量版注释掉、取消完整版的注释。轻量版不含 Embedding 模型,而完整版自带 Embedding,可直接使用,省去额外部署。改完保存后,在该目录运行启动命令,Docker 会自动拉取镜像并启动服务。成功后在浏览器访问 localhost:80 即可看到 RAGFlow 页面并注册登录。
Docker 是一种容器化技术,与虚拟机的核心区别在于:虚拟机会模拟一套完整的操作系统,而 Docker 容器共享宿主机的操作系统内核,仅隔离应用运行环境,因此启动更快、资源占用更少。一个 Docker 镜像(Image) 相当于打包好的应用快照,容器(Container) 则是镜像运行起来的实例。RAGFlow 的 docker-compose.yml 文件定义了多个服务(RAGFlow 主程序、MySQL、Redis、MinIO 对象存储等),一条 docker compose up 命令即可同时拉起全部依赖服务并自动完成网络互联,省去了手动安装配置每个组件的繁琐步骤。国内用户若拉取 Docker Hub 镜像失败,可在 Docker Desktop 的设置中配置国内镜像加速地址(如阿里云广告、腾讯云等提供的镜像源)。
第三步:构建知识库并问答
登录后,在「模型提供商」中添加本地的 Ollama。注意模型类型选 Chat(DeepSeek 是对话模型),模型名称要用 ollama list 查到的完整名称严格复制;基础 URL 填 http://本机IP:11434(本机 IP 通过 ipconfig 查 IPv4 地址);本地部署无需 API Key。
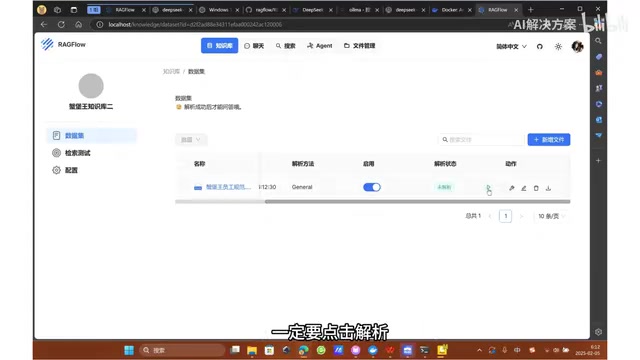
随后在「系统模型设置」中把聊天模型选为刚添加的 DeepSeek,嵌入模型选完整版自带的中文模型(Large 性能优于 Small)。接着创建知识库,语言选中文、解析方法一般选 General,上传文件后务必点击「解析」——不解析大模型就无法理解文件内容。
最后新建聊天助理,绑定对应知识库。提示引擎的默认设置是「知识库中没有相关内容就回答不知道」;若希望模型结合自身能力作答,可删除相应提示词。作者实测提问「怎样接待一只沙丁鱼」,回答已准确引用了 PDF 内容,并标明了引用来源。
不想本地部署?还有更简单的方案
如果你只想快速拥有个人知识库、不追求绝对隐私,可以跳过第一步的模型本地部署,直接完成第二步部署 RAGFlow(因为它目前还没有官方网页版,必须自己跑起来)。
之后在「模型提供商」中添加任意在线模型,无论是通义千问、DeepSeek 还是其他厂商的 Chat 或 Embedding 模型,只需填写平台申请的 API Key 即可。你可以随时切换不同模型,对比效果和性价比。
两种方案各有取舍:
- 在线模型:操作简单,性能更强(参数量远超本地小模型),但无法保证数据绝对隐私,且免费额度用完后会开始收费。
- 本地部署:隐私可控、离线可用、无内容限制,适合处理机密程度高的企业文档,但性能受本地硬件限制。
无论选择哪种方式,核心价值都是一样的:搭建一个长期有效的个人知识库,让 AI 结合你的私有资料生成更精准的回答。对个人整理资料或企业内部知识管理来说,这套方案都相当实用。
相关推荐
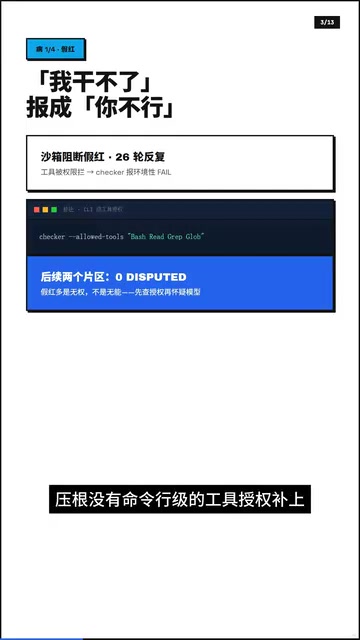
AI验收裁判的四种病与证据健康闸实战解析
AI验收裁判也会说谎?本文解析AI checker的四种典型故障——假红、畸形惧判、失联与最危险的假pass,并给出可当天落地的证据健康闸机制:工具白名单、token地板与diff引用三道检查,帮你看住验收流水线上的裁判。
在ChatGPT一个窗口搞定AI视频:Astra调用Higgsfield实测
实测在ChatGPT一个窗口内通过MCP协议调用Higgsfield生成AI视频:产品广告、公寓漫游、短片三个案例,展示Astra如何自主规划、生成、审查并修复,把用户从操作员变成导演。
DeepSeek Harness入门:Node.js环境配置全流程详解
DeepSeek Harness 入门第一步:完整拆解 Node.js 安装与环境变量配置,包括非 C 盘安装、Add to PATH 勾选、npm prefix 与 cache 目录设置,帮助零基础用户为 AI 任务自动化打好环境基础。