DeepSeek V4.1 Flash发布:全新架构性能反超旗舰
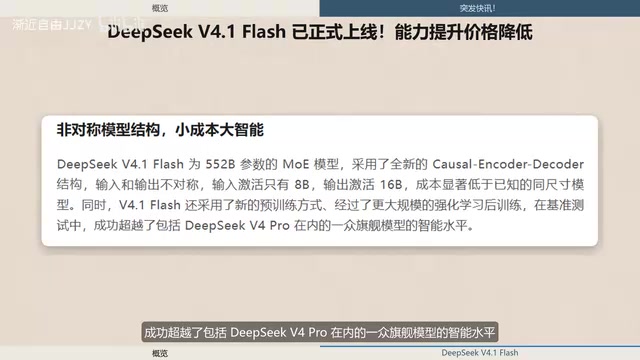
DeepSeek V4.1 Flash以MoE非对称激活架构实现性能超越Pro版、成本仅为顶级模型1.4%的突破。
DeepSeek 发布的 V4.1 Flash 是一个 552B 参数的 MoE 模型,采用输入激活 8B、输出激活 16B 的非对称 Coastal Encoder-Decoder 架构,在多项 Agentic 基准测试中超越了自家旗舰 V4 Pro 以及 GPT-5.6 和 Opus 5。工程层面,KV Cache 大幅瘦身使 HBM 需求降至四分之一、SSD 降至八分之一,为极低定价奠定硬件基础——第三方测试显示其仅用 GPT-6 Astra 1.4% 的成本即可达到接近的得分。产品端,原有三种模式合并为单一原生多模态入口,旧模型名将被路由至新版本。WorkBuddy、OpenCode 等平台已接入并提供限时折扣,进一步压低了实际调用成本。
Flash反超Pro:小模型干翻旗舰大哥
DeepSeek广告 正式上线 V4.1 Flash,官方称其在性能、速度和费用三个维度全面超越旗舰版 V4 Pro。这在过去很少见——通常带 Flash 后缀的模型定位是「轻量廉价版」,主打成本敏感场景,而这次 Flash 直接把定位更高的 Pro 版本从性能榜首拉了下来。
V4.1 Flash 是一个 552B 参数的 MoE(混合专家)模型,核心创新在于采用了全新的 Coastal Encoder-Decoder 结构,最大的特点是输入与输出激活参数不对称:输入激活仅 8B,输出激活 16B。这种设计让它在实际推理时的算力开销显著低于同尺寸模型,也是它能做到「性能高、成本低」的架构基础。
除了架构变化,V4.1 Flash 还采用了新的预训练方式,并经过更大规模的强化学习后训练。据 B 站 AI 快讯的介绍,正是这套后训练流程让它在基准测试中的智能水平超越了包括自家 V4 Pro 在内的一众旗舰模型。
MoE(Mixture of Experts,混合专家)架构是当前大模型降本增效的主流路线。与传统稠密模型每次推理都激活全部参数不同,MoE 模型将参数分散在多个"专家"子网络中,每次推理只激活其中少数几个专家。这意味着模型总参数量(如 552B)可以非常大,覆盖更广的知识与能力,但实际推理时的计算量只取决于被激活的那部分参数(如 8B 或 16B),从而大幅压低了推理成本和延迟。V4.1 Flash 将这一思路进一步推进:输入阶段仅激活 8B 参数,输出阶段激活 16B 参数,两个阶段的算力分配不对称,让模型在「读取理解」和「生成输出」时各自以最低必要的算力完成工作。
基准测试:多项指标越过 GPT-5.6 和 Opus 5
在 Agentic Benchmark(智能体基准测试)中,V4.1 Flash 与当前主流前沿模型正面对比。原始素材提到,在 Terminal Bench 2.1、DeepSWE 1.1、CyberGym、HLE、Automation Bench、Agent's Last Exam 等多个项目上,它的成绩超过了 GPT-5.6 SOAR 和 Opus 5。
这几项测试普遍偏向智能体能力、长链条任务执行和复杂推理,而非单纯的知识问答,说明 V4.1 Flash 的提升集中在「干活」而不是「背书」的能力上。对于希望用模型跑 Agent 工作流的开发者来说,这类基准的参考价值往往比通用对话榜单更高。
需要提醒的是,以上数据均来自官方发布口径,尚缺乏第三方独立复现。GPT-5.6、Opus 5 这类型号命名在素材中出现,读者应将其理解为该视频对同期竞品的称呼,实际对标关系仍需结合官方基准细则判断。
Agentic Benchmark(智能体基准测试)与传统 LLM 评测的核心区别在于:它测量的不是模型「知道什么」,而是模型「能完成什么任务」。典型的智能体测试会给模型配备工具调用、代码执行、文件操作等能力,然后布置需要多步规划、跨轮决策、错误恢复的复杂任务,例如在终端环境中调试代码(Terminal Bench)、完成软件工程任务(DeepSWE)或安全攻防演练(CyberGym)。HLE(Humanity's Last Exam)则是一个面向顶尖专家级知识的超高难度综合测试集。这类测试之所以对开发者参考价值更高,是因为现实中的 AI 应用——尤其是自动化流程和 Copilot 工具——对模型的要求恰恰是「持续完成多步骤任务」而非「一次性回答单个问题」。
KV Cache 大幅瘦身:硬件需求砍到四分之一
V4.1 Flash 另一个值得关注的工程改进是显著减小了 KV Cache 缓存的大小。相比上一代模型,它对 HBM(高带宽显存)的需求减少到四分之一,对 SSD 的需求减少到八分之一。
KV Cache 是长上下文推理时占用显存的大头,缓存越小,单卡能承载的并发和上下文长度就越高。这项优化直接决定了推理部署的边际成本——这也解释了为什么官方敢于大幅下调定价。架构层面的降本,最终转化成了 API 价格上的竞争力。
KV Cache(Key-Value Cache)是 Transformer 架构在处理长文本时的核心机制。模型在生成每个新 token 时,需要反复引用之前所有 token 对应的注意力键值(Key-Value)向量,KV Cache 就是把这些向量缓存在显存中,避免重复计算。上下文越长,KV Cache 占用的显存就越多;并发请求越多,总缓存需求呈线性增长。这使得 KV Cache 成为大规模部署时最主要的显存瓶颈,直接影响单卡可承载的最大上下文长度和并发用户数。HBM(High Bandwidth Memory,高带宽显存)是 GPU/TPU 上的片内高速显存,带宽极高但容量有限且成本昂贵;SSD 则作为二级存储在显存不足时承接溢出的 KV Cache,读写速度远低于 HBM。V4.1 Flash 将两者的需求分别压缩到原来的四分之一和八分之一,意味着相同硬件配置下可以服务更多用户或处理更长的对话,是推理侧成本下降的直接来源。
产品线合并:三种模式变一个入口
伴随新模型上线,DeepSeek 在产品侧做了一次明显的收敛。App 和网页端原本的「快速 / 专家 / 视图」三种模式,现在合并成一个原生多模态模型,一个入口同时处理日常对话、看图和复杂推理,用户不再需要手动切换或纠结选哪个模式。
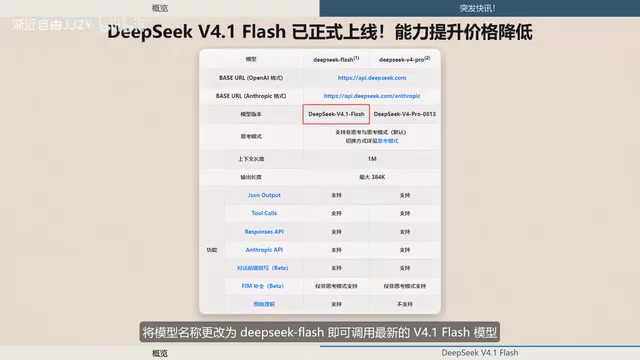
模型调用侧也有相应调整:
- V4.1 Flash 已同步上线 DeepSeek API,原生支持多模态,将模型名改为 DeepSeek Flash 即可调用最新版本;
- 旧版 V4 Flash 与 V4 Flash Vision EXP 已下线,出于兼容考虑,这两个模型名会被暂时路由到 V4.1 Flash;
- V4 Pro 延期至 9 月 14 日 12 点下线,在 V4.1 Pro 上线之前,访问 V4 Pro 的请求将全部路由到 V4.1 Flash,并按 V4.1 Flash 单价计费。
这套路由策略意味着,即便你还在用旧的模型名,实际调用到的已经是新模型,成本也按新价格结算。
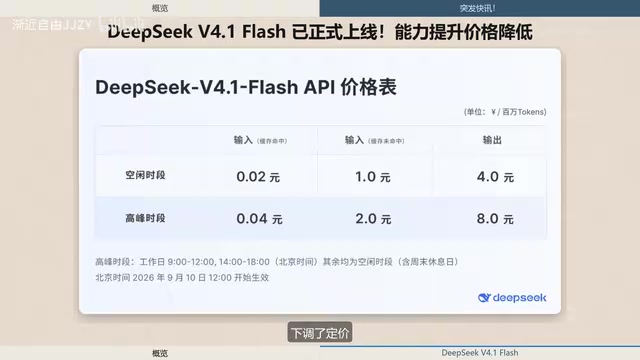
价格:架构降本带来极低定价
得益于架构创新,V4.1 Flash 的成本大幅下降,官方也随之下调了定价。不过素材提到一个细节:视觉相关的定价依然翻倍——多模态输入的处理开销仍高于纯文本。
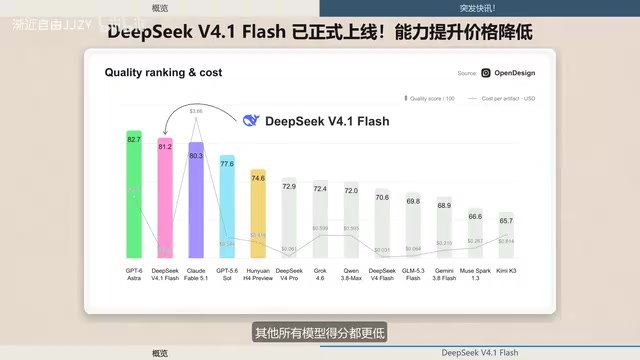
OpenDesign 对 V4.1 Flash 做了基准测试,结果颇具冲击力:在基于用户需求的日常设计任务中,V4.1 Flash 仅以 1.4% 的成本,就达到了 GPT-6 Astra 98% 的得分。除 Astra 外,其余对比模型得分更低、成本更高。换句话说,在这类实用场景里,它是在用极小的价格代价换取接近顶级模型的效果。
生态跟进:多个 Agent 平台限时优惠
WorkBuddy广告 和 OpenCode 已全量接入 V4.1 Flash。据素材信息,9 月 10 日到 9 月 23 日期间,WorkBuddy 提供独家限时优惠,倍率低至 0.03,且不设高峰时段限制。当 DeepSeek 自己降价、云厂商与通用 Agent 平台再叠加一层折扣后,实际调用价格几乎可以忽略不计。OpenCode 的 Go 套餐也已上线 Flash V4.1。
对开发者而言,模型降价 + 平台补贴的组合,短期内是低成本试用高性能模型的窗口期。不过这类超低倍率多为限时促销,长期成本仍应以官方标准定价为准来评估。
总结
V4.1 Flash 的意义不只是又一次跑分更新,而是通过 Coastal Encoder-Decoder 这类架构创新,把「高性能」和「低成本」这对通常矛盾的目标同时往前推了一步。KV Cache 大幅压缩带来的硬件需求下降,是这次降价的底层逻辑。产品线的合并也反映出厂商正在弱化模型选择的复杂度,让原生多模态成为默认体验。当前数据仍以官方口径为主,真实表现有待更多第三方验证。
相关推荐
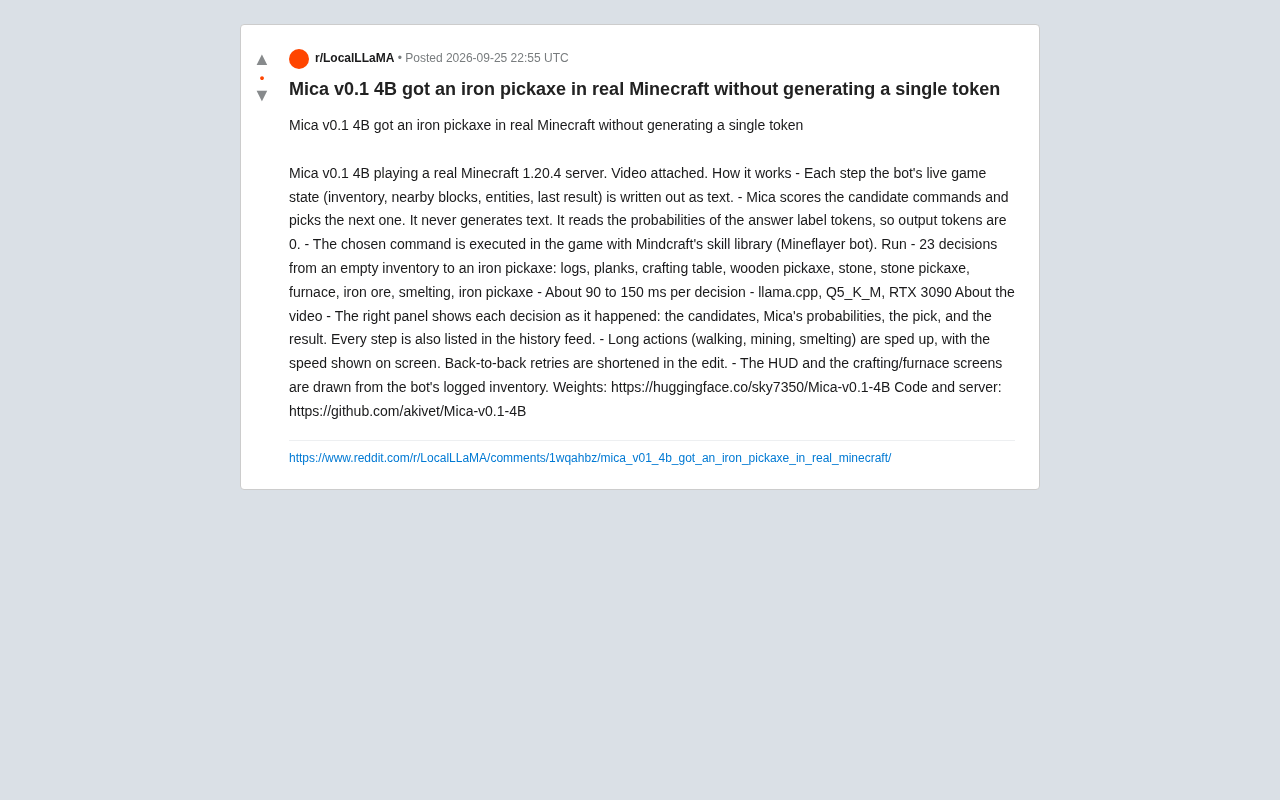
Mica v0.1 4B:不生成一个token,如何在真实Minecraft中造出铁镐
Mica v0.1 4B在真实Minecraft服务器中用23步造出铁镐,全程不生成任何文本token,而是通过读取答案标签概率进行决策。基于RTX 3090单卡实现90-150ms实时响应,模型与代码已开源。
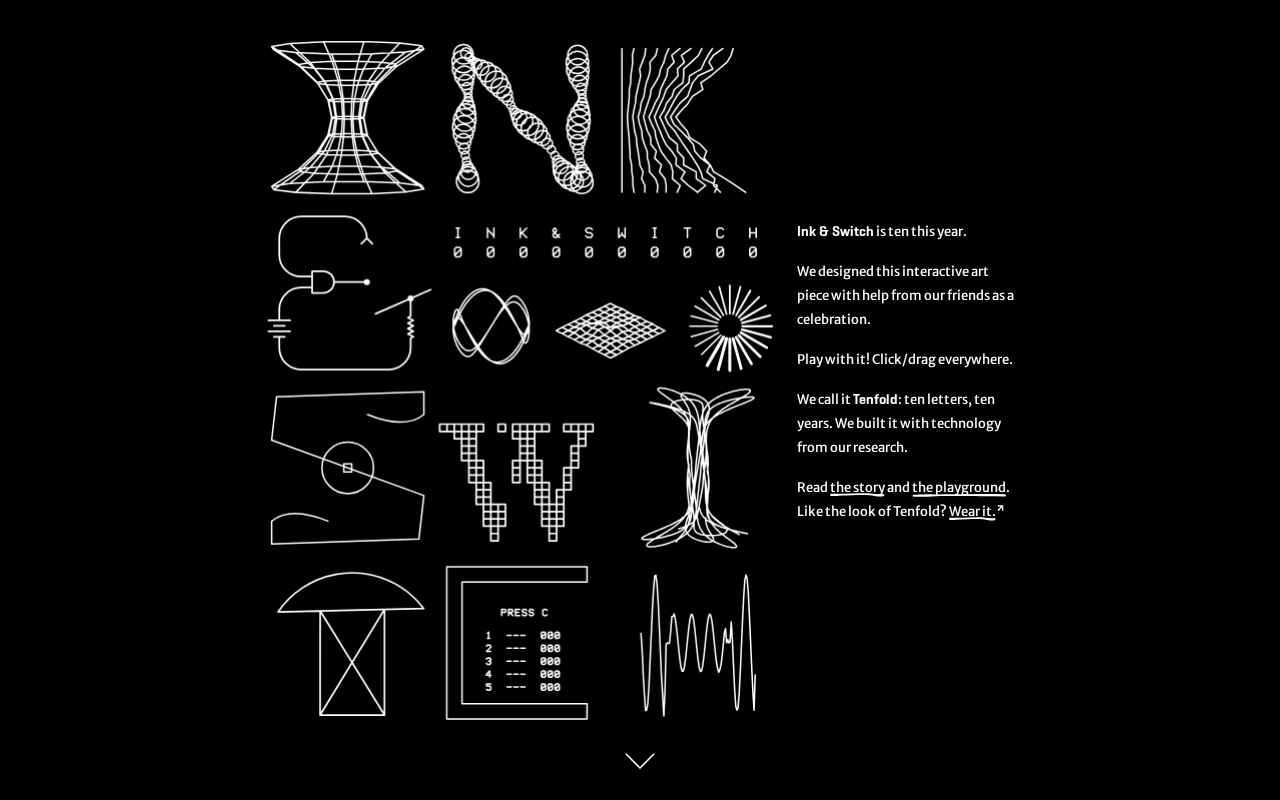
Ink & Switch 交互式主页:研究实验室的另类表达
Ink & Switch 交互式主页登上 Hacker News 热榜,本文解析这家专注本地优先软件与人机交互研究的独立实验室,如何用交互式设计传达其软件理念。
医学生问没有A*一作能否进神经外科:内卷已到荒诞地步
一名医学生询问没有A*顶刊一作论文能否匹配神经外科,引发对学术内卷外溢现象的讨论。本文分析顶刊发表为何成为跨领域硬门槛,以及量化评价体系的错配隐忧。