DeepSeek V4.1 Flash实测:视觉推理与极致效率的开源黑马
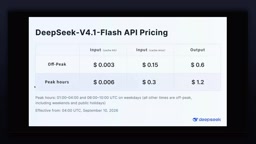
DeepSeek V4.1 Flash以337倍KV缓存效率提升和原生视觉能力,成为高性价比子智能体与视觉分析的有力选项。
DeepSeek V4.1 Flash是一次彻底的架构重设计,体积近乎翻倍但KV缓存效率相比V1提升约337倍,大幅降低长时间智能体任务的实际成本。模型新增原生视觉输入能力,配合DeepSeek官方harness的"规划—实现—视觉验证"循环,可直接"看到"自己的渲染输出并迭代改进,在3D渲染和目标检测任务上表现出色。更大的意外惊喜来自AutoML场景:模型能自主制定方案、执行特征选择,甚至无需提示便自行发现并剔除数据泄露特征,被评为首个真正擅长训练机器学习模型的开源权重模型。综合来看,它在综合能力上不及Opus 5等顶级模型,边界框精度也存在不足,但凭借极低的API价格,在视觉分析和子智能体场景下具有极强竞争力。
DeepSeek近期发布的Flash新模型引发了广泛关注。据YouTube科技创作者的实测评估,这款被称为V4.1 Flash的模型表现远超预期——它不仅在效率上做出了巨大突破,更在原生视觉能力上带来了实用性极强的新特性。本文将梳理这次实测的核心发现,帮助你判断它是否适合你的应用场景。
架构重构与效率突破
这次发布并非简单的迭代升级,而是一次彻底的架构重设计。与上一代Flash模型相比,新模型的体积几乎翻了一倍,但在效率上反而做到了大幅提升。
最引人注目的数字来自KV缓存优化:据实测博主介绍,新模型在KV缓存效率上相比V1模型提升了约337倍。这一改进对于长时间运行的智能体任务意义重大。在一个实际测试案例中,缓存命中率高达99.7%——总共生成约4000万tokens,其中近3900万tokens都命中了缓存。这意味着用户实际按缓存价格计费,而非更昂贵的非缓存输入价格。
博主明确指出定位:这是目前性价比最好的模型之一,非常适合作为子智能体(sub-agent)或本地部署使用,但他不会用它来做编排(orchestration)任务。API版本速度约为每秒300 tokens。
KV缓存(Key-Value Cache) 是大语言模型推理中的核心优化机制。在Transformer架构中,每次生成新token时,模型需要重新计算所有历史token的注意力键值对(Key-Value对)。KV缓存的作用是将已计算过的键值对存储下来,后续请求若包含相同的上下文前缀,可直接复用缓存结果,避免重复计算。对于API服务商而言,命中缓存的token计费价格通常远低于未命中的输入token,有时差距可达5-10倍。在长时间运行的智能体任务中,系统提示词(system prompt)和历史对话会随轮次累积,若每次都需全量重算,成本将急剧攀升。因此337倍的缓存效率提升并非单纯的速度指标,更直接体现为大规模部署时的成本优势。
Harness选择决定性能上限
实测中反复强调的一个关键点是:运行模型所使用的harness(运行框架)会极大影响最终表现。
博主展示了在不同harness下运行同一模型跑Terminal Bench的对比实验,结果差异惊人:分数从69.8%一直跨越到74.2%。这种差距足以说明harness选择的重要性——选错框架就会得到次优结果。这一现象其实适用于所有模型,但在这款模型上表现得尤为明显。
博主推荐使用DeepSeek官方的harness,因为它的缓存机制表现出色,且遵循"规划—实现—验证"的循环工作流。
Harness(运行框架/测试框架)在LLM评测语境中,指围绕模型构建的一套完整执行环境,包括:如何构造提示词、如何管理多轮对话历史、工具调用的编排逻辑、以及错误重试与结果解析策略。Terminal Bench是一个专门测试AI模型完成命令行任务能力的基准测试,要求模型在真实终端环境中执行文件操作、代码调试、系统管理等任务。不同harness对同一模型得分产生4个百分点以上的差异,说明"模型能力"与"模型在特定框架下的表现"并非同一回事——这也是为什么模型排行榜分数有时难以直接指导工程选型的核心原因之一。
视觉验证与3D渲染能力
新模型最大的亮点之一是获得了原生视觉输入能力,这直接改变了智能体的工作方式。
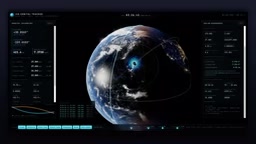
在渲染国际空间站实时位置并投射到3D地球的测试中,模型不仅准确还原了北美夜晚、亚洲白天的昼夜分布,渲染质量也相当出色。DeepSeek harness的实现逻辑是:先完成实现,再进行视觉验证——由于模型能够读取视觉输入并访问浏览器,它可以真正"看到"自己的输出并据此迭代。
博主还展示了多个3JS视觉案例:包含云层的动态天气场景、可切换时间的场景、以及一只在水中游动的海龟。相比早期DeepSeek模型在视觉设计上的短板,新模型在harness加持下的输出质量有了明显飞跃,甚至被评价为"有品味",能生成精美的1-bit风格视觉。
意外惊喜:自动训练机器学习模型
博主特别强调,这是第一个真正擅长训练机器学习模型的开源权重模型。
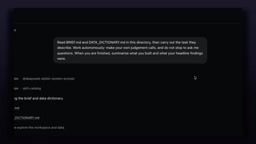
在一个AutoML测试中,博主仅提供了数据集和简短说明,要求模型"自行判断,不要询问任何问题"。模型随后自主制定方案、执行特征选择、用不同模型和超参数运行多组实验——整个过程与一名机器学习工程师的工作方式高度相似。
更值得关注的是,这个问题被博主刻意设置得含糊不清,并埋入了一处数据泄露(detail leakage)陷阱,博主并未提示。但模型自行发现了这一问题,并主动剔除了那个有问题的特征。博主表示将专门制作一期关于"LLM驱动AutoML"的深度视频。
数据泄露(Data Leakage) 是机器学习中的经典陷阱,指训练集中混入了测试集的信息,或特征中包含了本不应在预测时知晓的"未来信息",导致模型在评估时表现虚高,但在真实部署中失效。例如,若用"最终诊断结果"作为特征去预测"是否患病",模型会轻易达到接近100%的准确率,但这个特征在实际预测场景中根本不存在。能够在无提示的情况下自动识别并剔除泄露特征,要求模型不仅理解数据结构,还需具备对机器学习方法论的深层理解——这正是博主将其称为"首个真正擅长训练ML模型的开源权重模型"的核心依据。
原生目标检测与视觉推理
新模型可以原生检测图像中的物体、对它们进行推理,并在无需外部计算机视觉流水线的情况下准确计数。这对博主而言极具实用价值——不再需要单独的CV管道。
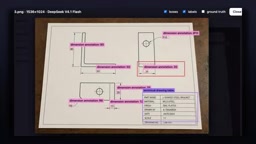
博主正在构建一个专门测试视觉语言模型的基准,直接通过API调用(不走harness)进行单次预测。测试内容包括从技术工程图纸中自动提取尺寸、识别汽车不同部件、以及对物体分类计数。
在推理能力上,一个典型例子是:博主上传一张船只图片,问"有多少艘船不是帆船,用一个整数回答",模型准确识别出4艘非帆船。不过博主也如实指出了模型的局限——数据提取本身很准确,但生成的边界框(bounding boxes)有时不够精准,达不到视频中最佳展示的水平。此外,输入的prompt本身会极大影响提取结果。
边界框(Bounding Box) 是计算机视觉中描述物体位置的标准表示方式,通常用四个坐标值(左上角和右下角的x、y坐标)标注图像中某个目标的矩形区域。传统的目标检测流水线(如YOLO、Faster R-CNN等专用CV模型)专门针对边界框精度进行优化,可达到像素级的定位准确性。视觉语言模型(VLM)在生成边界框时,本质上是将坐标作为文本token输出,其精度天然不及专用检测模型。因此,博主所指出的"边界框不够精准"是当前多模态LLM的普遍局限,而非该模型特有缺陷——这也说明在需要高精度空间定位的场景下,仍需结合专用CV模型使用。
该不该用它?
博主坦言,这期视频完全没有讨论传统benchmark分数,原因是他认为在综合能力上它不如Opus 5这类顶级模型。但他的核心观点是:并非每个应用都需要SOTA能力。
对于视觉分析场景,这是一个极其便宜且相当准确的选择,可以直接通过API使用;对于长时间运行的智能体,它作为子智能体在合适的harness下表现出色。综合价格与能力,它在特定场景下是一个非常有竞争力的选项。
需要提醒的是,本文所依据的评测来自单一YouTube来源的实测体验,部分结论(如337倍KV缓存效率、边界框精度问题)尚待更多独立验证。但从展示的实际案例来看,这款模型在效率和视觉推理方向上确实交出了令人印象深刻的答卷。
相关推荐
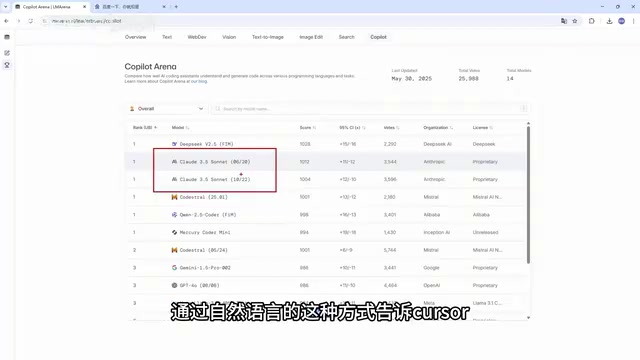
Cursor是什么?AI编程工具与传统IDE的核心区别
Cursor是什么?本文详解这款内置AI助手的编程工具,对比它与VS Code等传统IDE在代码补全、生成、重构、错误处理上的核心区别,并分析Cursor集成Claude、DeepSeek等大模型的特性及适用人群。
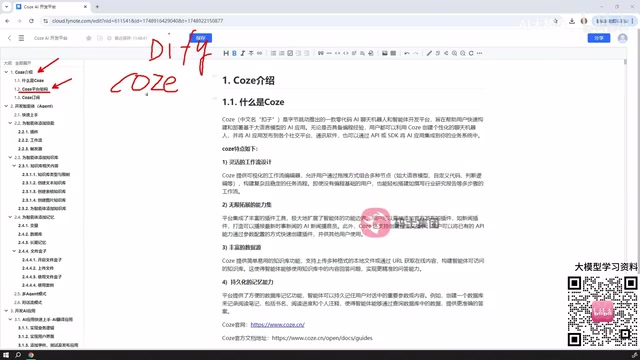
Coze扣子3.0入门指南:智能体与AI应用全景解析
Coze扣子3.0入门教程:解析字节跳动AI开发平台的智能体、AI应用、工作流与插件体系,涵盖单Agent与多Agent协作,并对比Coze与Dify的差异,帮助零基础用户快速搭建AI智能体。
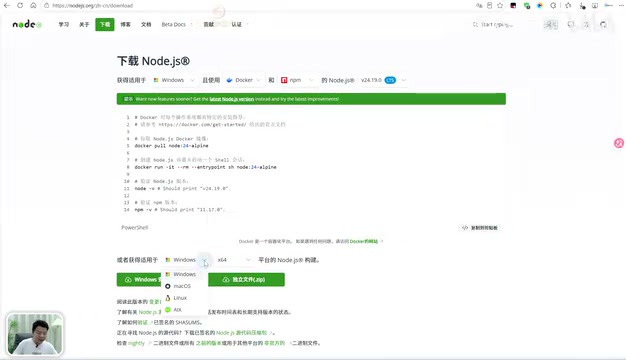
DeepSeek Harness 环境搭建:Node.js 安装与配置全流程
零基础搭建 DeepSeek Harness 运行环境的完整教程,涵盖 Node.js 安装、Add to PATH 勾选、npm 全局目录与缓存目录迁移,以及系统环境变量配置全流程,附常见踩坑提示。