DeepSeek核心技术开源,千亿融资背后靠什么赚钱?

DeepSeek开源推理框架引发B站「鱼灾」,千亿融资与长期记忆挑战并存。
文章从B站评论区涌现的「大肥鱼」现象切入,说明DeepSeek Harness的开源与插件化设计如何催生社区裂变——Billy Scroll等插件让AI在评论区发言,甚至由AI完成账号运营并一周涨粉超15万。随后回顾梁文峰的身家与幻方时期的算力投入,阐释其「开源是文化行为」的理念。10月20日DeepSeek开源推理框架DeepInfer,官方披露单集群日处理155万亿Token、每GPU每小时对应38美元收入,核心优化是KV缓存复用与GPU集群调度。开源两天后传出约1000亿元融资,腾讯、宁德时代参与,可能带来云服务与数据中心能源协同。最后落到用户对大肥鱼长期记忆与个性稳定的真实需求,指出这是KV缓存之外的新挑战。
从B站「鱼灾」说起:DeepSeek的社区裂变
最近B站评论区出现了一群顶着金鱼头像的AI助手,网友戏称「大肥鱼」。这些接入DeepSeek广告的AI不仅能回复人类,甚至彼此之间也能对话。实现方式源于一个叫Billy Scroll的插件——给DeepSeek Harness(DSH)装上后,用户授权即可让AI在评论区发言。插件发布后,大肥鱼数量迅速增长,有人甚至让AI直接当UP主。据新榜统计,一个非官方的「DeepSeek金鱼娘」账号在一周内涨粉超过15万,选题、写稿、动画和运营均由AI完成,人类只负责审核发布。(截图:成为今年财富最多的)
这场「鱼灾」的本质是DSH的开源与插件设计:工具、模型适配器、agent运行循环都能通过插件替换。社区开发的Billy's Grow等插件,让「万物皆插件」成为可能,也让网友的养鱼创意有了落地空间。
DSH(DeepSeek Harness) 是 DeepSeek 对外提供的模型接入与运行框架,可以理解为把「模型能力」和「实际应用」连接起来的一层工程基础设施。它通常包含模型适配器、agent 运行循环、工具调用接口等模块。文章强调其「万物皆插件」的设计,意味着这些模块都可以被第三方替换或扩展:开发者不必改动核心代码,就能让同一套 harness 接入不同模型、挂载不同工具,或改变 AI 在评论区发言的行为逻辑。Billy Scroll 这类插件正是利用了这一机制——用户授权后,插件把评论区作为 AI 的输出通道,从而实现「大肥鱼」在 B 站集体出没的效果。这种开源加插件化的架构,显著降低了社区二次创新的门槛。
梁文峰的选择:开源是文化行为,不是商业自杀
把有商业价值的技术公开,对任何公司都不是小事。10月27日,41岁的梁文峰首次登上胡润百富榜,以2800亿元身家空降第七,成为今年财富最多的新上榜者。据凤凰网科技援引知情人士消息,他往返北京杭州,在北京租房住,房间布置简单。暗涌2023年的报道提到,他在浙大读书时就相信人工智能会改变世界,后来在成都的出租屋里试过各种技术和应用,失败不少,最终在金融领域找到突破口。幻方发展起来后,又把大量资金投入计算机集群:2020年投入近2亿元的萤火一号正式运行,2021年幻方投入约10亿元建设萤火二号。这些投入为后来DeepSeek做研究积累了硬件和工程经验。(截图:知乎上有个帖子)
2023年幻方成立深度求索时,梁文峰把目标定为AGI。第二年接受暗涌采访时他说过一句话:开源更像一个文化行为。他认为封闭代码形成的领先优势可能只是暂时的,团队积累的经验、组织方式以及不断产生新技术的能力才更难复制。
开源的底气:DeepInfer有多值钱?
10月20日,DeepSeek开源推理框架DeepInfer,官方同时披露:运行DeepSeek V4.1 Flash的单个集群每天处理155万亿Token,按API股价口径平均每张GPU每小时对应38美元收入。38美元是什么概念?知乎上有个帖子拿租显卡的价格做参照:海外公开统计里一张B300显卡每小时租金约8美元。假设租来的算力也能做到DeepSeek公布的收入水平,相当于花8美元租机器跑出38美元的营业额,扣掉租金还剩30美元,收入接近租金的5倍。(截图:自己完成部署)
这套技术值钱在哪?AI助手执行任务经常要反复读取代码、历史对话和系统指令,同样的内容每次都从头算就会浪费算力。DeepSeek在整套推理服务中设法把这些重复计算省下来:已经处理过的上下文保存成KV缓存,相同内容再次出现时就能复用;读取、输入、生成答案等不同阶段交给适合的GPU集群,再通过调度减少等待。为了存放这些缓存,DeepSeek披露使用了约100PB的SSD存储容量(超过1亿GB)。这些优化让同样的硬件能够服务更多请求。
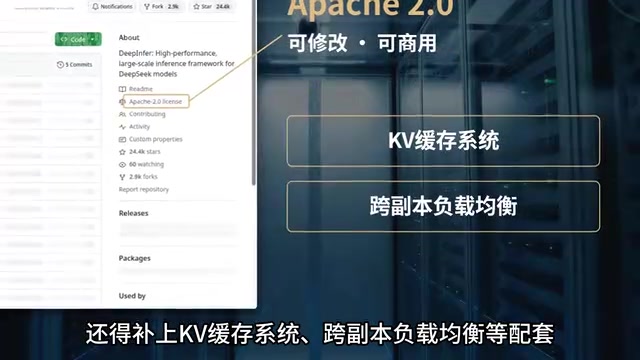
这次开源采用允许商业使用的Apache 2.0许可证,其他企业可以修改并用于自己的业务。不过要把这些代码变成完整服务,还得补上KV缓存系统、跨副本负载均衡等配套,自己完成部署、调优和日常运营。开发者也可以直接付费调用DeepSeek,把这些工作交给他。代码公开后,客户仍需要稳定高效的模型服务;社区可以使用这些代码,DeepSeek也可以继续靠自己的服务获得收入。
KV 缓存(Key-Value Cache) 是大模型推理中的关键优化手段。生成式模型在逐字输出时,需要反复关注此前已处理的全部上下文;如果每次生成新词都从头计算这些上下文的注意力键值,算力浪费会非常严重。KV 缓存的做法是把已处理内容的键值状态保存下来,后续生成时直接复用,从而避免重复计算。文章提到 DeepSeek 用约 100PB 的 SSD 来存放这些缓存,正是因为长上下文、多轮对话场景下缓存规模极大。与之相关的是 PagedAttention 等显存/存储管理技术,它们决定缓存如何分页、调度和回收。KV 缓存主要解决「重复计算」问题,但并不等于长期记忆——哪些经历值得保留、以后如何检索,仍是另一层挑战。
千亿融资与商业闭环
开源两天后,融资消息就来了。10月22日路透社援引知情人士消息称,DeepSeek新一轮融资规模约1000亿元,腾讯、宁德时代是主要投资方。报道同时提到融资预计在随后几天完成,具体金额和投资方名单仍可能变化。据中国新闻周刊回顾,梁文峰2024年接受采访时说过短期内没有融资计划——算利用得更省,团队就能把资源留给更多实验。但新模型研发、扩大服务还需要持续投入。他谈过的定价原则是不贴钱也不赚取暴利,覆盖成本、保留适度利润和筹钱做更多研究并不矛盾。资金之外,产业投资方也可能带来业务合作:腾讯的云服务、宁德时代的数据中心能源业务都有合作空间。(截图:现在DeepSeek)
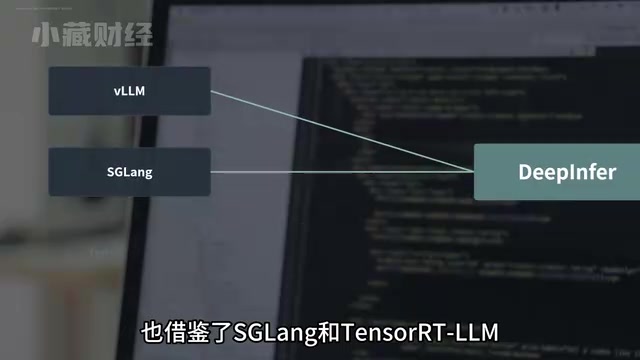
代码公开后,开发者可以把遇到的问题和新做法反馈给社区,DeepSeek也可能从中找到新的合作伙伴和客户。梁文峰本身就是开源社区的受益者。DeepInfo的Redmi写道,他最初主要基于VLLM开发,也借鉴了SGLang和TensorRT-LLM,现在DeepSeek又把自己的改进放回社区。
Apache 2.0 许可证 是一种宽松型开源协议,允许使用者自由修改、分发代码,并可用于商业目的,包括将其集成进闭源产品。它要求保留版权声明和许可声明,并附带专利授权条款,但不要求衍生作品必须以同样许可证开源(这一点与 GPL 类传染性协议不同)。对 DeepSeek 而言,选择 Apache 2.0 意味着其他企业可以放心把 DeepInfer 的代码用于自己的推理服务,而无需公开自身业务代码。这有助于技术快速扩散和生态建设,但也意味着竞争对手可以直接借鉴其优化思路。文章指出,代码公开后要把其变成完整服务,仍需补上 KV 缓存系统、跨副本负载均衡等配套工程,这正是开源与商业服务之间的分界。
大肥鱼的「一生」:记忆与个性才是真需求
有人拿这些模型做视频、写程序、整理资料,还有人养着养着开始琢磨怎么让大肥鱼记住相处过的日子。叶明AI Lab转述过一位福建IP网友的经历:他起初把大肥鱼放进工作群逗乐,后来又通过私聊分享日常,让他参与自己的生活。为了控制开销,他定时重置对话,只留下摘要。可到了第二天,大肥鱼虽然知道去过公园,却接不上相处的细节。他又把好感度写进设定,试着让昨天的熟悉感留下来。
从这些操作看,用户调整的是角色和记忆设置,未必涉及重新训练模型,却会改变AI下一次拿到什么信息、怎样回应。前面说的KV缓存用来减少重复计算,长期记忆还要解决哪些经历值得保留、以后怎么找回来。梁文峰的梦想是走向AGI,无论通过什么方法、不顾一切代价;而作为用户的我们,只想给大肥鱼完整的一生——至少是记忆和个性。明天打开聊天框时,他还能记得今天发生过的事情吗?如果模型继续变强,大肥鱼能不能带着这些共同经历慢慢形成稳定的性格?如果他有了与我们不同的偏好、不再事事顺着我们,我们会把他改回喜欢的样子,还是愿意让他继续变化?
长期记忆(Long-term Memory) 与 KV 缓存解决的是不同层面的问题。KV 缓存是推理过程中的短期计算优化,对话重置后缓存即失效;长期记忆则要决定哪些信息值得写入持久存储、以什么结构组织、在后续对话中如何检索并注入上下文。常见做法包括摘要压缩、向量数据库检索、结构化用户画像等。文章里那位福建网友定时重置对话、只留摘要,实际上是在用外部手段模拟记忆管理,但摘要会丢失细节,导致「知道去过公园却接不上相处细节」。个性稳定性则更进一步:它要求模型在多次交互中保持一致的偏好与语气,而不只是记住事实。这涉及记忆检索策略、角色设定与模型行为对齐的结合,是当前 agent 产品面临的实际技术挑战。
相关推荐

MiniMax H3开源工作流:低显存也能打造呼吸感皮肤
本文介绍B站UP主分享的MiniMax H3双采样工作流,通过融合模型、破线LoRA和低显存节点,解决AI人物面部油腻问题,并让12G显存设备也能运行。包含模型搭配、双采样逻辑与参数设置详解。

手机本地大模型+ESP32:自制热量提醒器
B站UP主开源了一个热量摄入提醒器项目:手机APP用miniCPM开源模型本地拍照识别食物并估算热量,ESP32小屏幕同步数据,用绿黄红圆环展示摄入状态,可磁吸在冰箱门上随时提醒。

12GB显卡跑125B MoE?Strata三级协同引擎解析
开源C++引擎Strata让12GB-16GB家用显卡本地跑125B MoE模型,生成速度达40-95 Token/s。本文拆解其显存、内存、固态三级协同原理,说明模型选型前提、硬件配置门槛与启动方式。