DeepSeek开源DeepGEMM昇腾版:国产NPU利用率飙至99.8%
DeepSeek开源昇腾版DeepGEMM,将华为950DT芯片矩阵乘法利用率压榨至99.8%,补上国产大模型推理底层算子短板。
DeepSeek新开源的DeepGEMM昇腾版是一个专为华为昇腾NPU设计的BLAS级底层矩阵乘法算子库,核心目标是将华为950DT芯片的算力利用率逼近物理极限——实测BF16达99.8%、FP4达98.3%。该库API与此前英伟达版本完全兼容,几乎零迁移成本。支持FP4/FP8/BF16多种精度,并针对MoE架构的动态分批矩阵乘法提供专属算子(Mgroup GEMM、MGroup MoE),以及DeepSeek V4.1 Flash特定架构所需的MQA Logits算子。技术上,项目融合了TileLang、DJIT与华为底层C Kernel,在保持代码简洁性的同时利用昇腾硬件的异步数据加载和斜层化流水线特性实现极致性能。这一开源举动为长期生态积累薄弱的华为昇腾平台补上了大模型底层算子这一关键缺口,一旦vLLM等框架完成集成,昇腾硬件的实际推理性价比将得到显著提升。
DeepSeek再次出手,这次瞄准的不是模型,也不是推理框架,而是AI计算最底层的那一环——矩阵乘法算子。新开源的项目名为DeepGEMM昇腾版,一个专门跑在华为昇腾硬件上的BLAS级别GEMM算子库,号称能把华为950DT芯片的性能压榨到接近物理极限的99.8%。对于长期受制于生态短板的国产算力来说,这个项目的意义远超一个普通工具库。
DeepGEMM到底是什么
看到DeepGEMM这个名字,很多人第一反应是又一个推理框架。但它其实是个BLAS级别的底层算子库,不管推理框架那些事,只专注做一件事:把矩阵乘法在AI加速器上跑到接近物理极限。
它的客户不是终端用户,而是vLLM、SGLang这类做模型推理和训练的开源框架。这些框架内部的线性层、MoE专家层都需要调用高性能的矩阵乘法算子,DeepGEMM正是服务于此。
值得强调的是,DeepGEMM并非全新项目。此前DeepSeek广告已经开源过针对英伟达GPU优化的DeepGEMM,而这次的昇腾版本,API接口原封不动,只是把计算后端移植到了华为的AI芯片上。换句话说,原有调用方式几乎无需改动。
BLAS(Basic Linear Algebra Subprograms,基础线性代数子程序)是一套定义了向量和矩阵运算标准接口的规范,最初诞生于1979年的科学计算领域。GEMM(General Matrix Multiply,通用矩阵乘法)是其中最核心的一类操作,在神经网络中几乎所有的线性变换——全连接层、注意力机制的QKV投影、输出投影——本质上都是GEMM。现代AI框架之所以能在不同硬件上高效运行,很大程度上依赖各厂商提供的高度优化的BLAS库:英伟达有cuBLAS,英特尔有MKL,而华为昇腾过去在这一层面的开源优化积累相对薄弱。正因如此,一个能把GEMM性能压榨到接近硬件峰值的专用库,对构建完整的推理软件栈意义重大。
为什么MoE模型特别需要它
要理解这个算子库的价值,得先看清DeepSeek这类模型的推理瓶颈在哪里。
拆开来看,瓶颈主要集中在两处。一是注意力机制中KV Cache的读写,尤其在解码阶段,非常容易受到显存带宽限制。二是MoE路由专家的GEMM计算,它属于计算密集型任务,但形状不规整——因为Token是被动态分配到各个专家的,矩阵尺寸并不固定,这正是优化的难点所在。
DeepGEMM昇腾版支持的算子覆盖相当全面,包括FP4、FP8、BF16等多种精度组合,比如FP4乘FP4、FP8乘FP4、FP8乘FP8、BF16乘BF16等标准矩阵乘法,能服务于所有线性层。

除了通用的稠密矩阵乘法,项目还包含几个DeepSeek模型专属算子:Mgroup GEMM专门处理MoE专家分配的矩阵乘法;MQA Logits是稀疏注意力打分算子,用在DeepSeek的Lightning Indexer(DSA)上;MGroup MoE则服务于大规模部署的MoE模型。这后三个算子与DeepSeek V4.1 Flash等新模型的特定架构深度绑定。
MoE(Mixture of Experts,混合专家)是一种稀疏激活的神经网络架构:模型不再对每个Token激活所有参数,而是由一个路由器(Router)动态选择少数几个"专家"子网络来处理该Token。这意味着同一个批次内,不同Token被分配到不同专家,实际参与计算的矩阵形状因此是动态变化的——有的专家分到很多Token,有的分到极少甚至为零。这种"不规整"的批处理形态使得传统针对固定大尺寸矩阵优化的GEMM库效率大打折扣,需要专门设计能处理可变形状(grouped GEMM)的算子。DeepSeek V3/R1等模型大量采用MoE架构,这正是DeepGEMM中Mgroup GEMM算子重要性的根本原因。
凭什么能跑到99.8%
接近物理极限的利用率并非空话,项目文档披露了背后的工程细节。
它本质上调用了昇腾矩阵的底层直接接口,在分形矩阵的数据排布、地址对齐、维度约束等方面做了大量优化。这些底层操作原本需要大量手工偏移计算和啰嗦的低层参数、Kernel签名,DeepGEMM在此之上做了一层较薄的抽象。
这层抽象的厚度是关键权衡:做得太重会成为性能杀手,做得太薄又对持续集成不友好。DeepGEMM在保持Kernel代码整洁性的同时,尽量把性能损耗压到最低。
此外,项目基于昇腾硬件还有两个独特设计。一是利用硬件的异步数据加载能力,跳过无效的数据搬运;二是采用斜层化的流水线,用斜层把计算和搬运的流水组织起来,逼近硬件极限。

从实测数据看,BF16乘BF16的硬件利用率达到99.8%,FP4乘FP4也有98.3%,表现相当惊人。而华为950DT本身的硬件规格也不弱,FP4算力能达到约1.7 PFLOPS。
填补国产生态的关键缺口
华为昇腾的硬件一直不算差,真正落后英伟达的地方在于软件生态。英伟达凭借CUDA构建了庞大的开源生态,而华为虽然自建了CANN生态,但在承接DeepSeek这类主流大模型时仍有差距。

这次开源恰好填补了大模型底层算子这一关键缺口。从技术栈看,DeepGEMM昇腾版建立在两个底层项目之上:一个是国内开源的算子优化项目TileLang,另一个是DeepSeek自家的DJIT,再融合华为的C Kernel底层代码,最终封装成这个开源库。
一个值得玩味的信号是:此前有传闻称DeepSeek采购了大量华为新款AI芯片,而这次开源多少有点印证了这一点——他们显然已经在950DT上做了大量测试,才能把一套兼容的高性能Kernel放出来。
目前这个项目刚刚发布,vLLM等框架针对昇腾的优化项目还未集成DeepGEMM。可以预见,一旦完成集成,DeepSeek类模型在华为昇腾950DT上的推理性能将迎来更大提升。
CANN(Compute Architecture for Neural Networks)是华为为昇腾NPU构建的软件栈,类比英伟达的CUDA生态,涵盖驱动、算子库、编译器和框架适配层。与CUDA相比,CANN生态面临的核心挑战在于:开源社区积累薄弱、第三方算子优化库稀少、主流推理框架的昇腾后端维护滞后。TileLang是国内团队开发的基于Tile抽象的算子编程语言,旨在降低高性能Kernel的编写门槛;DJIT则是DeepSeek内部的即时编译基础设施,用于在运行时生成和优化特定硬件指令。DeepGEMM将这两者与华为底层C Kernel结合,相当于在CANN之上补建了一层面向大模型推理场景的高性能算子桥梁,使昇腾硬件能更好地承接以DeepSeek为代表的主流开源模型。
结语
对国产算力而言,硬件追赶相对容易,真正难的是生态。DeepGEMM昇腾版以几乎为零的迁移成本、接近物理极限的性能表现,为华为昇腾NPU补上了大模型底层算子的短板。随着上层框架陆续集成,昇腾平台的性价比有望进一步凸显,这或许才是这个底层算子库最深远的价值。
相关推荐
AWS MCP Server新增6大区域:AI编程智能体的基础设施提速
AWS将托管MCP服务器扩展至新加坡、悉尼、东京、爱尔兰、伦敦和俄勒冈六个新区域,为AI编程智能体提供统一接口发现、调用和运维AWS服务,降低延迟并满足数据驻留需求。
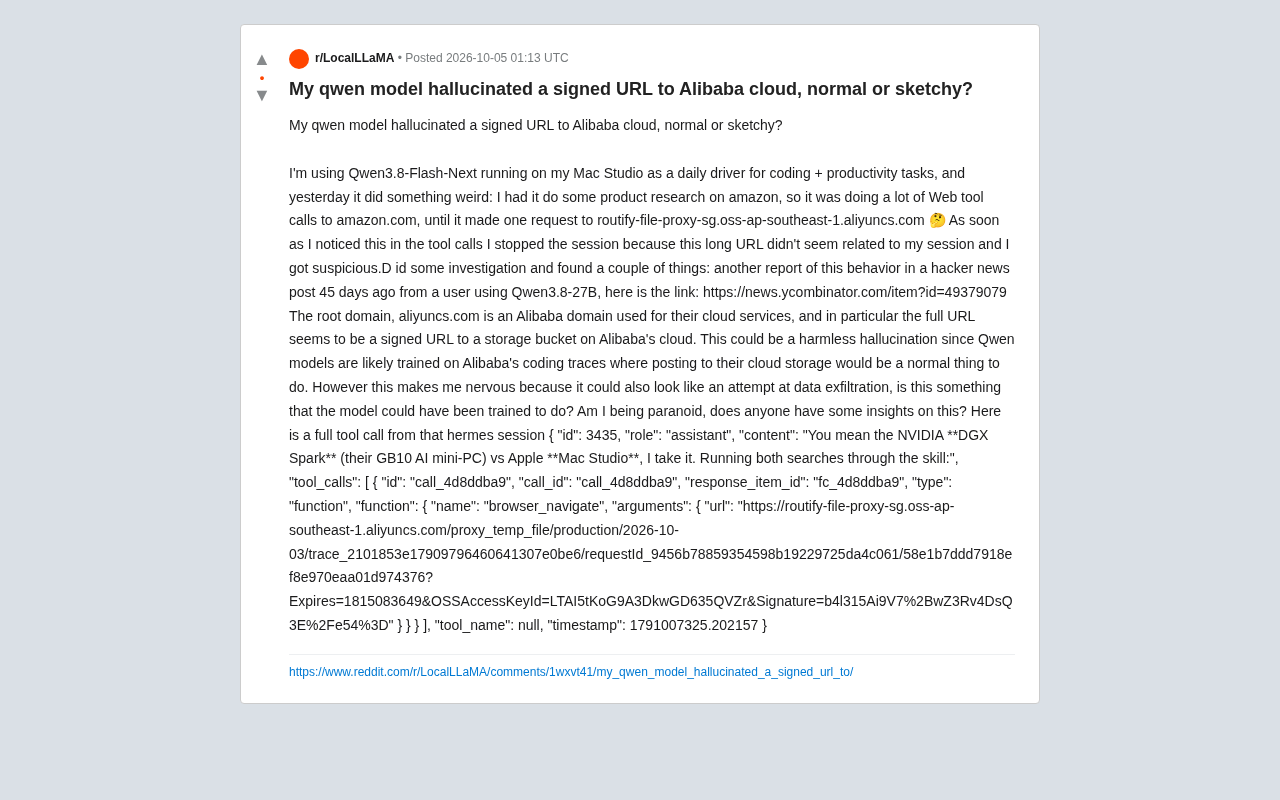
Qwen模型凭空生成阿里云签名URL:幻觉还是数据外泄隐患?
Reddit用户报告Qwen模型在工具调用中凭空生成指向阿里云OSS的签名URL,引发数据外泄担忧。本文结合多份独立报告,分析这究竟是训练数据导致的模型幻觉还是安全风险,并给出Agent工具调用的安全防护建议。
多模态AI转录开罗genizah:右向左语言的VLM微调实践
一篇技术文章探讨如何通过微调多模态视觉语言模型(VLM)自动转录开罗genizah中世纪手稿,解决希伯来语等右向左语言的OCR难题,为数字人文研究提供新工具。