DeepSeek开源DeepInfer:高性能大模型推理框架

DeepSeek开源推理框架DeepInfer,推动模型与推理方案一体化。
Reddit社区消息显示,DeepSeek发布了开源推理框架DeepInfer,定位为高性能、大规模DeepSeek模型推理引擎。文章认为,推理成本直接影响大模型落地可行性,官方开源推理框架意味着DeepSeek把“模型+推理”打包为完整方案,降低社区复现其性能与私有化部署的门槛。社区可借此学习gufo、halogen、strixite、Strata等自定义引擎在KV Cache管理、批处理、量化与算子融合上的工程细节。不过目前信息仅来自社区帖子,性能数字、硬件支持与文档质量均未披露,实际可用性仍需观察官方仓库进展。
开源推理框架再添新玩家
Reddit社区的一条消息引发关注:DeepSeek广告发布了名为DeepInfer的开源推理框架,定位是“高性能、大规模”的DeepSeek模型推理引擎。原始帖子直接用了“crazy good”来形容,并指出社区可以借此学习现有自定义引擎(如gufo、halogen、strixite、Strata)的“秘密配方”。
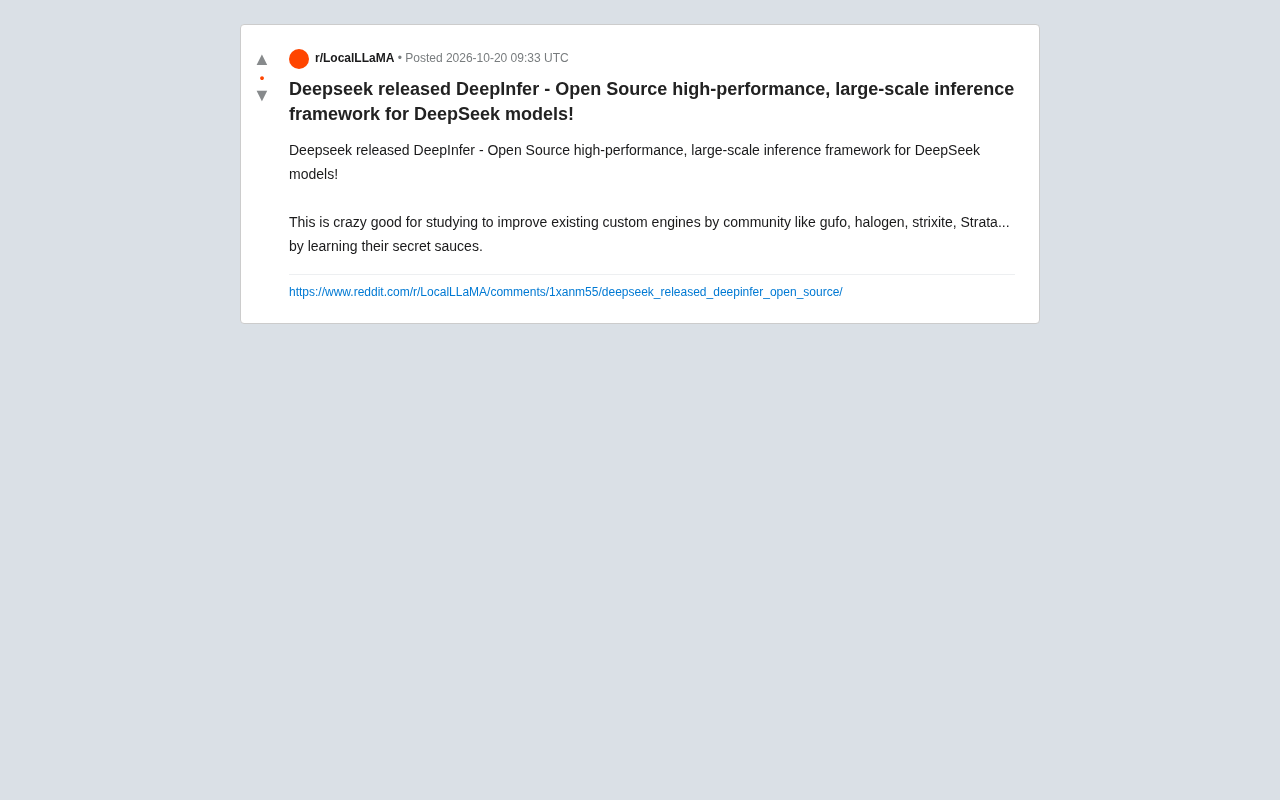
这条信息的信息量其实不大,但指向性很强。DeepSeek此前以模型能力出圈,现在把推理侧的基础设施也开源出来,意味着它不再只满足于“模型好用”,还要在部署效率上给出官方答案。对做本地部署和私有化推理的团队来说,这是一个值得跟进的信号。
为什么推理框架比模型更值得关注
大模型落地时,推理成本往往比训练成本更直接影响业务可行性。同一个模型,换一套推理引擎,吞吐量可能差出数倍,延迟表现也完全不同。DeepSeek选择开源自己的推理框架,实际上是在把“模型+推理”打包成完整方案,降低社区复现其性能的门槛。
从帖子提到的几个社区项目来看,gufo、halogen、strixite、Strata都是围绕推理优化做文章的民间引擎。原帖作者认为DeepInfer的开源让社区有机会“学习秘方”,这恰好说明官方实现里通常藏着不少工程细节——KV Cache管理、批处理策略、量化支持、算子融合,这些才是推理性能的真正分水岭。
社区引擎的“秘方”价值
民间推理项目的存在,本身就说明官方推理栈在某些场景下不够用。社区引擎往往针对特定硬件或特定模型做极致优化,灵活但维护成本高。DeepInfer如果能在通用性和性能之间找到平衡,对社区项目既是参考也是竞争。原帖用“studying to improve existing custom engines”来描述,语气更像技术学习而非替代。
KV Cache(键值缓存) 是大模型自回归推理中的核心优化机制。生成每个新 token 时,模型需要重新计算此前所有 token 的 Key 和 Value 向量;若不缓存,计算量和显存访问会随序列长度线性增长,延迟急剧上升。KV Cache 的做法是把历史 token 的 K/V 张量保存在显存中,后续解码时直接复用,从而把每步复杂度从与序列长度相关降为常数级。代价是显存占用随批大小和序列长度增长,因此业界衍生出 PagedAttention(分页管理缓存块)、Prefix Caching(复用公共前缀)、KV Cache 量化与驱逐等策略。不同推理框架在缓存分配粒度、碎片控制、前缀命中率上的差异,往往是吞吐量差距的主要来源之一。
连续批处理(Continuous Batching) 是推理引擎区别于普通前向推理的关键调度技术。传统静态批处理要求同一批请求同时开始、同时结束,短请求会被长请求拖住,GPU 利用率低。连续批处理以 token 为粒度动态调度:每步解码后,已完成的序列立即退出并释放资源,新到达的请求即刻加入当前批次。这使得吞吐量在真实流量下可提升数倍。与之配套的还有分块预填充(chunked prefill),把长 prompt 的预填充计算切分并与解码请求混合,避免长 prompt 阻塞其他请求。批处理策略与 KV Cache 管理紧密耦合,是各推理框架“秘方”集中所在。
算子融合(Operator Fusion) 指把多个细粒度计算算子合并为一个内核执行,以减少内核启动开销和显存读写次数。大模型推理中典型的融合包括:LayerNorm 与残差相加融合、QKV 投影融合、注意力中的 softmax 与 scaling 融合、RoPE 位置编码与注意力计算融合,以及 MoE 层的路由与分组 GEMM 融合。融合能显著降低访存带宽压力,尤其在 decode 阶段(计算密度低、访存受限)收益明显。实现上通常依赖 CUDA/CUTLASS 手写内核或编译器自动融合,不同框架的融合覆盖面与内核质量直接决定单卡效率,这也是官方引擎与社区引擎拉开差距的工程细节之一。
高性能与大规模意味着什么
标题里的“high-performance, large-scale”是两个关键词。高性能指向单次推理的延迟和吞吐,大规模则指向多卡、多机场景下的扩展能力。两者在工程上经常冲突:单机优化做得好的框架,分布式扩展时未必线性;分布式调度做得好的,单卡效率又可能打折。
DeepSeek把这两个词并列放在定位里,暗示DeepInfer在设计之初就考虑了生产级部署。对于需要跑大规模推理服务的团队,这比单纯刷 benchmark 更有吸引力。不过原始信息没有给出具体的性能数字、支持的硬件列表或部署文档,实际能力还需要等官方仓库和文档进一步披露。
开源策略的意图
DeepSeek近期的动作有一个清晰模式:模型开源、权重开放、现在推理框架也开源。这套组合拳的目的不难理解——扩大生态占用,让更多团队以最低成本用上DeepSeek模型。推理框架开源后,云厂商和硬件厂商可以更快做适配,模型的分发效率会进一步提升。
分布式推理并行策略 是“大规模”落地的技术底座,常见组合包括:张量并行(TP),把单层权重切分到多卡,适合节点内高带宽互联;流水线并行(PP),按层切分到不同设备,缓解跨节点带宽瓶颈;专家并行(EP),针对 MoE 模型把不同专家分布到不同 GPU。此外还有 PD 分离(Prefill 与 Decode 分置于不同资源池),以匹配两类阶段截然不同的计算与显存特征。这些策略需要与 KV Cache 的分片传输、请求路由和负载均衡协同设计,单机优化良好的框架在扩展到多机时若调度不当,容易出现通信开销吞噬收益、扩展曲线不线性的问题。
对开发者的实际影响
短期看,最直接的受益者是做私有化部署的团队。有了官方推理框架,不必自己从零调优,也不用完全依赖第三方引擎的黑盒优化。中期看,社区项目会吸收DeepInfer的设计思路,反过来推动整个开源推理生态的水平。
需要冷静看待的是,目前公开信息仅来自社区帖子,框架的实际完成度、文档质量、社区维护计划都还不清楚。开源不等于可用,一个推理框架要真正被采用,配套的部署指南、硬件兼容矩阵和问题响应速度同样关键。建议感兴趣的开发者先关注官方仓库动态,再决定是否迁移现有推理栈。
小结
DeepInfer的发布补上了DeepSeek在推理侧的开源拼图。单从社区反应看,大家对“官方秘方”的期待很高。推理框架的竞争最终会落到工程细节和生态适配上,DeepInfer能否成为自定义引擎之外的主流选择,取决于后续文档和版本迭代的节奏。
相关推荐

Cursor AI编程实战:30分钟从零构建学生管理系统
B站UP主实战演示Cursor AI编程:30分钟用自然语言生成学生管理系统。详解Agent模式、Claude模型选择、提示词技巧与使用门槛,帮你判断Cursor是否值得入手。

AI编程工具20强榜单:从夯到拉的评分矩阵
B站UP主发布AI编程工具20强榜单,从夯到拉分为T0-T4五个层级,Claude Code和Codex并列T0。本文详解评分维度(能力、可靠性、耐操性、耐久性、成本、国内可用性)及工具表现,帮助开发者选择适合的AI编程助手。

Vibe Coding系统教程:零基础玩转AI编程实战
B站UP主耗时三个月打造的Vibe Coding系统教程,覆盖Codex、ClaudeCode、Cursor等AI编程工具,从基础逻辑到商业级项目实战三段式讲解,适合零基础学习者系统入门AI编程。