DeepSeek开源推理框架DeepInfer,本地大模型部署效率革命

DeepSeek开源推理框架DeepInfer,标志本地AI竞争转向软硬协同优化。
DeepSeek开源内部推理框架DeepInfer,将本地AI的关注点从"模型能否跑起来"转向"跑得快不快、算力省不省"。DeepInfer集成了推测解码、MoE专家变形与异步调度、高性能算子等技术,减少逐 Token 生成的串行等待并提升硬件利用率,同时持续优化长上下文场景下的 KV Cache 与计算开销。实测分享显示,在 128G 统一内存平台上,30B 级模型代码任务单流可达 100 TPS 以上,DeepSeek V4.1 Flash 1017 本地部署最高 66 Token/s,但数据来源单一、条件特定,不宜外推。文章认为本地AI的竞争正从模型能力单点比拼转向硬件与推理软件的协同优化。
DeepSeek 开源了内部推理框架 DeepInfer,这件事在本地 AI 社区引起了不小的讨论。过去大家评估本地部署可行性时,目光几乎都集中在模型参数量、显存大小、能否跑起来这几个硬指标上。DeepSeek 这次开源的信号很明确:模型能不能跑只是起点,跑得够不够快、算力用得够不够省,同样是决定本地 AI 体验的关键变量。
DeepInfer 解决了什么问题
本地部署大模型的痛点往往不在"装不上",而在"用不爽"。逐 Token 生成的等待感、长上下文场景下显存和缓存的双重压力、有限算力被低效调度浪费——这些问题不会因为模型本身变小而自动消失。DeepInfer 作为支撑模型运行的核心推理技术,瞄准的正是这些工程层面的效率瓶颈。
从公开信息看,DeepInfer 集成了多项推理优化手段:推测解码让较小的模型提前预测多个候选 Token,再由主模型进行校验和约束,减少逐字生成的串行等待;MoE 专家变形与异步调度针对混合专家架构做负载均衡和并行优化;高性能算子则在底层压榨硬件算力。这些技术共同指向一个目标——让同样的硬件完成更多有效计算。
推测解码(Speculative Decoding) 是一种在不改变模型输出分布的前提下加速自回归生成的技术。其基本思路是用一个更小、更快的草稿模型(draft model)先连续预测出多个候选 Token,再由目标大模型一次性并行校验这些候选,保留其中被接受的部分、丢弃并纠正被拒绝的部分。由于校验可以并行完成,原本需要多次串行前向计算的生成过程被压缩为少数几步,从而显著降低逐 Token 生成的等待感。该技术的关键在于草稿模型与主模型分布要足够接近,否则接受率下降,加速效果会打折扣。
MoE(混合专家)架构 把前馈网络拆分为多个"专家"子网络,每个 Token 只激活其中少数几个,从而在总参数量很大的情况下控制单次计算的成本。它的工程难点在于负载均衡:如果请求集中涌向少数热门专家,就会出现部分设备空闲、部分设备过载的情况。因此 MoE 推理通常需要专家并行切分、动态路由调度与异步通信来摊平负载,这也是 DeepInfer 强调"专家变形与异步调度"的原因。
长上下文与缓存开销的持续优化
长上下文是本地部署中容易被低估的成本项。上下文窗口拉长后,KV Cache 的占用会快速膨胀,计算开销也随之上升。DeepInfer 在这方面做了持续优化,试图压低长上下文场景下的计算与缓存负担。
对本地用户来说,这意味着同一台设备、同一个模型,通过调整推理框架、量化精度和运行参数,就有机会换来不同的速度与资源占用组合。推理框架不再是"能跑就行"的透明层,而成为可以主动调优的性能杠杆。
KV Cache 是大模型自回归推理时缓存历史 Token 的键(Key)与值(Value)张量的机制,用于避免每生成一个新 Token 都重算全部历史注意力。它的显存占用大致与"层数 × 注意力头维度 × 序列长度 × 批大小 × 精度字节数"成正比,因此上下文窗口翻倍,缓存占用也近似翻倍。这正是长上下文在本地设备上格外昂贵的原因。
围绕这一开销,业界常见的优化方向包括:将缓存量化为更低精度(如 FP8、INT8)、对不重要的历史 Token 做驱逐或稀疏保留、按页管理缓存以减少碎片,以及复用相同前缀的缓存(前缀缓存)。这些手段往往需要与具体的注意力实现配合,属于推理框架而非模型本身能决定的部分。
实测数据透露了什么
据 B 站 UP 主分享的实测信息,在 128G 统一内存、873G 带宽、2070 TOPS 算力的硬件平台上,结合 VLM 与相关方案优化,千问 30B 级模型(原文表述为"3087B",疑似笔误)在代码任务中实现了单流 100 TPS 以上的表现。两台算力设备也完成了 DeepSeek广告 V4.1 Flash 1017 的本地部署测试,目前最高速度达到 66 Token/s。
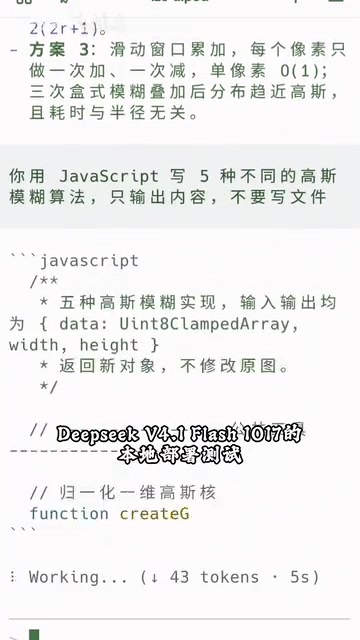
需要说明的是,这组数据来自单一来源的实测分享,硬件配置和测试条件有特定前提,不宜直接外推到所有设备。但它至少说明一点:推理框架的优化空间足以让同一套硬件呈现出显著不同的性能表现。
TPS(Tokens Per Second) 指每秒生成的 Token 数量,是衡量推理速度最直观的指标。需要注意区分"单流"与"聚合"两种口径:单流指单个请求自身的生成速率,直接决定用户感受到的响应快慢;聚合吞吐则是服务器在并发多请求下的总产出,反映硬件利用率。两者可能此消彼长——增大批处理能提升总吞吐,却可能拉高单请求延迟。
此外,TPS 的数值高度依赖上下文长度、输出长度、量化精度和批大小等条件,脱离这些前提横向比较不同设备的数据意义有限。阅读实测结果时,先确认测试口径与配置,再判断性能高低,是更稳妥的做法。
本地 AI 的竞争转向软硬协同
DeepInfer 开源折射出一个趋势:本地 AI 的竞争正在从"模型能力单点比拼"转向"硬件与推理软件的协同优化"。模型能力决定上限,推理效率决定实际可用性。对开发者和重度用户而言,关注推理框架的演进、量化工具有更新、调度策略的变化,可能比单纯等待更大的模型更有实际收益。
一个值得留意的开放问题是:在本地部署场景中,你更看重模型本身的推理能力,还是运行速度与资源效率?这个取舍会直接影响框架选型和硬件投入的方向。
相关推荐

2026年AI编程工具横评:Claude、ChatGPT、Gemini谁最强?
2026年五款主流AI编程工具横评:Claude Code、ChatGPT Codex、Gemini、DeepSeek和GitHub Copilot在真实项目、定价与代码质量上的全面对比,帮你决定每月20美元该花给谁。

ChatGPT Codex克隆任意软件?实测风险与真相
YouTube短视频宣称用ChatGPT Codex或Claude Code即可克隆Adobe、Excel、Figma等软件并终身免费使用。本文拆解其技术可行性、法律风险与私信引流套路,说明AI编程工具真正适合的用法。

Kilo Code免费安装但API收费:成本估算与配置指南
Kilo Code 开源 AI 编程代理安装免费,但接入的 AI 模型按 token 收费。本文详解 VS Code 扩展与 CLI 配置步骤,并用假设用量演示 API 成本估算方法,对比按量付费与订阅制的选择逻辑。