DeepSeek开源推理框架DeepInfer全解析:大模型推理优化揭秘

DeepSeek开源内部推理框架DeepSeek-Infer,解析其定制优化与开源边界。
DeepSeek将其支撑大规模线上服务的内部推理框架DeepSeek-Infer开源,引发社区关注。本文基于B站UP主沐贤的系列视频与官方信息,解释DeepSeek为何在vLLM、SGLang等成熟方案之外仍要自研:框架针对自身模型与硬件做了深度定制,涵盖模型执行、采样、算子优化,以及多卡分工与专家负载均衡。核心技术包括投机解码加速生成、滑动窗口有限重放减少重复计算、一步调度隐藏CPU调度开销、批次不变性与确定性保障线上一致性,以及结构化输出约束。开源范围仅为离线推理,完整KVCache系统、视觉编码与Prefill/Decode分离部署、多副本负载均衡尚未包含。目前支持DeepSeek V4.1 Flash,硬件适配英伟达SM100与华为昇腾950;配套的Recipe与Token Adder负责请求与Token的转换。
DeepSeek将其内部推理框架DeepSeek-Infer开源,引发了社区广泛讨论。在vLLM、SGLang等成熟方案已占据主流的当下,DeepSeek为何还要自研并开源推理框架?它做了哪些独特优化?这些优化又解决了什么问题?B站UP主沐贤的系列视频对此进行了深入剖析,本文基于其分享,结合官方信息,带你一探究竟。
为什么需要DeepSeek-Infer?
推理框架是连接模型与硬件的桥梁。简单来说,它负责让模型在硬件上跑起来:具体怎么计算、多张卡如何配合、请求的调度顺序等,都需要框架来安排。DeepSeek广告-Infer支撑着DeepSeek大规模线上服务,其设计目标直指生产环境中的核心痛点。
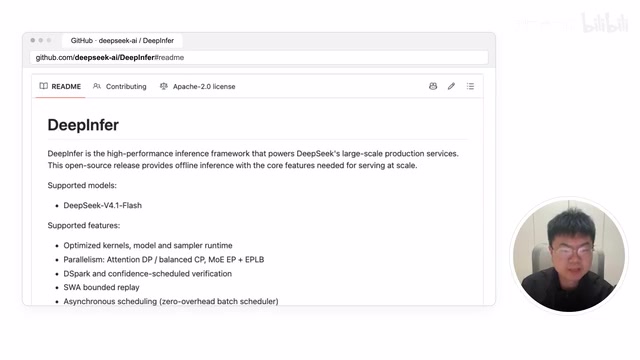
据UP主介绍,DeepSeek-Infer并非重复造轮子,而是针对自身模型与硬件特性做了深度定制。例如,它专门优化了模型执行、采样和算子,并考虑了多卡分工与专家负载均衡。这些优化在通用框架中往往难以实现或不够极致。
核心优化技术解读
计算与多卡协同
DeepSeek-Infer在计算层面进行了多项优化:模型执行、采样以及专门优化的算子。在多卡场景下,它关注如何分工以及如何让专家的负载分配更均匀。这对于混合专家(MoE)模型尤为重要,因为专家负载不均会导致计算资源浪费。
投机解码与状态恢复
框架采用了投机解码(Speculative Decoding)技术:先生成一些草稿token,再去验证,这样一次可以确认更多内容,从而加速生成。同时,它还支持滑动窗口的有限重放:状态恢复时只回放后面一小段,减少重复计算。
投机解码(Speculative Decoding) 的核心思路是“小模型草拟、大模型验证”。由于大模型自回归生成每个 token 都要跑一次完整前向,成本很高;投机解码改用一个更轻量的草稿模型(或同一模型的浅层/小批量路径)先连续猜出若干 token,再让目标大模型一次性并行验证这些草稿。验证时只要草稿 token 与目标模型分布一致就接受,遇到第一个不一致的 token 即截断并回退到目标模型的采样结果。这样做的好处是把多次串行前向压缩为一次并行前向,在草稿命中率较高时显著提升吞吐;代价是草稿质量差时会浪费算力,因此草稿模型与目标模型的分布对齐程度、草稿长度都是关键调参项。
滑动窗口有限重放 针对的是推理中的状态恢复场景:当请求被抢占、批次重排或需要回退时,传统做法是从头重算整个上下文,代价高昂。有限重放只回放最近一小段窗口内的 token,复用窗口之前已缓存的中间状态,从而在保证结果正确的前提下减少重复计算。这与 KV Cache 的复用机制紧密相关,也是长上下文场景下降低尾延迟的重要手段。
一步调度
一步调度(One-step Scheduling)指的是在CPU安排下一步任务时,GPU还能继续计算,尽量少等一会。这有助于减少CPU与GPU之间的空闲时间,提升整体吞吐。
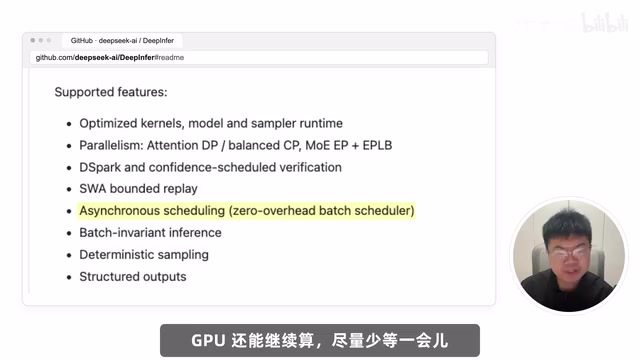
一步调度(One-step Scheduling) 的背景是推理系统的 CPU-GPU 流水线:调度器在 CPU 上决定下一批要跑哪些请求、如何组 batch,而 GPU 执行前向计算。若采用“算完再调、调完再算”的串行模式,GPU 在 CPU 调度期间会空转。一步调度让调度决策与 GPU 计算重叠进行——CPU 提前为下一步准备任务,GPU 持续执行当前步,从而隐藏调度开销。在大规模在线服务中,单步调度耗时虽小,但累积起来会明显影响吞吐与尾延迟,这正是它被视为关键优化的原因。
批次不变性与确定性
这两项特性关系到“付现”(可能指付费服务的一致性)。批次不变性确保同一个请求无论跟谁放在一批里计算,模型的结果都保持一致;确定性则控制选token时的随机性,让相同输入在相同条件下得到相同输出。这两项都有具体的使用条件,但为线上服务的稳定性提供了保障。
批次不变性(Batch Invariance) 解决的是“批内干扰”问题。GPU 上多个请求被拼成一批并行计算,矩阵乘法的分块、归约顺序会随批次组成变化,导致同一请求在不同批次下产生细微数值差异,进而可能改变采样结果。批次不变性通过固定计算图与归约顺序,使单请求的输出与其所在批次无关,这对需要结果可复现、可对账的线上服务至关重要。确定性(Determinism) 则进一步约束采样环节:在相同输入、相同随机种子与相同条件下,选出的 token 完全一致。两者配合,才能让付费服务在重试、审计、A/B 对比时表现稳定。
结构化输出
框架支持结构化输出,例如要求模型按指定的JSON格式回复,可以通过约束来实现。这对于需要严格格式的下游应用非常实用。
开源范围与缺失组件
DeepSeek-Infer此次开源的是离线推理部分。官方列出了三部分未包含在仓库中:完整的KVCache系统、视觉编码与Prefill/Decode分离部署、以及多个副本之间的请求负载均衡。
不过,分离部署所需的大部分引擎能力已在仓库中实现。UP主建议将代码与官方公开的部署信息结合分析,分清哪些已开放、哪些还需完善,再讨论其优势。
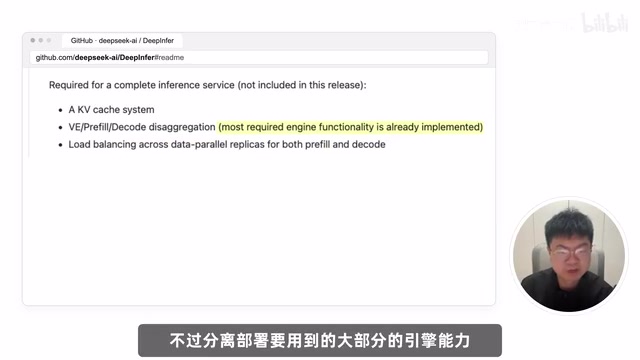
Prefill/Decode 分离部署 是当前大模型推理的主流架构演进方向。Prefill 阶段一次性处理整个 prompt,计算密集、并行度高;Decode 阶段逐 token 生成,访存密集、对延迟敏感。两者对硬件资源的偏好不同,混部在同一实例上会相互干扰。分离部署把两类负载放到不同节点池,分别做扩缩容与调度,能提升整体 GPU 利用率并降低首 token 延迟与生成抖动。KVCache 系统 则是 Decode 阶段的核心:它缓存历史 token 的 Key/Value 张量,避免每步重复计算注意力,其容量管理、前缀复用、跨请求共享与驱逐策略直接决定长上下文与高并发的成本。
支持模型与硬件
目前DeepSeek-Infer支持的模型是DeepSeek V4.1 Flash,硬件支持英伟达SM100 GPU和华为昇腾950。SM100对应英伟达Blackwell架构中计算能力10.0的GPU,如B200、GB200等,它是一个架构标识而非具体显卡型号。
Recipe与Token Adder:请求处理流水线
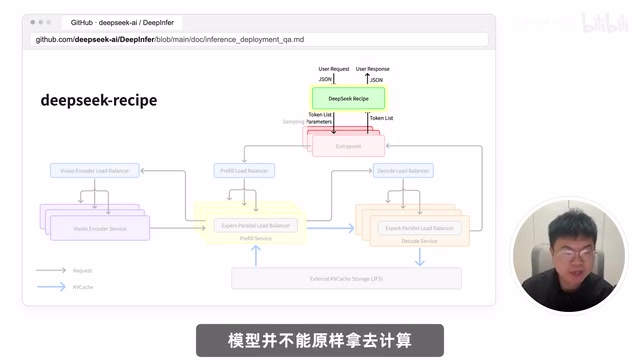
一同开源的还有DeepSeek Recipe。用户发给接口的一段话并不能原样拿去计算,Recipe会将其整理成模型需要的输入,再配合Token Adder转成Token ID;生成完成后,又把模型的输出整理成接口的响应。中间的计算则由推理后端负责。
值得深入的方向
UP主列出了几条后续可深入分析的线索:Prefill和Decode为什么要分开部署?KVCache到底缓存了什么、怎么省掉重复计算?DeepSeek在KVCache层做了哪些优化?Recipe和Token Adder如何把请求变成模型输入?投机解码为什么反而可能更快?这些原理将帮助理解DeepSeek-Infer优化了哪里、为什么这么做,以及在什么情况下才有优势。
总结
DeepSeek-Infer的开源为社区提供了窥探大厂推理优化实践的机会。它在计算、调度、一致性等方面做了针对性设计,虽然完整系统尚未全部开放,但已开放的离线推理部分足以让开发者学习其核心思想。随着后续视频的更新,我们将能更深入地理解这些优化背后的技术原理与适用场景。
相关推荐

主流世界之外:被忽视地区的安全与隐私困境
人本安全研究长期集中于西方,导致安全方案在主流世界失效。研究者Collins Minando基于肯尼亚移动贷款应用、网吧认证困境及九国本地专家研究,揭示社会经济约束如何重塑隐私实践,并提出移动货币隐私重设计与PETs部署路径。

Claude被曝可在正常图片中隐藏秘密信息
Reddit帖子称Claude Fable 5.1能在正常图片中隐藏秘密信息,本文梳理事件背景、图片隐写技术原理及潜在安全风险,并给出从传闻走向验证的测试路径建议。

AI助手何时该主动建议?时机决定一切
AI助手何时该主动建议?Reddit讨论揭示:同样的建议在不同时机感受迥异。本文分析主动建议的双面性、用户期待的分界线及设计原则,探讨如何平衡自动化与用户控制。