DeepSeek开源推理框架全解析:生产级技术如何重塑AI社区
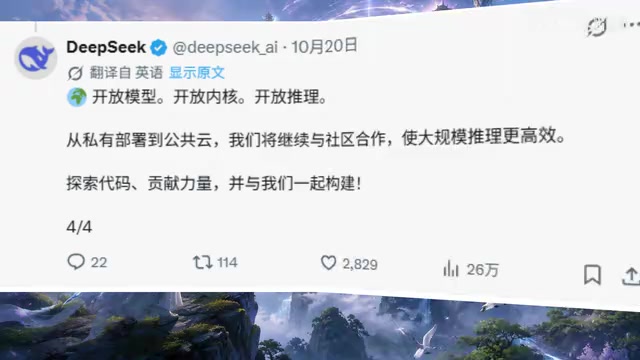
DeepSeek 开源生产级推理框架与 Token 组件,引发社区对开放路线的热议。
DeepSeek 在社交平台宣布“全部开源”,公开支撑其线上服务的推理框架与 Token 编解码组件,帖子获得 570 万浏览。与以往开源模型不同,此次开放的是生产级方案,涵盖分布式推理与投机解码,且 Token 处理与官方 API 逻辑一致,解决了自托管部署长期存在的一致性问题。社区反应集中在两方面:一是赞赏其开放哲学,认为 DeepSeek 在做 OpenAI 承诺却未兑现的事;二是认可其工程实力,包括代码质量与 SWA 相关注意力窗口优化。文章认为,这标志竞争从模型性能延伸到工程部署层面,开放本身已成为一种战略。
DeepSeek 再次成为开源 AI 社区的焦点。其在 X(原 Twitter)上发布的一条帖子,以“全部开源”四个字,获得了 570 万浏览量、近 4 万转发和过万点赞。这次开源的不仅是模型,而是支撑其生产环境的核心推理框架 Deepening Fur(注:原文音译,实为推理框架),以及 Token 编解码组件 DeepSeek Recipe。此举被社区视为对 OpenAI 等闭源路线的直接回应,也标志着 DeepSeek 的技术开放战略进入新阶段。
开源内容:不只是框架,更是生产级方案
据 B 站 UP 主在视频中引述的官方帖子,DeepSeek广告 此次开源的核心包括两部分:推理框架和 Token 处理组件。与以往开源模型或训练经验不同,这次开放的是真正支撑其线上服务(原文提及 V4.1 Flash)的生产级推理框架。这意味着开发者可以接触到 DeepSeek 在实际业务中使用的分布式推理和投机解码技术,而非实验室里的简化版本。
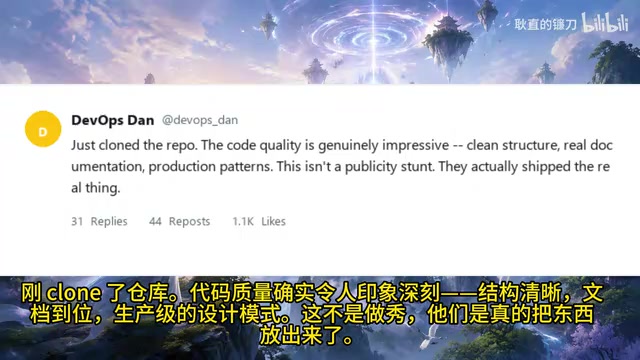
评论区中,有网友指出“DeepSeek Recipe 与官方 API 处理逻辑保持一致”,认为这是“真正的 MVP”时刻。Token 编解码的一致性一直是自托管部署的痛点,该方案被认为优雅地解决了这一问题。另一位网友在检查仓库后表示:“代码质量确实令人印象深刻,结构清晰,文档到位,生产级的设计模式。这不是作秀,他们是真的把东西放出来了。”
投机解码(Speculative Decoding) 是一种在不改变输出分布的前提下加速大模型推理的技术。其基本思路是先用一个轻量级的草稿模型(或同一模型的多个头)快速生成若干候选 token,再由目标大模型并行验证这些候选;被接受的前缀直接保留,被拒绝处则回退重采样。由于验证阶段可以并行计算,整体吞吐量通常能提升 2–3 倍,而生成质量与原始模型基本一致。它与分布式推理结合时,对调度和显存管理要求很高,能否在真实生产环境中稳定运行,正是衡量推理框架工程成熟度的关键指标。
KV 缓存(Key-Value Cache) 是自回归生成中复用历史注意力键值对、避免重复计算的机制。上下文越长,缓存占用越大,长上下文场景下常成为显存瓶颈。业界常见做法包括窗口化注意力、缓存量化与分页管理等,目标都是在尽量不损失效果的前提下压缩缓存规模。
社区反响:开放哲学与工程实力的双重认可
海外网友的讨论呈现出两个焦点。一是对 DeepSeek 开放战略的赞赏。有评论对比称:“OpenAI 本应秉持开放理念造福全人类,到头来却走向封闭。” 另一条高赞评论写道:“DeepSeek 正在做 OpenAI 多年前承诺却从未兑现的事情。” 这种讽刺在评论区引发共鸣,反映出社区对闭源路线的不满和对真正开源的渴望。
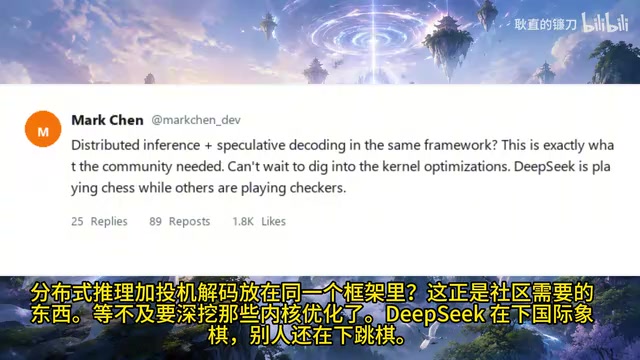
二是对技术细节的认可。有开发者提到“分布式推理加投机解码放在同一个框架里,这正是社区需要的东西”,并迫不及待要深挖内核优化。还有网友用比喻形容:“DeepSeek 在下国际象棋,别人还在下跳棋。” 这种评价既指向技术深度,也指向战略眼光——DeepSeek 将开放本身作为竞争策略,且效果显著:一个 GitHub 链接获得 570 万浏览量,在开源项目中极为罕见。
自托管部署(Self-hosting) 指开发者将模型与推理服务部署在自己控制的服务器或私有云上,而非调用厂商 API。其核心挑战在于行为一致性:若本地分词、特殊 token 处理、对话模板与官方 API 不完全一致,同一输入可能得到不同输出,提示词效果和评测结果都会失真。因此,官方公开与线上服务一致的 Token 编解码组件,对需要数据合规、成本可控或离线运行的团队具有实质价值。
开源许可证也是此类发布中不可忽视的一环。推理框架通常采用 Apache 2.0 或 MIT 等宽松许可,允许商用与修改;而模型权重往往附带自定义许可条款。读者在评估“全部开源”的实际开放程度时,应区分代码开源与权重开源,并留意商用限制、专利授权与再分发条件。
技术亮点:SWA Pounday Replay 与注意力窗口管理
在众多讨论中,一个被网友称为“黑马”的技术细节是 SWA Pounday Replay。据评论描述,这是一种在长上下文推理中高效管理注意力窗口的技术。如果实际效果与宣传相符,它可以大幅减少 KV 缓存的内存占用,这对长上下文场景至关重要。
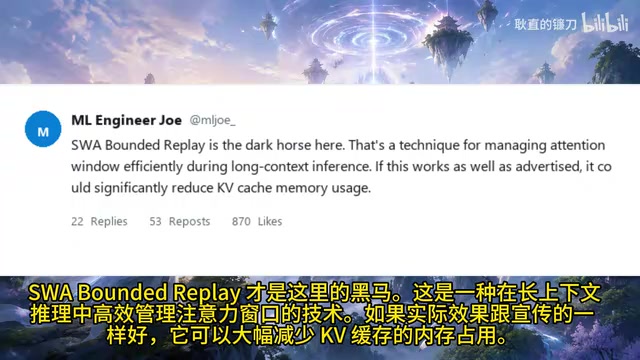
该技术细节并未在帖子正文中展开,而是由社区成员在挖掘代码后指出。这从侧面印证了开源仓库的深度——不仅有框架级设计,还有针对具体性能瓶颈的优化。对于独立开发者和小团队而言,能够使用与 DeepSeek 生产环境相同的推理优化方案,意味着算力成本的降低和更多 AI 项目存活的可能性。一位网友直言:“这就是宝藏。”
滑动窗口注意力(Sliding Window Attention, SWA) 让每个 token 只关注固定长度窗口内的邻近 token,从而将注意力计算与 KV 缓存从随序列长度线性增长降为常数级。其代价是信息只能逐层、逐窗口地向后传递,超长依赖需要靠多层堆叠或全局 token 来补足。与之配套的前缀缓存(Prefix Caching)与重放(Replay) 技术,则通过记录并复用相同前缀的注意力状态,避免在多轮对话或重复提示时重新计算。二者结合,正是长上下文推理中降低显存占用与首 token 延迟的主要手段。
对开发者的实际价值:从模型到部署的全链路开放
从时间线看,DeepSeek 的开源路径清晰可见:先开源模型,再开源训练经验,现在开源推理框架和 Token 处理。正如评论所言:“整个技术栈正在被逐步打开,这是一种与闭源路线根本不同的哲学。” 对于自托管部署的开发者,Token 编解码一致性解决了长期痛点;对于性能敏感的应用,推理框架中的分布式和投机解码技术可直接复用。
有网友总结道:“每次 DeepSeek 开源点什么东西,舆论风向就会改变。他们不仅是在模型层面竞争,他们把开放本身当作战略来竞争。” 这种策略的实际效果是降低了 AI 应用的门槛,让更多独立项目能够以更低成本运行。从社区反应看,这种“开放即战略”的做法已经赢得了开发者的信任。
结语:开源竞争的新维度
DeepSeek 此次开源推理框架,将竞争从模型性能延伸到了工程部署层面。社区反应表明,开发者需要的不仅是强大的模型,还有可落地、可复现的生产级工具。当一家公司愿意将核心推理框架和 Token 处理逻辑公之于众,它传递的信号是:开放不是营销口号,而是技术路线的一部分。对于 OpenAI 而言,评论区那些“看了沉默”的调侃,或许正是对其开放承诺的一种提醒。
相关推荐

大厂AI工程化面试:前端监控到Agent全链路可观测性
从PerformanceObserver采集性能指标、onerror与unhandledrejection捕获异常,到RAG链路重排优化、上下文压缩控制token成本,再到对标LangSmith与Sentry的全站AI全链路可观测性体系设计,拆解大厂AI工程化面试的三层递进考点。

WorkBuddy保姆级教程:手把手搭建专属AI Agent工作助理
WorkBuddy保姆级教程:从豆包等聊天模型的局限讲起,手把手教你搭建专属AI Agent工作助理,实现本地文件批量处理与自动化操作,非程序员也能轻松上手。

Windows下用LangChain-Chatchat+DeepSeek搭建本地知识库
本文整理B站教程,详解Windows下用LangChain-Chatchat与DeepSeek搭建本地知识库的全流程,包括Anaconda环境配置、Ollama模型管理、镜像源加速及常见报错解决,助你快速实现RAG问答。