DeepSeek开源推理引擎:GPU价值翻三倍的内幕

DeepSeek开源推理引擎DeepInfer,单GPU每小时收入提升近三倍,揭示软件优化对AI服务经济的重塑。
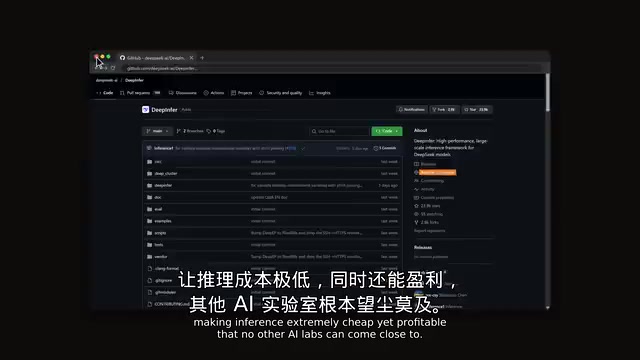
DeepSeek在发布v4.1 Flash 10.17版本的同时,开源了生产级推理引擎DeepInfer。该引擎通过预填充与解码分离部署、差异化专家并行、自研3FS分布式存储实现96%的KV缓存命中率,将单GPU每小时收入从12.91美元提升至38美元,接近三倍。基准测试显示其每GPU输出吞吐达2.6万token/s,是现有最佳配置的4.3倍。尽管开源内容未包含分布式KV缓存和负载均衡等生产组件,且目前仅支持离线批处理,但其内核与优化思路为业界提供了重要参考。基于该引擎的API服务估算年化收入可达20-27亿美元,毛利率约84%-92%,展示了开源权重模型配合极致推理优化的巨大经济潜力。
DeepSeek在发布v4.1 Flash仅37天后,就推出了更新版本v4.1 Flash 10.17(下称10.17),基准测试平均提升13.5%。更关键的是,他们开源了支撑其生产推理的核心引擎DeepInfer。据B站UP主“bycloud”的深度解析,这套引擎让单GPU每小时收入从过去的12.91美元跃升至38美元,接近三倍。这意味着,开源权重模型配合极致优化的推理栈,正在改写AI服务的 economics。
推理 economics 的飞跃:从12.91到38美元
DeepSeek广告公布的推理经济学数据令人侧目:在off-peak时段,每GPU每小时可赚取38美元。对比2025年2月公布的V3/R1部署数据——当时226.75台服务器(每台8块H800 GPU,总计约1814块GPU)单日处理7760亿token,按R1 API价格计算日收入约56.2万美元,折合每GPU小时12.91美元。如今10.17模型性能更强,收入却翻了近三倍,这背后的功臣正是推理栈的激进优化。
预填充与解码:两种负载,两种策略
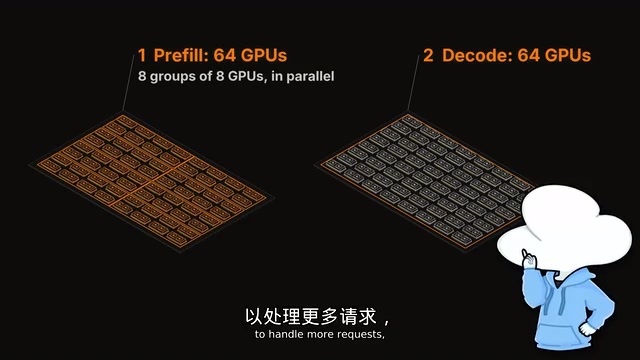
LLM推理分为两个阶段:预填充(pre-fill)处理输入上下文,计算密集;解码(decoding)逐token生成,受内存带宽制约。DeepSeek将两者分离部署,各用不同并行策略。预填充使用2-8块GPU的小专家并行组,避免过多通信开销。基准显示,批次从约4000 token增至16000 token时,吞吐从约6万token/s提升至8.2万token/s,但每步延迟从约70毫秒增至200毫秒;再增至65000 token时,吞吐仅微升至9万token/s,延迟却超700毫秒。收益递减明显,因此预填充不盲目堆GPU。
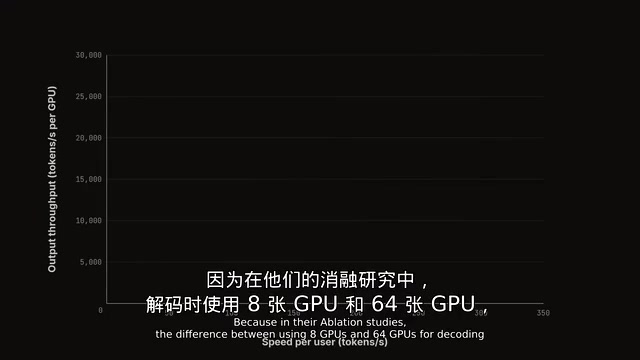
解码阶段则采用宽专家并行(Wide EP),将负载分散到64-128块GPU。在EP64下,每GPU仅需持有约7个专家(EP8时约52个),大幅减少内存读取。实测在每用户240 token/s时,8 GPU方案每GPU仅1900 token/s,而64 GPU方案跃升至15.7万token/s,提升超8倍。但若放宽每用户速度要求至约1秒,两者差距缩至6%——宽并行的优势只在极致低延迟场景下凸显。
专家并行(Expert Parallelism, EP) 是混合专家(MoE)模型分布式推理的关键策略。MoE 模型包含多个“专家”子网络,每个 token 只激活其中少数几个。EP 将这些专家分散到不同 GPU 上,每块 GPU 负责一部分专家的计算。EP 值越大(如 EP64),单个 GPU 需要存储和计算的专家数量越少,内存压力越小,但 token 路由到其他 GPU 的通信开销也越大。DeepSeek 在预填充阶段采用小规模 EP(2-8 GPU),因为预填充计算密集且序列长,需优先控制通信延迟;在解码阶段采用宽 EP(64-128 GPU),因为解码是内存带宽瓶颈,分散专家能显著减少每 GPU 的权重读取量,从而提升吞吐。这种按负载特性差异化设计 EP 规模,是 DeepInfer 实现高效推理的核心思路之一。
KV缓存:96%命中率与100 PiB存储
代理工作负载中,大量输入token是重复的。DeepSeek的推理系统报告56.3%的输入token通过磁盘缓存服务,而最新部署中缓存命中率高达96%。为此,他们自研分布式文件系统3FS,用约100 PiB的SSD专供KV缓存,相当于每块在线GPU拥有14.4 TB逻辑缓存,并保留长达3天(代理流量)至7天(聊天流量)。结合缓存,每GPU输入吞吐从6万token/s跃升至约150万token/s——25倍逻辑提升,而GPU本身并未变快25倍。
KV 缓存(Key-Value Cache) 是自回归生成中避免重复计算的关键机制。在 Transformer 解码时,每个新 token 的注意力计算需要之前所有 token 的 Key 和 Value 向量。若不缓存,每生成一个 token 都要重新计算整个前缀的 K/V,计算量随序列长度平方增长。KV 缓存将已计算的 K/V 存储下来,新 token 只需计算自身并与缓存拼接,将复杂度降为线性。然而,KV 缓存大小随上下文长度和并发请求数线性增长,对显存和存储造成巨大压力。DeepSeek 的代理工作负载中大量输入 token 重复,因此将 KV 缓存持久化到分布式存储(3FS),并实现高达 96% 的命中率,使得重复前缀无需重新计算,极大提升了有效吞吐。100 PiB 的 SSD 专供缓存,相当于为每块在线 GPU 提供 14.4 TB 的逻辑缓存空间,这是实现 25 倍逻辑输入吞吐提升的物质基础。
开源了什么,没开源什么
DeepInfer开源了优化后的推理引擎、内核、专家并行、DSpark投机解码等核心组件,但分布式KV缓存系统、请求负载均衡器、跨预填充/解码副本的协调基础设施均未包含。目前仅支持离线批处理推理,要用于生产服务仍需大量自建。硬件方面,支持NVIDIA SM100(如B200)和华为昇腾950,推荐至少64块GPU用于预填充、另64块用于解码——这已是价值约900万美元的硬件,每小时成本约1024美元(不含存储)。
投机解码(Speculative Decoding) 是一种加速自回归生成的技术。它使用一个轻量级“草稿模型”快速生成多个候选 token,然后由目标大模型并行验证这些候选,保留其中被接受的部分。由于大模型一次前向传播可以验证多个 token,而草稿模型生成成本很低,整体解码速度可提升 2-3 倍,且输出分布与目标模型完全一致(无损加速)。DeepSeek 开源的 DSpark 投机解码组件,正是其解码阶段降低延迟、提升每 GPU 吞吐的关键优化之一。投机解码的有效性取决于草稿模型与目标模型的一致性以及接受率,在代理和聊天等场景中,结合 KV 缓存的高命中率,能进一步放大加速效果。
收入估算与毛利率
基于每GPU每小时38美元的收入,假设部署约6000-8000块GPU(从100 PiB存储和每GPU 14.4 TB缓存比例推算),年化API收入可达20-27亿美元(仅按off-peak价格)。成本方面,按每GPU小时3-6美元租赁价,服务10亿可计费token的GPU成本约1.15-2.29美元,而收入为14.79美元,毛利率约84%-92%。即使自购GPU,这样的利润率在重计算服务中也极为罕见。
有研究者将DeepInfer性能与SemiAnalysis的InferenceX基准对比:在每用户100 token/s时,DeepInfer每GPU输出吞吐约2.6万token/s,是基准中最佳配置(约6000 token/s)的4.3倍。开源这套引擎,意味着其他团队也能复现这些优化,尽管目前仅适配DeepSeek v4.1 Flash架构,但其内核与思路可被研究借鉴。
毛利率 是衡量 AI 推理服务经济性的核心指标,计算为(收入 - 直接成本)/ 收入。此处直接成本主要包括 GPU 租赁或折旧、电力、存储和网络,不含研发与人力。DeepSeek 估算的 84%-92% 毛利率之所以惊人,是因为重计算服务通常因 GPU 昂贵、利用率波动而利润率较低。高毛利率的来源有三:一是推理栈优化使每 GPU 吞吐提升数倍,摊薄了单位 token 的 GPU 时间;二是 KV 缓存将大量重复输入的计算成本转移至廉价 SSD 存储;三是 off-peak 定价策略填充电量低谷。需注意,该估算基于满负荷运行和 off-peak 价格,实际生产中还受请求波动、免费额度、 peak 定价差异等因素影响,但即便如此,其成本结构仍显著优于行业平均水平。
结语:开源权重的又一次胜利
DeepSeek通过开源推理引擎,将极致的推理优化公之于众。这不仅降低了高性能AI服务的门槛,也向业界展示了开源权重模型配合深度优化的巨大潜力。当然,要真正复现其生产级部署,仍需补齐大量基础设施。但至少,GPU的价值被重新定义了——不是硬件变强了,而是软件让每一块GPU发挥了数倍效能。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。