Dense还是MoE?如何选对AI模型架构
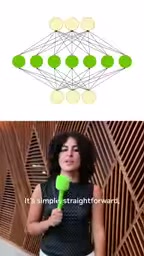
Dense模型全参数激活追求质量,MoE稀疏激活提升吞吐,选型关键在于权衡质量、延迟与部署复杂度。
本文系统对比了大模型两种主流架构:Dense(稠密)模型对每个token激活全部参数,结构简单、行为可预测,适合单GPU追求单次推理质量最大化的场景;MoE(专家混合)模型则将参数拆分为多个专家模块,由路由器为每个token动态选取部分专家处理,以较低的单次计算开销实现更高的吞吐效率,尤其适合高频工具调用等agentic工作负载。然而MoE的效率优势伴随着更高的路由复杂度、专家负载均衡挑战和显存分布问题。文章强调,架构选择没有绝对优劣,核心是围绕质量、延迟、显存和部署目标做出符合自身业务约束的权衡。
在大模型的技术选型中,Dense(稠密)架构与Mixture of Experts(专家混合,简称MoE)架构常常被拿来比较。两者共享相同的基础结构,真正拉开差距的,是它们使用参数的方式。理解这一差异,是决定你的模型在质量、延迟、显存和部署成本之间如何取舍的关键。
Dense与MoE的核心差异
Dense模型的逻辑非常直接:每处理一个token,都会激活全部参数。这种做法简单、一致、可预测,没有额外的调度逻辑,模型的每一部分都参与到每一次推理中。
而MoE模型走的是另一条路线。它把参数拆分成若干个被称为“专家”(experts)的模块——这些专家本质上是前馈网络(feedforward network)的并行副本。当token进入模型时,一个“路由器”(router)会决定哪些token交给哪些专家处理。
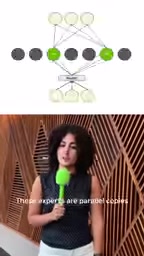
换句话说,Dense模型是“全员上阵”,MoE模型则是“按需调度部分专家”。这个看似细微的机制差异,直接决定了两类架构在实际应用中的表现分野。
从参数规模的角度来看,MoE架构的一个显著特点是「总参数量」与「激活参数量」的分离。以Mistral的Mixtral 8x7B为例,模型总参数量约为46.7B,但每次推理实际激活的参数仅约12.9B——大致相当于一个同级别Dense模型的规模。这意味着MoE可以用接近Dense模型的计算开销,享有远超Dense模型的总参数容量,从而在理论上储存更多"知识"。这种「稀疏激活」(sparse activation)的设计思路,正是MoE在效率层面的核心杠杆点。路由器通常采用Top-K机制,即对每个token只选择得分最高的K个专家(常见配置为K=2),被选中的专家处理该token后,输出结果加权合并后继续传递。
什么时候该选Dense模型
Dense模型的优势在于在给定硬件上榨取最大化的智能表现,代价是速度。如果你的核心诉求是让每一次推理都尽可能聪明,而对延迟没有那么敏感,Dense是更稳妥的选择。
一个典型场景是:你只有一块GPU,希望把这块卡的智能潜力发挥到极致。由于Dense模型没有路由和专家调度的额外复杂度,它的部署和服务链路更简单,行为也更可预测。对于资源受限但追求单次输出质量的场景,Dense模型往往更合适。
什么时候该选MoE模型
MoE模型的价值体现在吞吐效率上。当你希望快速处理大量token,并且愿意为此牺牲一部分智能表现时,MoE是更优解。
最具代表性的场景是高频次的智能体(agentic)工作负载——比如包含大量工具调用(tool calls)的应用。这类任务对响应速度要求高,token消耗量大,MoE通过只激活部分专家,能在保持较大总参数量的同时降低单次计算开销。
但天下没有免费的午餐。MoE的代价是更高的路由与服务复杂度。路由器本身需要训练和调优,专家的负载均衡、部署编排都会带来额外的工程负担。这意味着选择MoE不仅是模型层面的决策,也是对整个服务基础设施的考验。
MoE的路由与服务复杂度在工程实践中有几个具体体现值得关注。首先是「专家负载均衡」问题:如果路由器过于偏向某几位专家,会导致部分专家过载而其余专家闲置,训练时需要引入辅助损失(auxiliary loss)来约束均衡性。其次是「显存分布」问题:所有专家的参数都需要加载到内存中,尽管单次推理只激活部分专家,但总显存占用远高于同等激活参数量的Dense模型,这对多GPU分布式部署的网络通信带宽提出了更高要求。最后是「推理批次大小」的敏感性:MoE在大批量(large batch)推理下效率优势明显,但在单请求低延迟场景下,路由调度的额外开销反而可能抵消稀疏激活带来的收益。
如何做出正确的选择
归纳来看,两者的分野可以浓缩成一句话:Dense模型使用全部参数,MoE模型只使用被选中的专家。
| 维度 | Dense | MoE |
|---|---|---|
| 参数激活 | 每个token激活全部参数 | 每个token仅激活部分专家 |
| 优势 | 单次输出智能最大化 | 吞吐快、token处理高效 |
| 代价 | 速度较慢 | 路由与服务复杂度更高 |
| 适合场景 | 单GPU追求极致质量 | 高频工具调用等agentic负载 |
没有绝对更好的架构,只有更契合目标的架构。真正决定选型的,是你对质量、延迟、显存和部署目标这四个维度的权衡。如果你追求单次推理的智能上限,Dense是可靠的起点;如果你面对的是海量、高频、对速度敏感的任务,MoE则能带来更好的效率回报。
在实际落地前,明确自己的部署约束和业务优先级,比盲目追逐参数规模更重要。架构选择本质上是一道工程权衡题,而非技术优劣的排位赛。
相关推荐
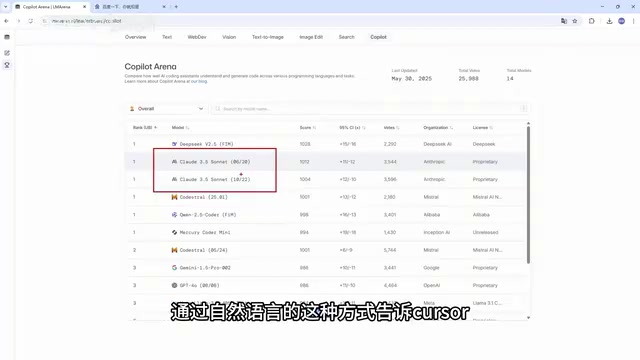
Cursor是什么?AI编程工具与传统IDE的核心区别
Cursor是什么?本文详解这款内置AI助手的编程工具,对比它与VS Code等传统IDE在代码补全、生成、重构、错误处理上的核心区别,并分析Cursor集成Claude、DeepSeek等大模型的特性及适用人群。
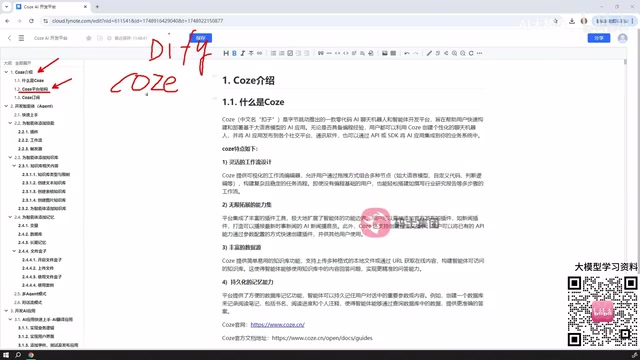
Coze扣子3.0入门指南:智能体与AI应用全景解析
Coze扣子3.0入门教程:解析字节跳动AI开发平台的智能体、AI应用、工作流与插件体系,涵盖单Agent与多Agent协作,并对比Coze与Dify的差异,帮助零基础用户快速搭建AI智能体。
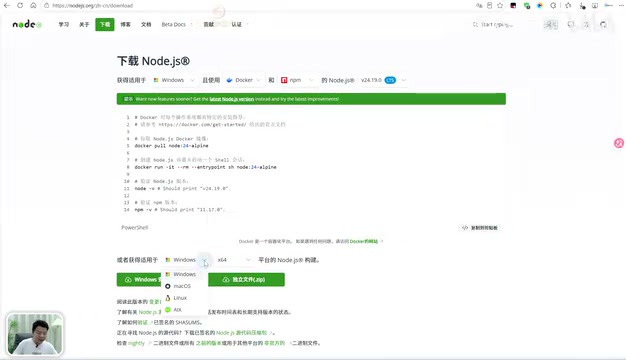
DeepSeek Harness 环境搭建:Node.js 安装与配置全流程
零基础搭建 DeepSeek Harness 运行环境的完整教程,涵盖 Node.js 安装、Add to PATH 勾选、npm 全局目录与缓存目录迁移,以及系统环境变量配置全流程,附常见踩坑提示。