Dify本地部署实战:Docker+Ollama+RAG全流程搭建指南
手把手讲解如何用Docker和Ollama在本地部署Dify,构建私有化AI应用全流程。
本文介绍了一套以 Dify 为核心的本地 AI 应用部署方案,涵盖从基础环境到上线应用的完整链路。Dify 是开源的 LLM 应用开发平台,本地部署的核心优势在于数据可控与成本可控。整套方案以 Docker 管理多服务组件、Ollama 提供本地大模型推理能力为基础,同时支持灵活切换云端 API。应用层面,教程重点讲解了工作流编排、变量管理和 RAG(检索增强生成)三大核心能力——其中 RAG 是让 AI 能够调用私有知识库的关键技术,被视为从「玩模型」走向「做实用 AI 应用」的分水岭。整套课程定位零基础入门,把 Docker、大模型部署等前置知识一并纳入,适合希望系统掌握 Dify 并自建私有 AI 应用的开发者。
为什么选择本地部署 Dify
Dify 是当下热门的开源 LLM 应用开发平台,它把工作流编排、提示词管理、知识库检索等能力整合在一个可视化界面里,让开发者无需从零编写大量代码就能构建 AI 应用。本地部署相比直接使用云端服务,最大的优势在于数据可控与成本可控——你的知识库文档、对话记录都留在自己的机器上,不必担心敏感信息外泄,也不用为 API 调用量持续付费。
这套教程的核心思路很清晰:以 Dify 为主线,围绕它把本地部署所需的周边工具串联起来。要在本地跑起 Dify,绕不开 Docker;要给 Dify 提供本地大模型能力,则需要 Ollama。整个链路打通后,你既能连接云端大模型,也能完全离线运行一套私有化的 AI 应用。
Docker:本地部署的基础环境
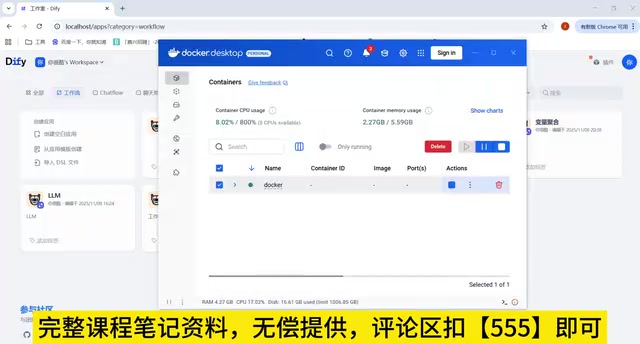
Docker 是整套方案的地基。Dify 由多个服务组件构成(API 服务、前端、数据库、向量库等),手动逐个安装配置既繁琐又容易出错,而 Docker 通过容器化把这些组件打包管理,一条命令就能拉起整套环境。
对于初次接触容器技术的人来说,理解 Docker 的镜像、容器、数据卷这几个基本概念是关键。教程从基础环境搭建讲起,正是考虑到很多 Dify 学习者本身并非运维背景。掌握 Docker 的基本使用后,不仅能部署 Dify,后续折腾其他开源工具也会轻松许多——这是一项通用技能,值得投入时间打牢基础。
Docker 的核心概念可以用三个层次来理解:**镜像(Image)**是应用及其依赖打包后的只读模板,类似安装光盘;**容器(Container)**是镜像运行起来后的实例,类似从光盘安装后跑起来的程序;**数据卷(Volume)**则是容器与宿主机之间持久化共享数据的机制,确保容器删除后数据不会丢失。Dify 的 docker-compose.yml 文件定义了多个相互依赖的服务,包括前端 Nginx、后端 API、PostgreSQL 数据库、Weaviate 向量库、Redis 缓存等,docker compose up 一条命令会按依赖顺序依次启动这些容器并完成网络互联。对于非运维背景的开发者,重点掌握容器的启动、停止、查看日志(docker logs)以及数据卷挂载这几个操作,基本就够用了。
Ollama 与本地大模型
Dify 本身只是应用编排层,它需要背后有大模型提供推理能力。云端可以对接 OpenAI、通义等 API,但如果追求完全本地化,就需要 Ollama 出场。
Ollama 是一个轻量的本地大模型运行工具,能够方便地下载和运行各类开源模型,比如 DeepSeek 系列。通过 Ollama 把模型跑在本地,再让 Dify 连接到 Ollama 提供的接口,就构成了一套不依赖外部网络的完整推理链路。这种组合特别适合对数据隐私要求高、或者网络环境受限的场景。
Ollama 的工作方式是在本地启动一个兼容 OpenAI API 格式的 HTTP 服务(默认监听 http://localhost:11434),这意味着 Dify 可以像调用 OpenAI 一样调用 Ollama,只需在模型配置中把 Base URL 指向本地地址即可。需要注意的是,当 Dify 运行在 Docker 容器内时,localhost 指向的是容器内部而非宿主机,通常需要使用宿主机的局域网 IP 或 host.docker.internal(macOS/Windows 可用)才能让容器访问到宿主机上的 Ollama 服务。本地模型的运行对硬件有一定要求:7B 参数的模型在 8GB 显存的 GPU 上可流畅运行,纯 CPU 推理速度会明显变慢;选择模型时可参考 Ollama 官方库中各模型的参数量和量化版本,量化程度越高(如 Q4)占用显存越少,但生成质量会有所下降。
云端与本地的灵活切换
值得关注的是,本地部署并不意味着放弃云端能力。教程同时覆盖了如何在云端连接大模型,以及如何在本地搭建大模型两种路径。
实际开发中,这两种方式往往需要结合使用。云端模型能力更强、响应更快,适合对效果要求高的核心任务;本地模型则胜在隐私和成本,适合处理内部数据或高频调用。Dify 允许在同一平台内灵活配置不同模型来源,开发者可以根据具体应用场景做取舍,这也是它作为应用开发平台的价值所在。
工作流、变量与 RAG 的核心能力
Dify 的应用开发能力集中体现在几个核心模块上。
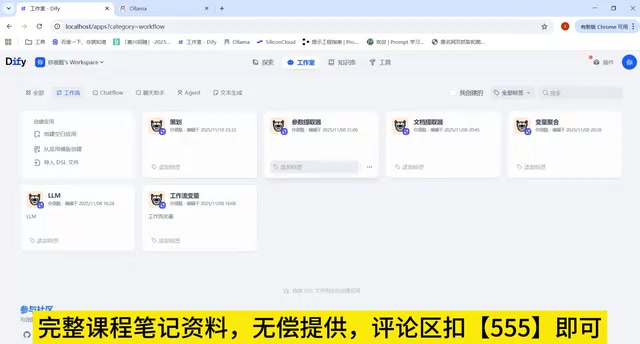
工作流设计是把多个 AI 步骤编排成完整业务逻辑的能力。通过可视化画布,你可以把用户输入、模型调用、条件判断、结果输出等节点连接起来,构建出复杂的应用逻辑。
变量管理则贯穿整个工作流,负责在各节点之间传递数据。合理的变量设计能让工作流更清晰、更易维护。
RAG:让 AI 用上你的私有知识
整套课程的收尾落在 RAG(检索增强生成)技术上。RAG 的原理是先把文档切分、向量化并存入知识库,当用户提问时,先从知识库中检索出相关内容,再连同问题一起交给大模型生成回答。
这解决了大模型「不知道你的专有数据」的痛点。无论是企业知识库、产品文档还是个人笔记,通过 RAG 都能变成 AI 可以引用的知识源。理解 RAG 的原理与技术实现,是从「玩模型」走向「做出真正有用的 AI 应用」的分水岭。
RAG 流程中有几个关键的技术细节值得理解。**文档切分(Chunking)**策略直接影响检索质量——切块太大会引入噪音,太小则丢失上下文,通常需要根据文档类型调整块大小和重叠长度。**向量化(Embedding)**是把文本转换为高维数值向量的过程,语义相近的内容在向量空间中距离更近,这是语义检索的数学基础;本地部署时可以用 Ollama 同时提供 Embedding 模型(如 nomic-embed-text),避免调用外部 API。向量数据库负责存储和检索这些向量,Dify 默认集成了 Weaviate,已包含在 Docker Compose 配置中,无需额外安装。理解这条「切分→向量化→存储→检索→生成」的完整链路,有助于在实际使用中排查知识库召回效果不佳的问题。
从入门到上线的学习路径
这套教程的定位是全流程覆盖——从基础环境搭建、Docker 部署、Ollama 本地模型,到 Dify 的工作流设计、变量配置,再到 RAG 知识库应用,形成了一条从零到上线的完整路径。
对于想入门 Dify 或系统学习这一工具的开发者而言,这种「主线工具 + 周边知识点」的组织方式比较务实。它不会假设你已经懂 Docker、懂大模型部署,而是把这些前置知识都纳入进来。按部就班学完,理论上就能自己搭建并上线一个基于本地大模型和私有知识库的 AI 应用。
相关推荐
Waymo重启圣安东尼奥测试:洪水5个月后卷土重来
Waymo在圣安东尼奥的Robotaxi被洪水冲走并暂停服务约5个月后重新恢复运营。本文回顾事件始末,并分析自动驾驶车辆在极端天气下面临的安全挑战与行业启示。
AIOps是什么?AI如何重塑IT运维
AIOps(面向IT运维的人工智能)通过AI和机器学习实现异常检测、告警降噪与根因分析,帮助企业从被动响应转向主动预测。本文解析AIOps的核心能力与应用价值。
CCC发出邀请:40C3黑客大会以"模范公民"为主题
CCC混沌通信大会宣布第40届(40C3)以"模范公民"为主题,向全球技术爱好者发出邀请。本文解读这一欧洲最大黑客盛会的背景、主题含义及社区反响。