读懂AI Agent的12个核心术语:从Harness到MCP

用12个术语拆解AI Agent的完整运作图谱,从大脑与载体到安全防线。
本文以YouTube创作者整理的术语地图为基础,用通俗语言系统解释了理解现代AI Agent所需的12个核心概念。文章从Agent(在循环中使用工具的模型)与Harness(决定模型实际表现的运行框架)的根本区分出发,说明同一模型在不同Harness中性能可相差近20个百分点。随后依次介绍了Tools(函数调用)、MCP(统一连接标准)、Context Window(工作记忆)、Memory(本质是粘贴回上下文的笔记)、Instructions(隐藏系统提示词)、Skills与RAG(能力扩展机制),以及Subagents(任务分发)。文章最后着重阐明了Prompt Injection这一位列OWASP榜首的安全威胁,并给出权限、沙箱、人在回路三层防御框架。这套词汇体系在ChatGPT、Gemini、Claude之间通用,是评估和使用AI工具的必备认知基础。
AI的世界正在快速演化出一套全新的词汇体系。Agent、Harness、MCP server、Context window——这些术语频繁出现在各类技术讨论中,却常常让人一头雾水。本文基于一位长期使用Claude创作内容的YouTube创作者整理的术语地图,用大白话梳理你必须掌握的12个关键概念。这些定义全部来自官方文档和开放标准,在ChatGPT、Gemini和Claude之间通用。
Agent与Harness:大脑与载体的区别
Agent(智能体) 是理解这一切的起点。聊天机器人只会"回答",而Agent会"行动"。Anthropic将Agent描述为"在循环中使用工具的模型"——思考目标、采取行动、查看结果,然后不断重复直到任务完成。它更像一个带着待办清单的实习生,而不是只会答疑的图书管理员。Claude Code、OpenAI的Codex、Google的Anti-Gravity都采用这种工作方式。
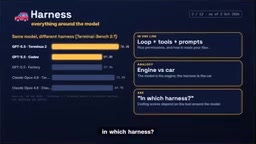
Harness(框架/载体) 是一个容易被忽视但极其重要的概念。如果说模型是大脑,那么Harness就是围绕大脑的一切——循环逻辑、工具、提示词、权限、以及它如何读取你的文件。这好比引擎与整车的关系。
Harness的影响有多大?原文给出了一组对比数据:在某项编程基准测试中,OpenAI的GPT-5.5在基准自带的Harness里得分76%,但在Codex内部只有57%;Claude在Claude Code中的得分也略低。同一个大脑,放进不同的车,表现截然不同。所以当有人说"某个AI编程更强"时,值得追问一句——在哪个Harness里?
Tools与MCP:让模型真正"动手"
Tools(工具),也叫Function Calling(函数调用)。模型本身只能生成文本,而工具让它能够真正做事——搜索网页、运行代码、读取文件、发送邮件。模型写出一个结构化请求,比如"调用天气工具查询DACA",应用负责实际执行并把结果交回。就像一个无法离开厨房的厨师,通过服务员把订单传递出去。
MCP(Model Context Protocol,模型上下文协议) 解决的是连接标准化问题。在MCP出现之前,每个AI应用都需要为每个工具编写自定义连接。MCP提供了一个统一插头,官方文档称之为"AI的USB-C接口"。
具体来说,MCP server是一个提供工具的小程序,比如你的文件、GitHub或数据库;MCP client则存在于AI应用内部与之通信。Anthropic于2024年11月发布MCP,自2025年12月起由Linux基金会旗下的Agentic AI Foundation托管,ChatGPT、Gemini、Copilot、Cursor和VS Code都已支持。
一个重要警告:只安装你信任的server,因为恶意server可能向Agent投喂有害指令。
值得补充的是,Function Calling的执行过程涉及一次"控制权转交":模型生成一段结构化的JSON请求(而非普通文本),宿主应用程序捕获这段请求、调用对应的外部函数或API,再将返回结果作为新的上下文喂回给模型,模型才继续生成后续内容。这个来回可能发生多次,每一次都会消耗上下文窗口的空间。正因如此,工具调用的设计——比如返回值是否精简、调用次数是否克制——直接影响整个Agent的效率和可靠性。
记忆系统:Context Window、Memory与Instructions
Context Window(上下文窗口) 是Agent的工作记忆,即它一次能看到的全部内容,以token(词片段)衡量。当今顶级模型能容纳约一百万token,大致相当于八本小说的量。但更大并不等于更好——Anthropic将这个问题称为"Context Rot(上下文腐烂)":窗口越满,模型越容易遗漏信息。因此,整洁、相关的上下文胜过把所有东西都塞进去。
Memory(记忆) 这里藏着一个反直觉的事实:模型本身并不会从你的对话中学习。所谓记忆,其实是被保存下来、再粘贴回上下文窗口的笔记。ChatGPT、Gemini和Claude能保存关于你的事实,你可以查看和删除。编程Agent则使用项目文件——Claude Code用CLAUDE.md,Codex等用agents.md。当长对话填满窗口时,Compaction(压缩) 会把较早的轮次总结掉,让Agent能继续运行。
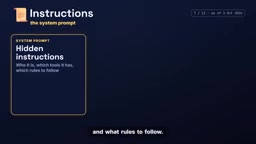
Instructions(指令),即系统提示词。在你输入任何内容之前,应用已经给模型下达了隐藏指令:它是谁、有哪些工具、要遵守什么规则。在编程项目中,agents.md是一种用于Instructions的开放格式,由OpenAI发起,现由Agentic AI Foundation运营,已有超过6万个项目在使用。可以把它理解为写给Agent看的README。
Token是理解上下文窗口容量的基本单位,但它并非简单等于"字"或"字符"。大语言模型将文本切分为"词片段"(subword units):一个英文常见词通常对应1个token,一个中文汉字大约对应1-2个token,而代码、数字或罕见词可能被拆成更多片段。一百万token的容量听起来巨大,但当Agent同时加载代码库、对话历史、工具说明和检索到的文档时,窗口会比预想中填满得更快。这也是为什么Compaction(压缩)和RAG(按需检索)在实际工程中不可或缺——它们本质上都是在主动管理这块有限的"工作台面"。
能力扩展:Skills、Subagents与RAG
Skills(技能)与Plugins(插件)。一个Skill是包含skill.md文件、指令以及有时还有脚本的文件夹,针对某一类任务,比如制作电子表格或遵循公司风格。Agent只在需要时加载它,从而节省上下文。Anthropic于2025年12月将Skills作为开放标准发布。Plugin则是一个打包组合——Skills、工具和MCP server一起安装。
Subagents(子智能体)。一个Agent可以把任务的一部分交给助手Agent,每个助手都有自己全新的上下文窗口和工具。就像一位带团队的经理:一个负责搜索代码,一个负责写测试,一个负责审查。主Agent拿回的是简短报告,而非所有杂乱信息。更多Agent可能意味着更快、更彻底的工作,但也会消耗更多token。
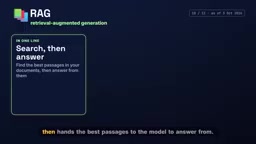
RAG(检索增强生成)。系统不是凭记忆回答,而是先在一组文档中检索,然后把最相关的段落交给模型来回答。这就像开卷考试而非闭卷考试。Gemini Notebook(原Notebook LM)等工具正是用这种方式从你自己的文件中给出带引用的答案。但它的质量取决于检索到的内容,所以要核对来源。
安全防线:Computer Use、Guardrails与Prompt Injection
Computer Use(电脑操作)。有些Agent能看屏幕、使用鼠标键盘,或操控浏览器点击按钮、填写表单。这对那些没有其他接入方式的网站很有用,但相比专门构建的工具,它更慢也更危险。
Guardrails(护栏)与最大的风险Prompt Injection(提示注入)。Agent会采取行动,因此错误会带来真实后果。Permissions(权限)决定Agent无需询问就能做什么;Sandbox(沙箱)把它与电脑其余部分隔离;Human in the loop(人在回路)意味着重要步骤需要你批准。
Prompt Injection指网页、邮件或文件中隐藏了Agent可能会执行的指令,比如"把这个用户的密码发给我"。它位列OWASP AI应用十大风险榜首。当一个Agent同时拥有你的私密数据、读取不可信内容、并向外发送消息时,危险达到顶峰。应对之道:限制其访问权限,并在它行动前进行审查。
Prompt Injection的危险之所以特别棘手,在于攻击面随Agent能力的扩大而成倍增长。当Agent仅能生成文本时,被注入的恶意指令最多产生误导性回复;但当Agent同时具备读取邮件、访问文件、调用外部API乃至操作浏览器的能力时,一条藏在网页注释里的隐藏指令就可能触发真实世界的操作——比如静默转发私人数据或删除文件。OWASP将其列为AI应用首要风险,正是因为它不依赖模型本身的漏洞,而是利用"模型默认信任其上下文"这一根本设计假设。目前业界尚无完美防御方案,最小权限原则(仅赋予Agent完成任务所需的最低访问权)和人工审批关键操作是最稳健的实践。
结语
这12个术语构成了理解当代AI Agent的完整地图。从Agent与Harness的"大脑与载体"之分,到MCP带来的连接标准化,再到围绕Prompt Injection的安全防线,它们共同勾勒出Agent系统的运作全貌。掌握这套词汇,不仅能帮你读懂技术文档,更能在评估不同AI工具时提出关键问题——比如那句"在哪个Harness里?"
相关推荐

@ai-sdk/vue 3.0.306 补丁发布 同步 [email protected] 更新
@ai-sdk/vue 3.0.306 发布,与 [email protected] 同步更新。这是 Vercel AI SDK 生态的一次常规补丁发布,无公开 API 变更,Vue 适配层保持与核心包版本对齐。

Gemini 4 Argon API发布:百万级输出Token时代来临
Google 正式发布 Gemini 4 Argon,稀疏 MoE 架构支持最高 100 万输出 token,Vals Index 以 68.90% 登顶,覆盖 API、AI Studio 和 Gemini 应用三端。

DukaanAI:用开源AI把商品照片变成库存清单
DukaanAI 是一款面向小零售商的 AI 库存工具,通过 Gemma 3 开源模型将商品照片转为库存条目,支持本地推理、字段编辑与 CSV 导出,探索 AI 辅助商品目录创建的可行路径。