多模态RAG的接地幻觉:视觉语言模型如何权衡图文证据

GIB-200K揭示VLM在图文证据冲突时并非理想贝叶斯观察者,存在系统性加权偏差。
研究构建 GIB-200K 数据集,系统测试视觉语言模型在多模态 RAG 中融合文本与图像证据的能力。数据集基于 COCO 和 Visual Genome,覆盖难负例检索噪声、视觉退化与跨模态冲突等压力条件。四个开源模型在干净输入上准确率达 92.5%-94.2%,对抗条件下骤降至 41.3%-59.9%。借助理想贝叶斯线索组合理论,研究定义了知识惯性与感官捕获两类偏差:LLaVA 模型过度加权文本(权重比 1.229、1.322),InternVL3 则偏向图像(0.680)。当文档撒谎时,34.8%-71.4% 的正确干净答案被放弃。免训练一致性检查在图像严重退化时同样失效,说明单一缓解策略难以覆盖所有失败模式。
引言:当检索增强遇上视觉语言模型
检索增强生成(RAG)已成为提升大模型事实性的常用手段,但当 RAG 遇上视觉语言模型(VLM),问题变得复杂:模型需要同时权衡两种可能出错的证据——检索到的文本可能错误或充满噪声,图像本身也可能模糊、低分辨率甚至与文本矛盾。一项新研究通过构建 GIB-200K 数据集,系统性地追问:VLM 究竟如何组合这两类证据?它们是否像一个理想的贝叶斯观察者那样,根据各自的可靠性动态调整权重?
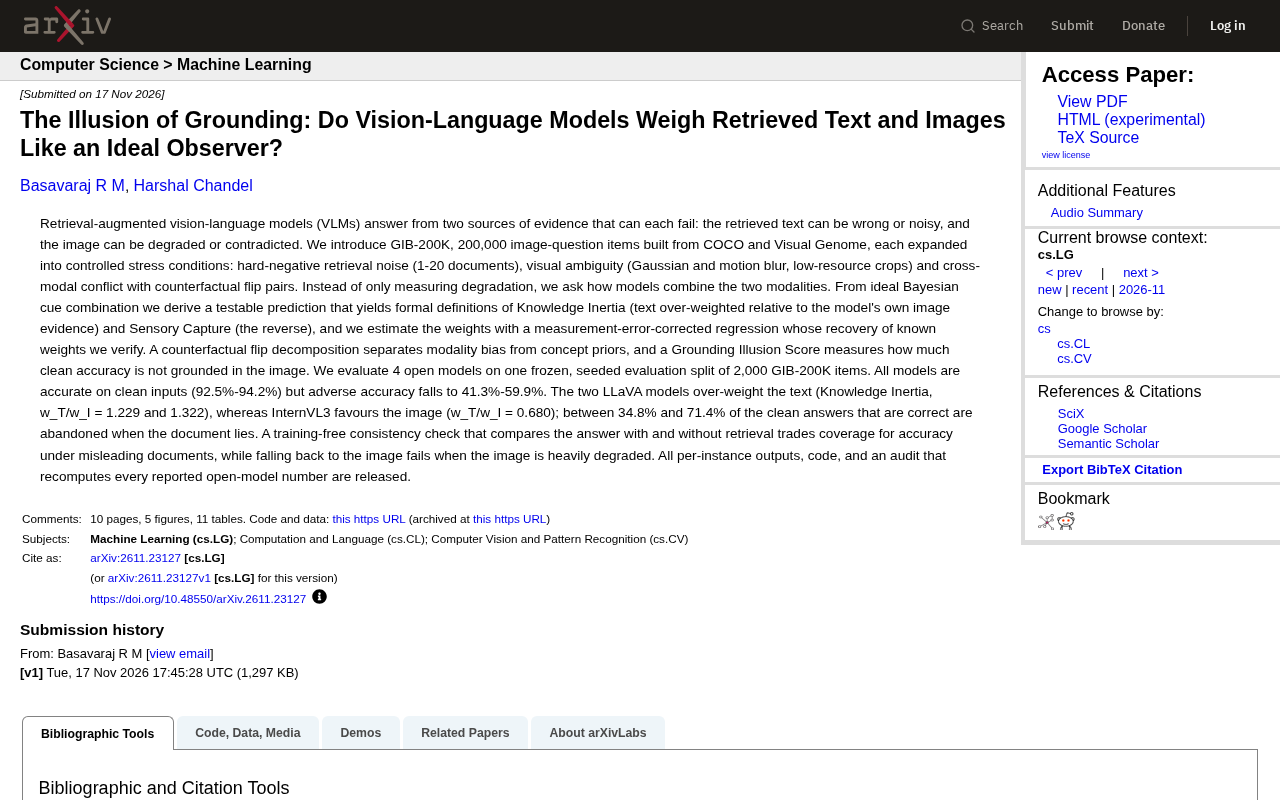
研究给出的初步答案是令人警醒的:所有被测模型在干净输入上准确率高达 92.5%-94.2%,但在对抗条件下骤降至 41.3%-59.9%。更关键的是,模型对图文证据的加权方式存在系统性偏差,并非理想观察者。
视觉语言模型(VLM) 是一类能同时处理图像与文本输入的多模态模型,典型代表包括 LLaVA、InternVL 等。它们通常由视觉编码器(如 CLIP 的 ViT)将图像映射为视觉 token,再经由投影层接入大语言模型的输入序列,从而让语言模型"看到"图像并据此作答。与纯文本大模型不同,VLM 的答案同时依赖视觉感知与语言先验,因此在图文信息不一致时,其决策过程更难预测。这正是多模态 RAG 与纯文本 RAG 的核心差异:后者只需权衡检索文本与参数化知识,前者则要在检索文本、图像证据和语言先验三者之间分配信任,出错来源也因此成倍增加。
GIB-200K:为接地能力设计的压力测试集
数据集构建与压力条件
研究团队基于 COCO 和 Visual Genome 构建了 20 万条图文问答样本,每条样本都被扩展为多种受控压力条件:1-20 篇文档的难负例检索噪声、高斯模糊与运动模糊等视觉退化、低资源裁剪,以及带有反事实翻转对的跨模态冲突场景。这种设计不只测量性能下降,更试图揭示模型内部的证据融合机制。
从理想观察者到可检验的指标
研究者从理想贝叶斯线索组合理论出发,推导出一个可检验的预测,并据此定义了两种偏差:知识惯性(Knowledge Inertia)指文本相对模型自身图像证据被过度加权;感官捕获(Sensory Capture)则是反向情况。通过误差校正回归估计权重,并用已知权重验证了估计方法的恢复能力。反事实翻转分解进一步将模态偏差与概念先验分离,而接地幻觉分数(Grounding Illusion Score)则衡量有多少干净准确率并未真正基于图像。
理想贝叶斯观察者是认知科学与多感官整合研究中的经典基准模型。它假设观察者面对多个独立且带噪声的证据源时,会按照各来源的可靠性(即方差的倒数)为其分配权重,从而得到方差最小的最优融合估计。在文本与图像两类证据的语境下,理想观察者意味着:文本越可靠、图像越模糊,就越应信任文本,反之亦然。以这一理论为参照,研究者可以把"模型的实际加权"与"理论最优加权"作对照,把偏差量化为可检验的假设,而不是停留在"模型偏向某模态"的定性描述上。知识惯性与感官捕获正是相对这一基准定义的两类系统性偏离。
反事实翻转对是一种用于分离模态偏差与概念先验的实验设计。其思路是:对同一图文样本构造一对仅在某一方面发生受控改变的版本(例如翻转答案概念,或替换关键证据),观察模型输出是否随之翻转。若模型在证据改变后仍坚持原答案,说明其判断更多来自参数中固化的概念先验而非当前输入;若输出随证据同步变化,则说明模型确实在接地。通过比较翻转前后的一致性,研究者能把"依赖先验"与"依赖证据"两种成分拆开,从而更准确地归因模型在多模态 RAG 中的失败来源。
实测结果:模型间的显著分歧
干净输入下的高分与对抗条件下的崩塌
在 2000 条固定随机种子的评估集上,四个开源模型全部在干净输入上表现优异,准确率介于 92.5% 至 94.2%。然而一旦引入检索噪声或视觉退化,准确率便跌至 41.3%-59.9%。这种断崖式下降说明,模型在干净基准上的高分很大程度上掩盖了其证据融合能力的脆弱性。
知识惯性与感官捕获:模型各有偏向
权重估计揭示了模型间的显著差异:两个 LLaVA 模型表现出知识惯性,文本与图像权重比分别为 1.229 和 1.322,即过度依赖检索文本;而 InternVL3 则偏向图像,权重比为 0.680。更值得警惕的是,当文档撒谎时,34.8% 至 71.4% 原本正确的干净答案被模型放弃。这意味着检索增强在某些情况下反而会破坏模型已有的正确判断。
缓解策略的局限与开放审计
研究还测试了一种免训练的一致性检查:比较有无检索时的答案,以在误导性文档下用覆盖率换准确率。但当图像严重退化时,回退到图像策略同样失效。这提示单一策略难以覆盖所有失败模式。所有逐实例输出、代码以及可复算每个开源模型数字的审计脚本均已公开,为后续研究提供了可验证的基础。
免训练的一致性检查属于推理时干预手段,不修改模型参数,而是在生成阶段比较不同输入配置下的输出是否自洽。此处具体做法是:分别在有检索文档和无检索文档的条件下让模型作答,若两者不一致,则对检索结果的可信度存疑。这类方法的优势是部署成本低、无需标注数据;局限在于它把"一致性"当作"正确性"的代理,当图像本身退化时,两次推理可能同时出错,一致性检查便失去判别力。开放审计(公开逐实例输出与可复算脚本)则是针对这类评测的可复现性要求,使他人能够独立重算每个数字、检验结论是否稳健。
对多模态RAG实践的启示
这项研究的意义超出基准测试本身。它提醒开发者,多模态 RAG 系统的可靠性不能只看干净输入下的准确率,而应评估模型在证据冲突时的加权逻辑。知识惯性和感官捕获提供了可量化的诊断工具,接地幻觉分数则可用于审计系统是否真正“看图说话”。在部署检索增强的视觉问答系统时,需要针对文本噪声和图像退化分别设计鲁棒性策略,而非假设模型会像理想观察者那样自动校准信任。
相关推荐

Gemini 4 Neon 曝光:或成 Opus 5.5 有力竞争者
Hacker News 讨论帖指出 Gemini 4 Neon 看起来像 Opus 5.5 的竞争者。本文解读这一社区信号背后的产品定位、顶级模型竞争格局变化,以及对开发者模型选型策略的实际意义。

Claude Fable 5.2 独立创作短片《Fable》引热议
Hacker News 上出现由 Claude Fable 5.2 独立完成剧本、画面与导演的短片《Fable》,本文分析全流程 AI 创作的意义、社区反应及对内容创作者的启示。

Anthropic IPO定价:AI巨头上市信号
Anthropic 进行 IPO 定价的消息引发关注。本文分析这一动作对 AI 行业估值、商业化路径和竞争格局的潜在影响,并指出公开市场对 AI 公司的期待与挑战。