多智能体系统安全新突破:SecMAS防御响应操纵攻击
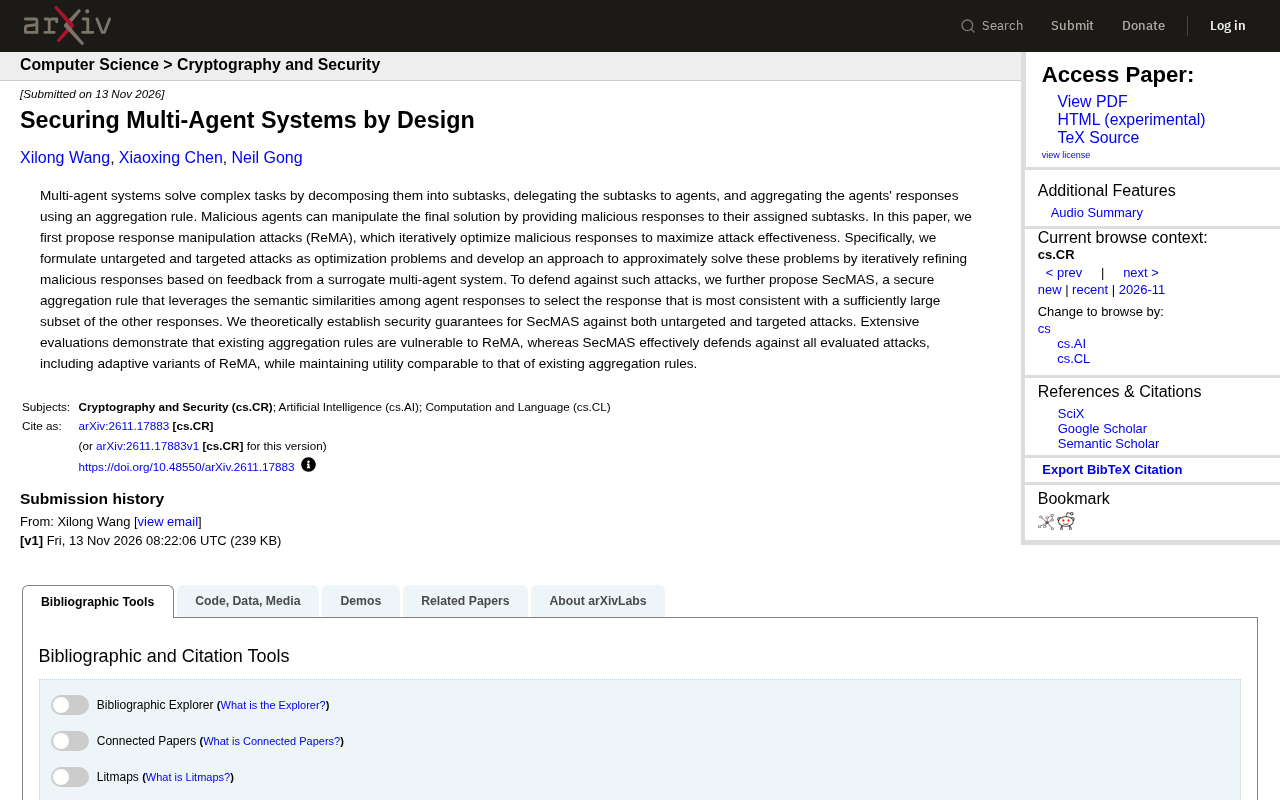
论文提出响应操纵攻击ReMA,并设计基于语义相似性的SecMAS聚合规则实现安全防御。
文章介绍了一篇关于多智能体系统(MAS)聚合环节安全的研究。MAS 通过任务分解与结果聚合处理复杂问题,但每个智能体的输出都可能影响最终决策,恶意智能体因此可提供恶意响应操纵最终解。研究者提出响应操纵攻击 ReMA,将无目标与有目标攻击分别建模为优化问题,借助替代系统的反馈迭代精炼恶意响应,无需掌握系统内部细节即可实施。为防御该攻击,论文提出 SecMAS 聚合规则,利用响应间的语义相似性,选择与足够大响应子集最一致的响应作为输出,并从理论上证明了其对两类攻击的安全保证。实验显示现有聚合规则普遍脆弱,而 SecMAS 能抵御包括自适应变体在内的所有评估攻击,同时保持与现有规则相当的效用。
多智能体系统通过任务分解与结果聚合来解决复杂问题,但其分布式特性也引入了新的攻击面。近期一篇论文提出了响应操纵攻击(ReMA),并设计出SecMAS聚合规则以抵御此类威胁。
多智能体系统的脆弱性:响应操纵攻击
多智能体系统(MAS)将复杂任务拆解为子任务,交由多个智能体处理,再通过聚合规则汇总结果。这种架构提升了任务处理的并行性和灵活性,但也意味着每个智能体的输出都可能影响最终决策。论文指出,恶意智能体可以通过向分配的子任务提供恶意响应来操纵最终解。
为此,研究者提出了响应操纵攻击(ReMA)。该攻击通过迭代优化恶意响应,以最大化攻击效果。具体而言,研究者将无目标攻击和有目标攻击分别建模为优化问题,并基于替代多智能体系统的反馈,迭代精炼恶意响应以近似求解这些问题。这种攻击方式不依赖对系统内部细节的完全掌握,具有现实可行性。
**无目标攻击(untargeted attack)与有目标攻击(targeted attack)**是对抗攻击研究中的标准分类。无目标攻击只要求最终输出偏离正确解或使系统失效,不指定具体结果;有目标攻击则要求系统输出攻击者预设的特定答案。二者对攻击者的能力要求不同,防御难度也不同——有目标攻击需要更精细地控制响应内容,但也带来更严重的后果。论文将两类攻击分别建模为优化问题,正是为了在同一框架下统一衡量聚合规则在两种威胁模型下的鲁棒性。
基于替代系统的反馈迭代优化借鉴了黑盒对抗攻击中的迁移攻击思路。攻击者并不直接访问目标多智能体系统的聚合规则或内部提示,而是先构建一个结构相似的替代系统,在其上反复提交候选恶意响应、观察聚合结果并据此更新响应,使恶意响应逐步逼近能操纵目标系统的形态。由于不同 MAS 在任务分解和聚合逻辑上往往同构,在替代系统上优化得到的响应具有可迁移性,这解释了为何该攻击不依赖对系统内部细节的完全掌握仍具现实可行性。
SecMAS:基于语义相似性的安全聚合规则
为防御ReMA攻击,论文提出了SecMAS——一种安全的聚合规则。其核心思想是利用智能体响应之间的语义相似性,选择与足够大的响应子集最一致的响应作为最终输出。这意味着恶意响应若要与多数响应保持一致,就必须在语义上伪装得极为巧妙,从而大幅提高了攻击难度。
研究者从理论上证明了SecMAS对无目标攻击和有目标攻击均具备安全保证。这种形式化保证为安全聚合规则的设计提供了理论基础,使其不仅在实际评估中有效,在理论层面也有支撑。
语义相似性在此处指通过文本嵌入(text embedding)将智能体响应映射为高维向量后,用余弦相似度等度量计算响应之间的接近程度。SecMAS 并非比较字面措辞,而是比较语义向量,因此改写过、措辞不同但含义相近的响应会被视为一致。
「与足够大的响应子集最一致」这一准则的关键在于阈值:只有当某个响应的语义邻域中包含超过一定比例的智能体响应时,它才可能被选为输出。这一机制隐含的假设是诚实智能体在语义上趋于一致,而恶意响应难以在不被语义相似度捕获的情况下与多数派对齐,这正是其安全保证的来源。
实验评估:有效防御与效用保持
大量评估表明,现有的聚合规则在面对ReMA攻击时表现出脆弱性,而SecMAS能够有效防御所有评估过的攻击,包括ReMA的自适应变体。更关键的是,SecMAS在提供安全性的同时,保持了与现有聚合规则相当的效用水平。这意味着安全性的提升并未以牺牲系统性能为代价,这对于实际部署至关重要。
该研究揭示了多智能体系统在聚合环节的安全隐患,并给出了一种兼顾安全与效用的设计思路。随着多智能体系统在复杂任务中的应用日益广泛,这类“设计即安全”的方法将为系统构建者提供重要参考。
相关推荐

AI代打电话?Muse让语音助手替你预约
Muse推出AI代打电话功能,仅限美国付费订阅用户。本文分析语音助手切入电话场景的产品逻辑、付费墙策略与语音代理的想象空间及隐私隐忧。
谷歌PaperOrchestra:多智能体框架自动化写AI论文
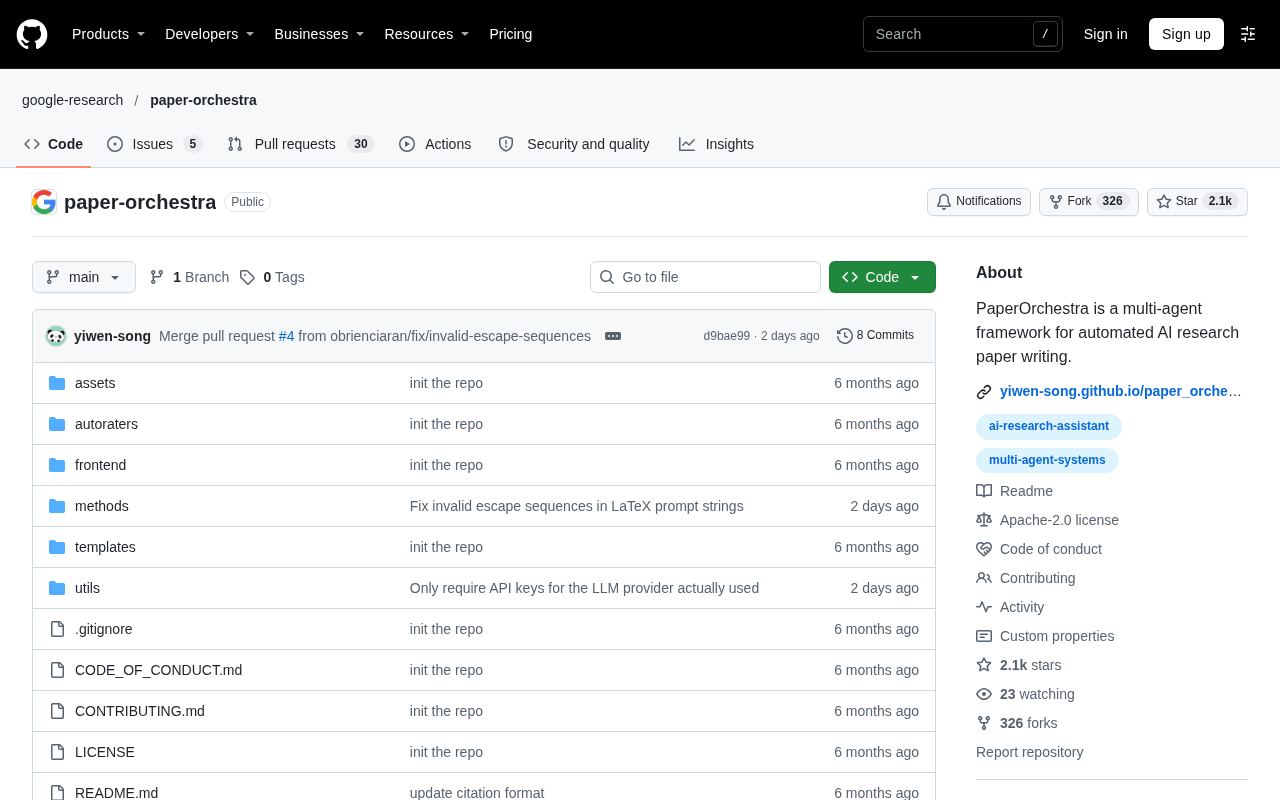
谷歌研究院开源 PaperOrchestra 多智能体框架,将 AI 研究论文写作拆解为文献、方法、实验等子任务,由不同智能体协作编排完成,GitHub 已获 2093 星,今日新增 313 星。

Marimba:0.6B小模型如何用单一编码器处理语音问答
Marimba 是一个基于 Qwen3-ASR-0.6B 编码器的轻量语音问答模型,支持流式处理、本地运行,可作为轮次检测器接入 Pipecat、LiveKit 和 Vapi,在特定任务上超越大模型。