多智能体协作为何远难于单智能体?

多智能体协作因通信成本、错误级联、涌现行为和工具缺失而远难于单智能体。
文章围绕“多智能体协作为何远难于单智能体”展开,指出单智能体虽路径清晰、可控,但面临跨领域知识和长程规划的天花板。多智能体之难体现在四个维度:通信与协调成本随智能体数量指数上升、上游错误级联传播且责任归因困难、交互涌现行为难以预测、评估与调试工具缺失。作者进一步类比分布式系统的一致性与拜占庭故障问题,但强调LLM智能体的概率性行为使传统工程手段失效。实践上建议限定角色数量、采用结构化通信协议、可观测性优先并分层评估。
多智能体协作为何远难于单智能体?
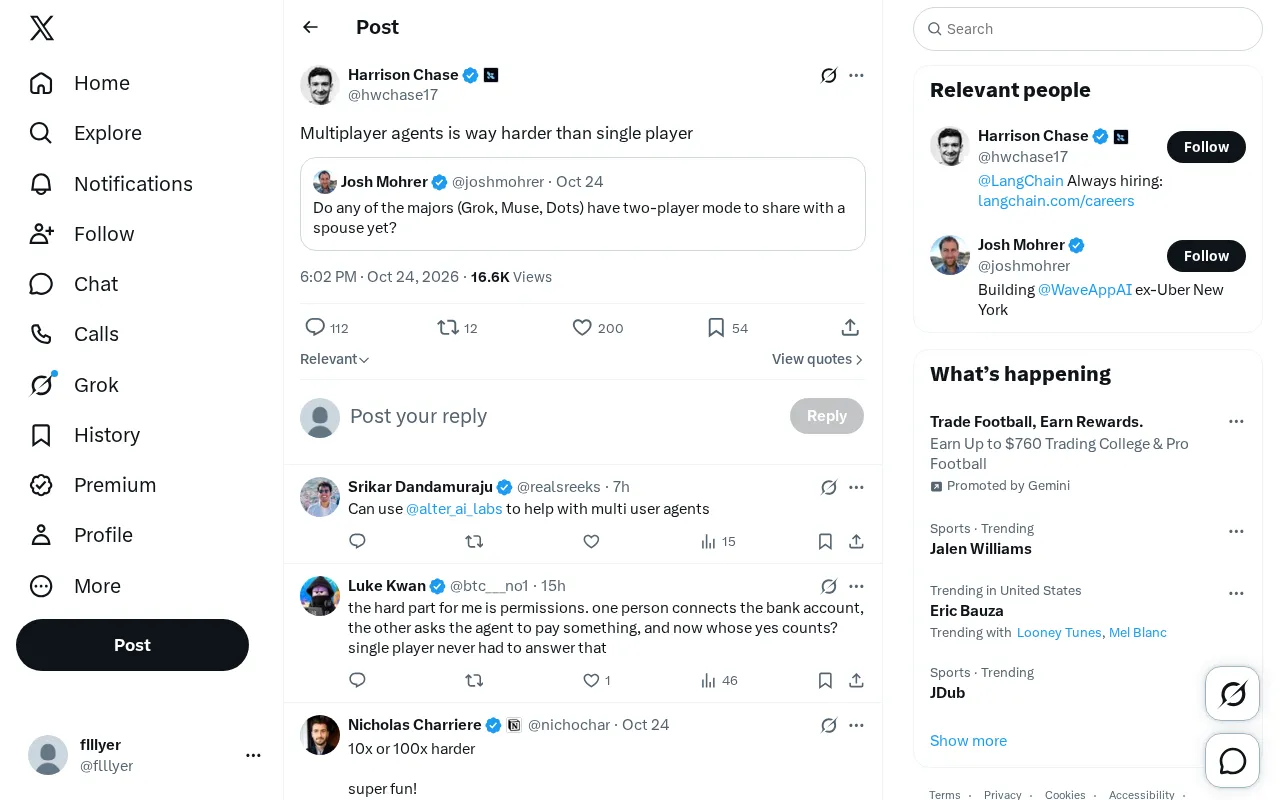
在AI智能体(Agent)开发领域,一个逐渐浮现的共识是:让多个智能体协同工作,远比构建一个强大的单智能体要困难得多。最近,一位开发者在Twitter上发出感叹——“Multiplayer agents is way harder than single player”,直指多智能体系统(Multi-Agent Systems)带来的复杂挑战。这并非孤例,而是许多从业者在从单智能体原型走向多智能体规模化时的共同痛点。
单智能体:可控但天花板明显
单智能体架构的优势在于路径清晰。一个模型、一套提示词、一条执行链,开发者可以端到端地追踪推理过程、调试行为、评估输出。像AutoGPT、BabyAGI等早期项目,虽然暴露了循环失控、目标漂移等问题,但至少问题边界相对明确。
单智能体的天花板同样显著:当任务需要跨领域知识、长程规划或并行探索时,单一模型容易陷入局部最优,或者因上下文窗口限制而丢失关键信息。这催生了多智能体的构想——让不同角色分工协作,模拟人类团队的工作方式。
多智能体之难:四个维度
1. 通信与协调成本指数上升
多智能体系统不是简单地把N个单智能体拼在一起。每增加一个智能体,就新增一条通信链路和潜在的误解点。智能体之间的消息传递需要协议、格式约定和语义对齐,而自然语言本身充满歧义。一个智能体说“完成了”,另一个可能理解为“任务关闭”或“部分完成”,这种语义漂移在链式协作中会被放大。
2. 错误传播与级联失效
单智能体的错误通常可被开发者定位在单条轨迹上。而在多智能体系统中,一个上游智能体的幻觉或错误决策会作为下游智能体的输入,导致错误逐层扩散。更棘手的是,当最终结果出错时,责任归因变得极其困难——是规划者目标定义有误,还是执行者理解偏差,或是协调者的调度失误?
3. 涌现行为难以预测
多智能体交互常常产生设计者未预料到的涌现行为(emergent behavior)。一些行为可能有益,比如自发的分工优化;但更多时候表现为冗余讨论、死循环、或者智能体之间相互“踢皮球”。由于系统行为不是单个智能体行为的简单叠加,传统单元测试和回归测试难以覆盖这些交互场景。
涌现行为(Emergent Behavior) 原是复杂系统科学中的核心概念,指大量个体遵循简单局部规则交互后,在系统整体层面自发产生的、无法从单个个体行为直接推导的新模式,典型例子如鸟群编队、蚁群觅食路径。在多智能体系统中,每个智能体基于自身提示词和目标独立决策,但它们的消息往来会形成反馈回路,从而催生出设计者未编码的集体行为。与自然界涌现不同,LLM智能体的涌现往往源于语义误解的累积和相互强化,因此更难通过分析单个智能体的逻辑来预判。这也意味着,多智能体系统的测试不能只覆盖单体行为,而需要引入交互回放、压力注入等针对“集体动力学”的评估手段。
4. 评估与调试工具的缺失
当前可观测性工具大多为单模型调用设计,缺乏对多智能体对话流、状态同步和决策依赖的可视化支持。开发者往往只能靠日志回放手动梳理,效率低下。这也解释了为什么许多团队在演示阶段能跑通多智能体流程,但一旦进入生产环境就问题频发。
可观测性(Observability) 在软件工程中指通过日志、指标和追踪等外部输出来推断系统内部状态的能力。对于多智能体系统,可观测性面临三重特殊挑战:其一,智能体间的自然语言对话是半结构化数据,难以像传统日志那样直接聚合统计;其二,一次任务涉及多个智能体的多轮交互,需要分布式追踪(distributed tracing)来还原跨智能体的因果链;其三,智能体的决策依赖上下文,同样的消息在不同对话历史下含义不同。因此,面向多智能体的可观测性工具不仅要记录“发生了什么”,还要捕获“当时智能体看到了什么上下文”,才能支持有效的调试与归因。
与分布式系统难题的相似性
多智能体协作面临的挑战,与经典分布式系统有着惊人的相似:一致性问题、容错与重试、消息顺序、以及拜占庭故障(部分智能体给出错误信息)。区别在于,传统分布式节点的行为是确定性的,可以形式化验证;而基于大模型的智能体行为是概率性的,同一输入可能产生不同输出,这让传统的工程手段难以直接套用。
一位在Twitter上分享经验的开发者指出,多智能体系统需要引入类似“共识机制”和“角色边界”的设计,但这又会增加协调开销,形成新的权衡。
拜占庭故障(Byzantine Fault) 源自分布式系统理论中的“拜占庭将军问题”,指系统中部分节点可能以任意方式失效——不仅会停止响应,还可能主动发送错误或矛盾的信息,且这些节点的行为不可信。在传统分布式系统中,拜占庭容错算法(如PBFT)通过多轮投票与消息签名来达成共识。映射到多智能体场景,一个产生幻觉的LLM智能体就类似于拜占庭节点:它并非简单地“宕机”,而是自信地输出看似合理却错误的内容,下游智能体难以仅凭文本判断其可靠性。这使得多智能体系统在设计投票、仲裁或交叉验证机制时,必须额外考虑如何识别和隔离这类“语义层面的拜占庭错误”,而不仅仅是网络层的消息篡改。
实践路径:从简单场景切入
尽管困难重重,多智能体仍是值得探索的方向。务实的做法包括:
- 限定智能体数量与角色:从两到三个角色开始,避免角色职责重叠。
- 结构化通信协议:用显式的JSON schema或函数调用替代自由文本对话,降低语义歧义。
- 可观测性优先:在系统设计初期就接入对话追踪和中间状态记录,而不是事后补救。
- 分层评估:既评估最终输出,也评估每个智能体的中间产出质量,便于定位失效环节。
结语
“Multiplayer agents is way harder than single player”这句简短的感叹,点出了AI智能体从单体走向协作时真实存在的工程鸿沟。多智能体的价值没跑了——它能处理单智能体难以胜任的复杂任务——但它的难度提醒我们:协作不是免费的,协调成本、错误传播和涌现行为都需要新的工程范式来应对。对于正在构建智能体系统的团队而言,理解这些困难本身,就是迈向可靠多智能体系统的第一步。
相关推荐

单卡12G跑本地实时语音AI:35B模型+语音对话全流程
国外开发者展示如何在单张12GB显卡上本地运行35B MoE语言模型、Whisper语音识别与Breeze TTS2语音合成,通过流式转录、并行合成与量化优化,将端到端语音对话延迟从8秒降至2-3秒,并接入Agent工具调用场景。

Qwen4架构预览已开源:125B参数、512专家,专为显存受限硬件设计
Qwen4尚未发布但架构已通过Qwen3.8 Flash Next开源预览:125B参数、每Token激活6B、512专家、262K上下文,专为显存受限硬件设计。本文梳理官方确认信息、config.json关键指标及24G内存本地部署实测。

6G显存跑8K图!复旦开源MOSS-Image生图模型实测
复旦OpenMouse团队与上海摩斯智能开源MOSS-Image生图模型,5亿参数DT架构,6G显存即可本地跑图,文字渲染精准、支持结构化布局控制与4K Tokens长提示词,适合电商海报与个人创作者本地部署。