EEG-to-text新突破:分层对齐实现句子级思维解码

论文提出分层对齐框架,用轻量EEG实现句子级文本检索,厘清检索与生成的选择。
文章介绍了一项脑机接口新研究:针对闭锁综合征等沟通障碍患者,现有高精度脑到文本方案依赖笨重的fMRI和MEG,而轻便廉价的EEG解码性能不足。该论文提出分层对齐框架,在多个层级上对齐EEG与语言表示,聚焦句子级分类/检索任务——即利用上下文和脑电信号从候选集中检索被试阅读的句子,而非直接生成文本。文章分析了句子级解码的难点、句子分类与生成研究的不均衡,指出该工作把焦点拉回句子级并坚持轻量模态,虽距开放生成仍有距离,但厘清了基础问题,是EEG-to-text实用化的重要一步。
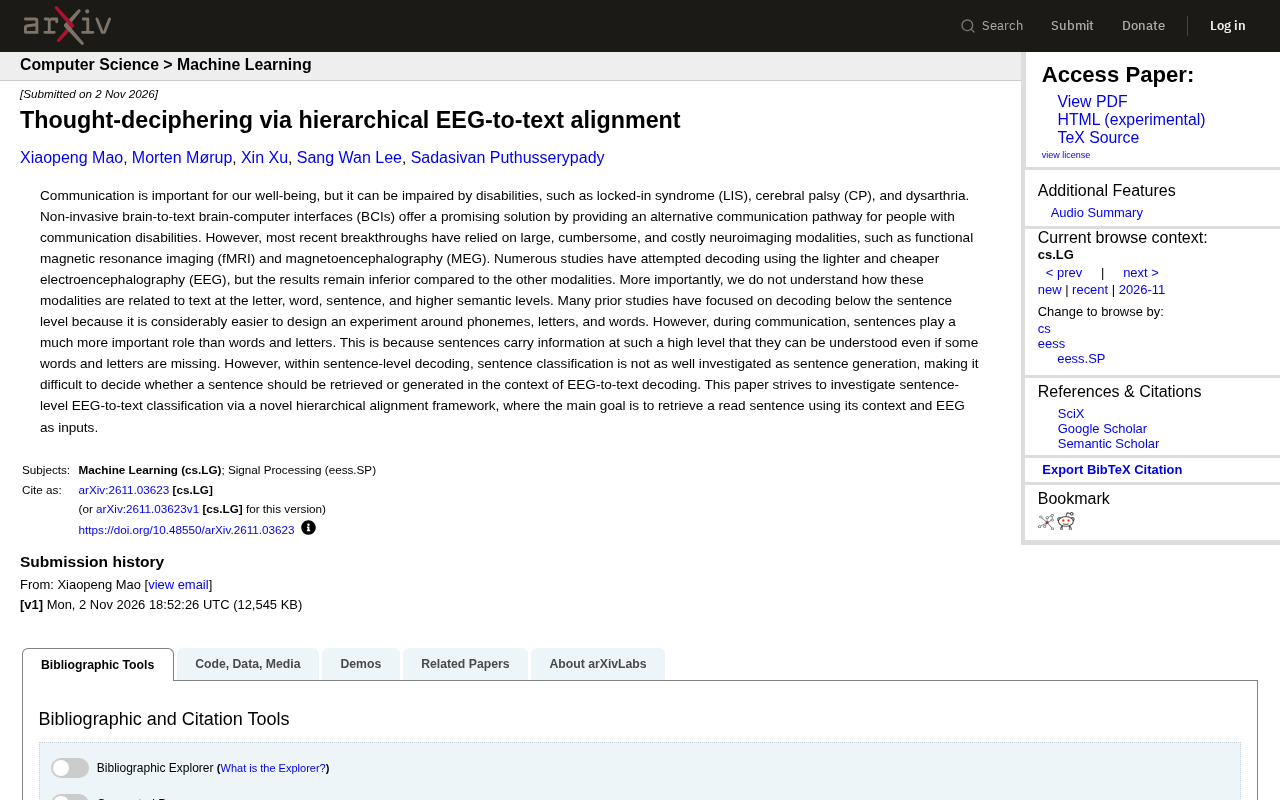
脑机接口(BCI)为闭锁综合征、脑瘫和构音障碍等沟通障碍患者提供了替代沟通路径,但非侵入式脑到文本解码长期受限于设备笨重与精度不足。近期一篇论文提出分层对齐框架,试图在更轻量的脑电(EEG)信号上实现句子级文本检索,为实用化思维解码开辟了新思路。
为什么句子级解码是脑机接口的“硬骨头”
现有高精度脑到文本方案大多依赖功能磁共振(fMRI)和脑磁图(MEG),这些设备体积大、成本高、使用场景受限。相比之下,EEG 轻便廉价,但解码性能一直落后。更关键的是,研究界对脑信号与文本在字母、单词、句子及更高语义层级上的对应关系仍缺乏清晰理解。
大量前期工作集中在句子层级以下,因为围绕音素、字母和单词设计实验要容易得多。然而在真实沟通中,句子的重要性远超单词和字母——即使缺失部分词汇或字母,听者仍能理解整句含义。句子携带的高层信息使其成为沟通的核心单元,但 EEG 场景下的句子级解码研究并不充分。
fMRI 与 MEG 的精度优势来源:功能磁共振(fMRI)测量血氧水平依赖信号,空间分辨率可达毫米级,能精确定位大脑活动区域;脑磁图(MEG)则直接捕捉神经元电流产生的磁场,时间分辨率在毫秒级。两者结合可同时获得高空间与高时间分辨率,因此能较可靠地解码复杂语言信息。但其设备需屏蔽室、液氦冷却或大型超导量子干涉装置,单台成本数百万美元,且要求被试保持头部绝对静止,难以日常佩戴。EEG 通过头皮电极记录神经电活动的宏观总和,设备仅数百美元、可便携佩戴,但信号经颅骨衰减后空间分辨率降至厘米级,且易受眼动、肌电干扰,信噪比低,这正是 EEG 解码性能长期落后的物理根源。
句子分类 vs. 句子生成:一个被忽视的选择
在句子级解码内部,研究热度并不均衡。句子生成(generation)受到的关注远多于句子分类(classification),这导致一个基础问题悬而未决:在 EEG-to-text 解码中,究竟应该从候选集中检索一个句子,还是让模型生成一个句子?
论文明确将目标锁定在句子级分类任务上,即利用上下文和 EEG 信号从候选中检索被试阅读的句子。这一选择避开了生成模型可能引入的幻觉问题,也让评估更可控。
生成模型中的“幻觉”问题:在脑到文本生成任务中,模型需根据脑信号逐词解码出完整句子。由于 EEG 信号噪声大、信息量有限,生成模型(尤其是基于大语言模型的解码器)容易输出与脑信号无关但语言上通顺的内容,即“幻觉”。在脑机接口场景下,幻觉意味着输出患者并未意图表达的语句,可能造成严重误沟通甚至安全风险。而句子检索/分类任务将输出限制在预设候选集内,模型只需判断哪个候选与脑信号最匹配,错误被约束在候选范围内,评估指标(如 top-k 检索准确率)也更客观可复现。因此,论文选择检索而非生成,是在当前信号质量下优先保证可靠性的务实策略。
分层对齐框架如何工作
该研究的核心创新是分层对齐(hierarchical alignment)。传统方法往往在单一粒度上对齐脑信号与文本,而分层框架试图在多个层级上建立 EEG 与语言表示的对应关系,从而更充分地利用句子中的语义信息。
论文的主目标是“用上下文和 EEG 作为输入,检索出被试阅读的句子”。这意味着模型不仅要处理脑电信号本身,还要结合语言上下文来缩小候选范围。这种设计更贴近真实沟通场景——沟通天然依赖上下文,而非孤立词汇。
多粒度对齐的含义:分层对齐借鉴了对比学习中的多层级表示思想。具体而言,模型可能同时在词级、短语级和句子级提取 EEG 特征与文本特征,并分别施加对齐损失,使脑信号表示在不同抽象层次上与语言表示靠近。这与仅在句子级做单一对比不同:词级对齐提供更细的监督信号,缓解句子级样本少、信号噪声大的问题;句子级对齐则确保整体语义一致。这种设计让模型在检索时能综合利用局部词汇线索与全局语义线索,而非依赖单一粒度。类似思路在语音-文本、图像-文本跨模态检索中已被验证有效,但在 EEG-文本领域尚属新尝试。
对实用化脑机接口的意义
这项工作的价值体现在两个层面。方法上,它把研究焦点从单词级拉回句子级,并提出了可操作的分层对齐思路;应用上,它坚持使用 EEG 这一轻量模态,若能缩小与 fMRI/MEG 的差距,将大幅降低脑机接口的使用门槛。
当然,论文目前聚焦于句子分类/检索而非开放生成,距离自由沟通仍有距离。但厘清“检索还是生成”这一基础问题,本身就是 EEG-to-text 走向实用化不可跳过的一步。
常见问题
Q:这项研究用了什么脑信号? A:研究使用脑电图(EEG),强调其轻便、低成本的优势,而非 fMRI 或 MEG。
Q:分层对齐解决什么问题? A:在多个层级上对齐 EEG 与文本表示,以更好地利用句子级语义信息完成检索。
Q:句子分类和句子生成有何区别? A:分类是从候选中检索句子,生成是让模型产出文本;论文选择前者以规避生成的不确定性。
相关推荐

神经网络本质是线性回归?华为300集AI课讲师用TensorFlow Playground讲透深度学习
华为300集AI深度学习教程中,讲师用TensorFlow Playground演示神经网络本质是线性回归,讲透机器学习与深度学习在特征工程上的核心差异,以及2012年大数据时代为何成为深度学习崛起的分水岭。

WorkBuddy做AI漫剧全流程:8步从零到成片
基于B站教程梳理WorkBuddy制作AI漫剧的完整八步流程:从选题策划、剧本分镜到图片资产、视频生成、配音剪辑与导出发布,并解析WorkBuddy的专家技能机制与逐个召唤专家的实操技巧,适合零基础入门。

Codex实战教程:从安装到多智能体协同
基于B站Codex实战教程,系统梳理Codex从安装配置、CLI交互、斜杠指令、AGENTS.md架构到MCP协议、多智能体协同与企业级插件开发的完整路径,帮助开发者理解AI Agent的工程化用法。