EG-RL:边缘梯度增强+强化学习,提升时序图链接预测
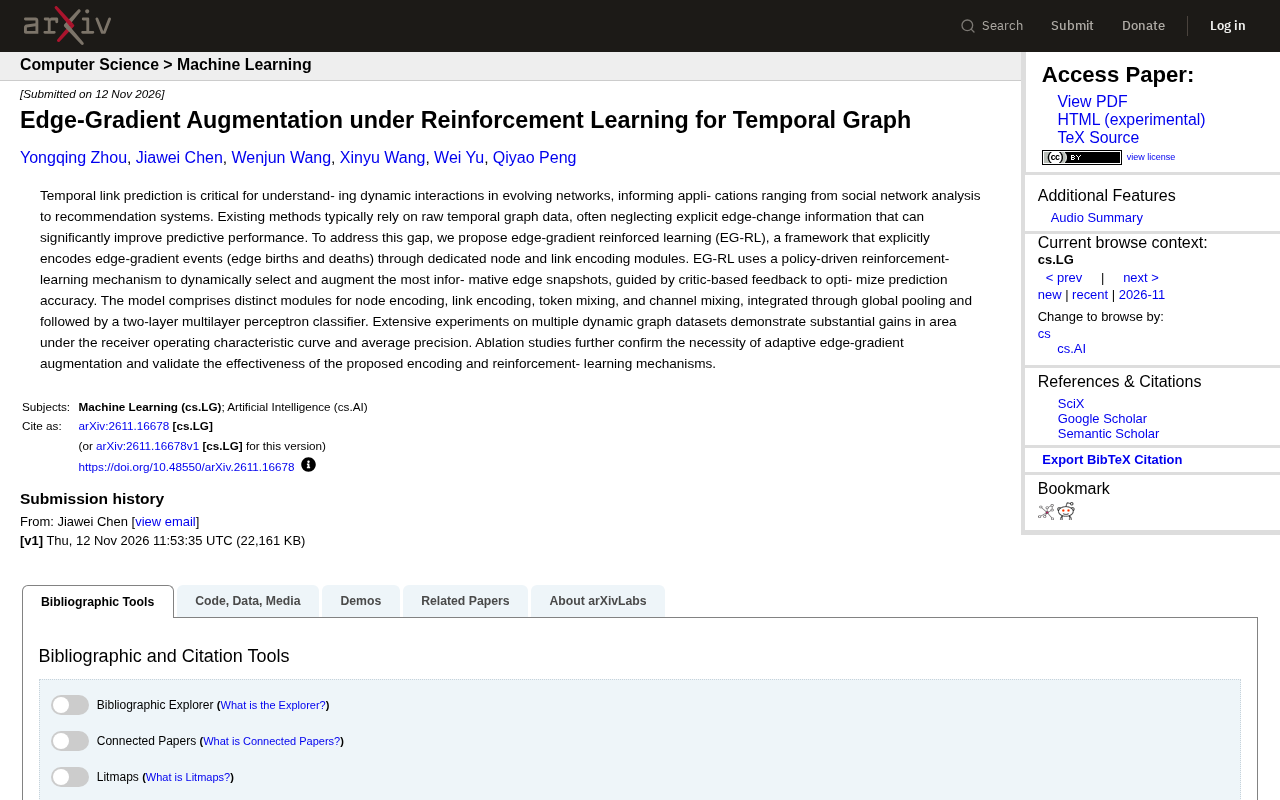
EG-RL 显式编码边的新生与消亡,并用强化学习选择关键快照提升时序链接预测。
文章介绍了一种面向时序图链接预测的边缘梯度强化学习框架 EG-RL。现有方法通常直接将原始图快照序列输入模型,隐式学习动态模式,却忽视了边的新生与消亡这类显式的边梯度事件。EG-RL 将边梯度事件作为一等信号显式编码,并采用策略驱动的强化学习机制动态选择并增强信息量最大的边快照,critic 反馈用于优化选择策略。模型由独立的节点编码、链接编码、token 混合与通道混合模块构成,经全局池化和两层 MLP 分类器输出预测。在多个动态图数据集上,AUC 与 AP 两项指标均取得显著提升,消融实验验证了自适应边梯度增强与强化学习快照选择的必要性。
时序图链接预测是理解动态网络(如社交网络、推荐系统)中节点交互的关键任务。现有方法大多直接使用原始时序图数据,却忽略了边的新生与消亡这类显式的边变化信息。一篇最新论文提出边缘梯度强化学习框架(EG-RL),通过显式编码边梯度事件并利用强化学习动态选择信息量最大的边快照,在多个动态图数据集上显著提升了预测性能。
问题:被忽视的边梯度信号
时序图的核心特征是结构随时间演化——边会诞生,也会消失。这些边梯度事件(edge births and deaths)本质上刻画了网络局部结构的动态变化,对链接预测具有直接指示意义。例如在社交网络中,一条新边的出现往往意味着新关系的建立;在推荐系统中,用户-物品交互边的消亡可能暗示兴趣转移。
然而,主流时序图学习方法通常将原始图快照序列作为输入,隐式地让模型从数据中学习变化模式,而没有显式建模边的新生与消亡。这种“隐式学习”方式容易淹没在噪声中,尤其当边变化稀疏或剧烈时,模型难以捕捉到真正关键的动态信号。EG-RL 的出发点正是填补这一空白:把边梯度事件作为一等公民进行编码。
时序图快照(Temporal Graph Snapshot) 是动态图表示中的基本单位:将连续时间轴按固定间隔(如天、小时)切分,每个时间窗口内的边集合与节点集合构成一张静态图。快照序列因此近似刻画了图的演化过程。快照粒度是一个关键超参数——粒度过粗会平滑掉短时突发的边变化,粒度过细则导致多数快照过于稀疏、噪声放大。EG-RL 所强调的“边梯度事件”正是在快照粒度之上进一步显式标记每条边的出现与消失时刻,使模型无需从稀疏的邻接矩阵差分中自行推断变化,从而缓解粒度选择带来的信息损失。
EG-RL 框架:编码、选择与增强
EG-RL 的整体设计围绕“显式编码边梯度”与“强化学习选择快照”两条主线展开。模型包含几个专门模块:节点编码模块、链接编码模块、token 混合模块和通道混合模块,最终通过全局池化汇聚信息,并接入一个两层多层感知机分类器完成预测。
节点与链接的独立编码
与将节点和边特征混在一起处理的常见做法不同,EG-RL 为节点和链接分别设计了编码模块。节点编码负责刻画节点自身的时序状态,链接编码则专门捕捉边级别的动态,尤其是边梯度事件。这种分离式设计让模型能够更清晰地分辨“节点属性变化”与“连接关系变化”,避免两类信号相互干扰。
强化学习驱动的快照选择
时序图通常包含大量快照,但并非每个快照都对当前预测同等重要。EG-RL 引入策略驱动的强化学习机制,动态选择并增强信息量最大的边快照。具体而言,策略网络根据当前状态决定哪些快照值得重点关注,而 critic 反馈则用于优化选择策略,引导模型朝着提升预测准确率的方向调整。这种“选择-增强”循环使模型能够自适应地聚焦于关键时间步,而非均匀对待所有历史信息。
策略网络与 critic 的协作机制 属于 actor-critic 框架的典型形态。此处 actor(策略网络)将当前图状态映射为一个关于候选快照的选择分布或门控权重,决定“看哪些快照”;critic 则估计该选择策略的预期回报(如链接预测的准确率或负对数似然),并据此计算优势函数来更新策略参数。由于快照选择是离散决策、不可直接求导,通常借助 REINFORCE 类梯度估计或 Gumbel-Softmax 松弛来实现端到端训练。这种设计把“选哪些历史信息”从固定的注意力权重转变为可学习的序贯决策,使模型能够随训练进程自适应调整关注的时间范围。
Token 混合与通道混合
在编码之后,EG-RL 通过 token 混合和通道混合模块进一步整合信息。token 混合负责跨节点、跨边的信息交互,通道混合则在特征维度上进行融合。这两个模块与全局池化、两层 MLP 分类器串联,形成完整的预测流水线。论文的消融实验确认了自适应边梯度增强的必要性,也验证了上述编码与强化学习机制的有效性。
Token 混合与通道混合 借鉴了 MLP-Mixer 类架构的设计哲学:将特征张量的两个维度解耦处理。token 混合在“样本/节点/边”这一维度上做信息交换,相当于让不同节点和边的表示相互注意,捕获结构层面的关联;通道混合则在特征通道维度上做逐 token 的线性变换与非线性激活,负责特征重组。二者交替堆叠,可在不依赖显式图卷积或自注意力矩阵的情况下实现全局信息整合,计算复杂度对序列长度呈线性,因而适合快照数量较多的时序图场景。
实验表现:AUC 与 AP 双提升
论文在多个动态图数据集上进行了广泛实验,评估指标为 ROC 曲线下面积(AUC)和平均精度(AP)。结果显示,EG-RL 在这两个指标上均取得显著提升。虽然原文未披露具体数值,但“substantial gains”的表述以及消融实验的支撑,表明边梯度显式编码与强化学习快照选择确实带来了实质性的性能增益。
消融研究进一步拆解了各模块的贡献:去除自适应边梯度增强后性能下降,说明边梯度事件并非可有可无的辅助信息;去除强化学习选择机制同样影响结果,印证了动态快照选择的价值。这些发现共同指向一个结论——时序图链接预测的性能瓶颈之一,在于对边变化信号的利用不足。
启示:边梯度作为时序图的一等信号
EG-RL 的价值不仅在于提出一个新模型,更在于提供了一种思路:时序图的动态性可以分解为节点状态演化和边结构变化,而后者长期被隐式处理。将边梯度事件显式编码,并借助强化学习对快照进行自适应选择,为时序图学习开辟了一条可解释性更强的路径。
当然,这一框架也带来新的问题:边梯度事件的提取成本如何?强化学习策略在超大规模图上的训练稳定性怎样?这些有待后续工作回答。但就当前结果而言,EG-RL 为时序链接预测提供了一个值得关注的方向——让模型学会“看见”边的生与死。
相关推荐

美国新车均价突破5.1万美元:AI与软件定义汽车如何推高成本
美国新车平均价格突破5.1万美元创历史新高。本文从软件定义汽车、中央计算架构、辅助驾驶传感器预埋与车端AI推理成本角度,分析AI与软件如何推高整车售价,以及这一趋势对消费者和厂商的影响。
Anthropic无预警移除Claude Code功能,开发者社区不满
Anthropic无预警移除Claude Code功能引发开发者不满。本文分析事件经过、开发者敏感原因及对AI编程工具生态的启示,探讨厂商如何平衡迭代与用户信任。
MAFM:流匹配生成中的物理约束新解法
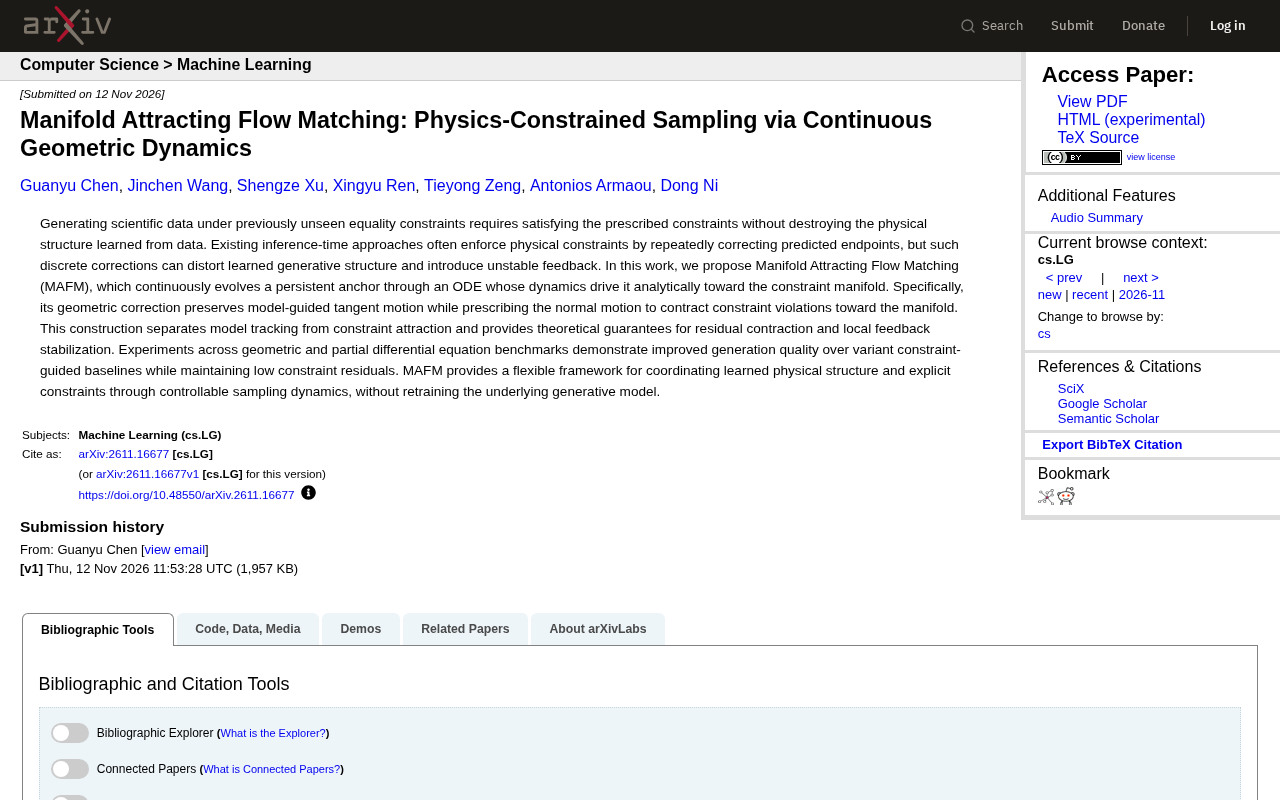
MAFM提出用连续几何动力学替代离散校正,在流匹配生成中实现物理约束满足。本文解析其切向/法向运动解耦机制、理论保证与实验表现,并讨论局限与展望。