ESP32S3集群运行1.58位BitNet语言模型:边缘AI的极致探索
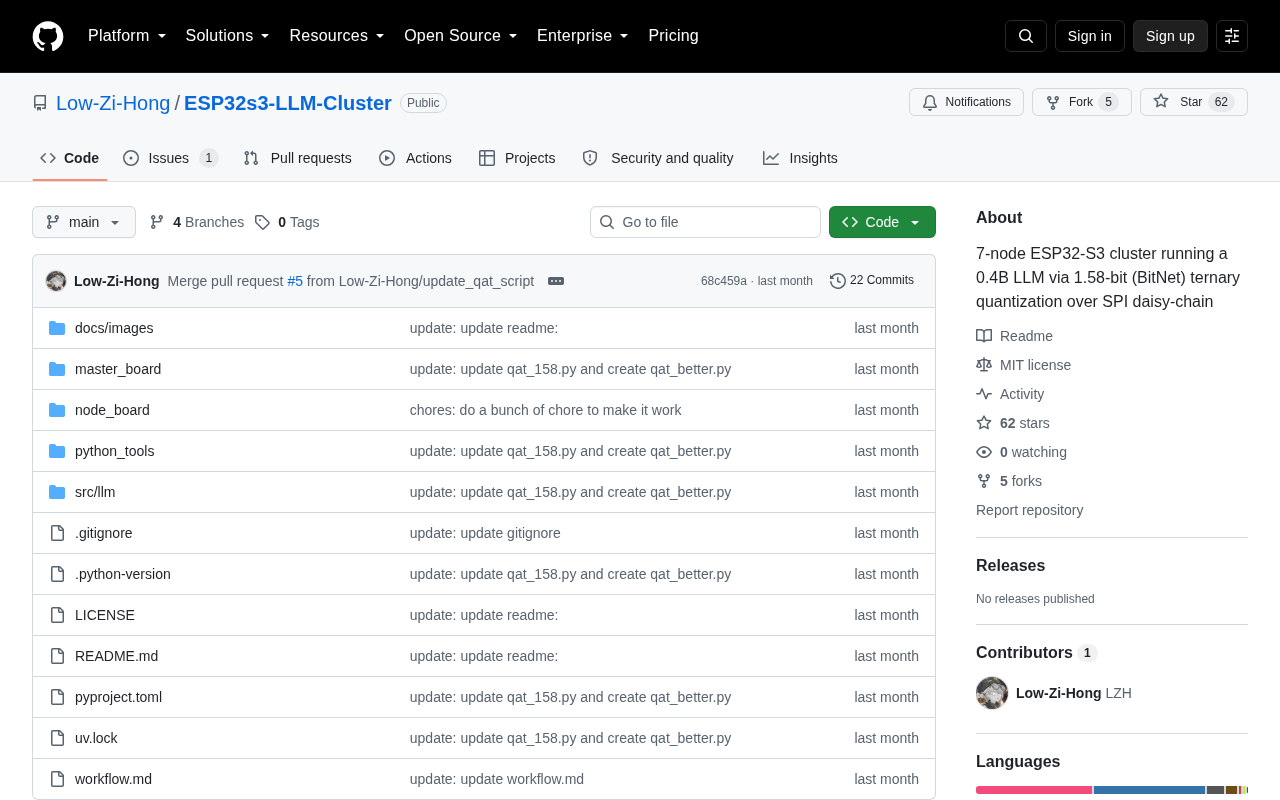
开发者用ESP32S3微控制器集群运行1.58位BitNet量化语言模型,探索边缘AI的硬件极限。
一个开发者项目将1.58位BitNet量化语言模型部署在由廉价ESP32S3微控制器组成的集群上,挑战了人们对AI推理硬件门槛的固有认知。BitNet通过将神经网络权重限制为-1、0、+1三种离散值,将内存占用压缩至传统16位浮点的约十分之一,并将矩阵乘法简化为加减运算,使极低算力的芯片也能完成推理。由于单颗ESP32S3内存仅有数MB,项目采用多芯片集群的流水线并行方式分摊模型计算,但同时面临芯片间通信带宽受限、延迟累积等分布式推理挑战。这一概念验证的意义不在于替代云端大模型,而在于拓展了离线、低功耗、低成本AI部署的边界,为无需联网的智能传感、本地隐私处理等场景提供了新的可能性。
当大语言模型遇上微控制器
在人们习惯于把大语言模型部署在配备高端GPU的数据中心时,一个来自开发者社区的项目提出了完全相反的思路:用一组廉价的ESP32S3微控制器组成集群,运行1.58位(BitNet)量化的语言模型。这个想法乍看之下几乎不可思议——ESP32S3是一款主要用于物联网、可穿戴设备和嵌入式控制的低功耗芯片,其算力与内存与运行现代神经网络的需求相去甚远。但正是这种反差,让这个项目具备了独特的实验价值。
该项目在Hacker News上被分享,虽然讨论热度尚处早期阶段,但它触及了当下AI领域一个愈发重要的命题:如何把模型压缩到极致,让智能真正下沉到边缘设备。
ESP32S3是乐鑫科技(Espressif)推出的微控制器,内置双核Xtensa LX7处理器,主频最高240MHz,并集成了用于神经网络加速的向量指令扩展(PIE,Processor Instruction Extensions)。其片上SRAM通常为512KB,但可通过SPI接口外挂PSRAM扩展至8MB甚至16MB。相比之前广泛使用的ESP32,S3系列专门针对AI推理场景做了指令集增强,能够更高效地执行8位整数矩阵运算。即便如此,与运行大语言模型动辄需要数GB显存的GPU相比,这些规格仍然极为有限。正是这种硬件规格与任务需求之间的数量级差距,使得极端量化(如BitNet)成为在此类设备上运行语言模型的必要前提,而非可选优化。
什么是1.58位的BitNet
BitNet是近年来备受关注的一类极端量化方案。传统神经网络的权重通常以16位或32位浮点数存储,而BitNet将权重限制在极少数几个离散值上。所谓的"1.58位",指的是每个权重只取 -1、0、+1 三种状态(三值量化),从信息论角度计算,log₂(3) ≈ 1.58 比特,这也是这个名字的由来。
为什么三值量化如此关键
将权重压缩到三值带来两个决定性的好处。其一是内存占用的大幅下降——相比16位浮点,理论上可以节省约十倍的存储空间,这对内存以KB或几MB计的微控制器至关重要。其二是计算的简化:当权重只有 -1、0、+1 时,矩阵乘法中的大量浮点乘法可以退化为加法和减法,甚至直接跳过零权重,从而在没有专用浮点单元的芯片上也能获得可观的推理效率。
这正是BitNet被视为"为边缘设备而生"的量化范式的原因。它不是简单地把大模型塞进小设备,而是从模型架构层面重新设计了计算方式。
值得补充的是,BitNet并非仅仅是在训练后对普通模型做量化压缩,而是需要从训练阶段就引入三值约束——即所谓的"量化感知训练"(Quantization-Aware Training, QAT)。这意味着模型在反向传播更新权重时,就已经在三值空间内进行,而非先训练出高精度权重再事后截断。这一区别至关重要:事后量化到如此极端的精度会导致模型精度大幅崩塌,而从头以BitNet方式训练的模型则能在更小的参数规模下维持相对可用的语言能力。微软研究院发布的BitNet b1.58系列论文显示,在同等参数量下,1.58位模型的困惑度(perplexity)已经可以接近全精度模型,这为在资源受限设备上部署真正"能用"的语言模型提供了理论依据。
ESP32S3集群的意义
ESP32S3单颗芯片的资源极其有限,通常配备双核处理器、几百KB的SRAM以及外挂的PSRAM。单靠一颗芯片运行一个哪怕经过极端量化的语言模型,也会很快撞上内存与算力的天花板。项目采用"集群"的方式,意味着将模型的不同层或不同部分的计算任务分摊到多颗ESP32S3上,通过芯片间通信协同完成一次完整的推理。
分布式推理的挑战
在微控制器集群上做分布式推理并不轻松。芯片之间的通信带宽和延迟远不能与数据中心的高速互联相比,模型切分策略、中间激活值的传输、以及各节点间的同步都会成为性能瓶颈。这个项目的价值恰恰在于验证了一种可能性:即便在如此受限的硬件条件下,通过合理的模型量化与任务划分,语言模型的推理依然可以"跑起来"。
它更像是一次概念验证(proof of concept),展示了极端量化技术与分布式计算结合后所能触达的硬件下限。
微控制器集群中最常见的分布策略是"流水线并行"(Pipeline Parallelism):将Transformer模型按层切分,每颗ESP32S3负责若干连续层的计算,前一颗芯片完成计算后将激活值(activation)传给下一颗,形成流水线。这与数据中心GPU集群的张量并行不同,后者需要极高的互联带宽才能高效切分单层的矩阵运算。流水线并行对芯片间带宽要求相对较低,但代价是每处理一个token都要经历完整的端到端等待,推理延迟会随节点数线性叠加。ESP32S3常用的芯片间通信方式包括SPI、I2C或UART,其带宽通常在数Mbps量级,这使得激活值的传输成为整个系统吞吐量的核心瓶颈之一。
边缘AI的想象空间
这类实验的现实意义,并不在于ESP32S3集群能取代云端大模型,而在于它拓展了AI部署的边界。当模型可以在完全离线、低功耗、成本极低的硬件上运行时,一系列新的应用场景才成为可能:无需联网的智能传感设备、隐私敏感的本地语音处理、以及在网络不可达环境中的自主决策系统。
从技术演进的角度看,BitNet这类极端量化方案与专用低功耗芯片的结合,正在把"智能无处不在"的愿景往前推进一步。虽然目前的成果仍属于爱好者与研究者的探索范畴,但这种自下而上的创新往往会催生意想不到的工程突破。
结语
ESP32S3运行BitNet模型的尝试,本质上是在回答一个问题:智能的最小硬件成本究竟能压到多低。它把两个原本不搭界的领域——极端模型量化与嵌入式微控制器——拼接在一起,用一种近乎极客的方式测试着边缘AI的物理极限。尽管项目仍在早期,讨论也尚未充分展开,但它所代表的方向值得持续关注:当模型足够小、足够高效,AI才可能真正渗透进每一个微小的设备之中。
相关推荐

n8n入门实战:从零搭建你的第一个AI工作流
n8n入门实战教程:从自动化基本概念讲起,一步步教你用n8n搭建第一个AI工作流,连接Gemini模型,实现自动智能回复。涵盖节点、触发器、API Key配置、系统提示词等核心知识,适合零基础学习者。

AI自动修复生产崩溃:n8n+Dify打造自愈运维流水线
一个生产环境崩溃的真实案例:如何用 n8n 工作流、Dify AI 调试代理和 ChatGPT 构建自愈式运维流水线,自动捕获错误、修复代码并重新部署。附技术栈拆解与落地风险分析。

Anthropic向警方举报日记内容:AI隐私边界引发争议
Anthropic被曝将用户日记内容上报警方,导致一名女性面临重罪指控,在Hacker News引发热议。本文探讨AI隐私边界、服务商举报义务与用户信任之间的深层矛盾。